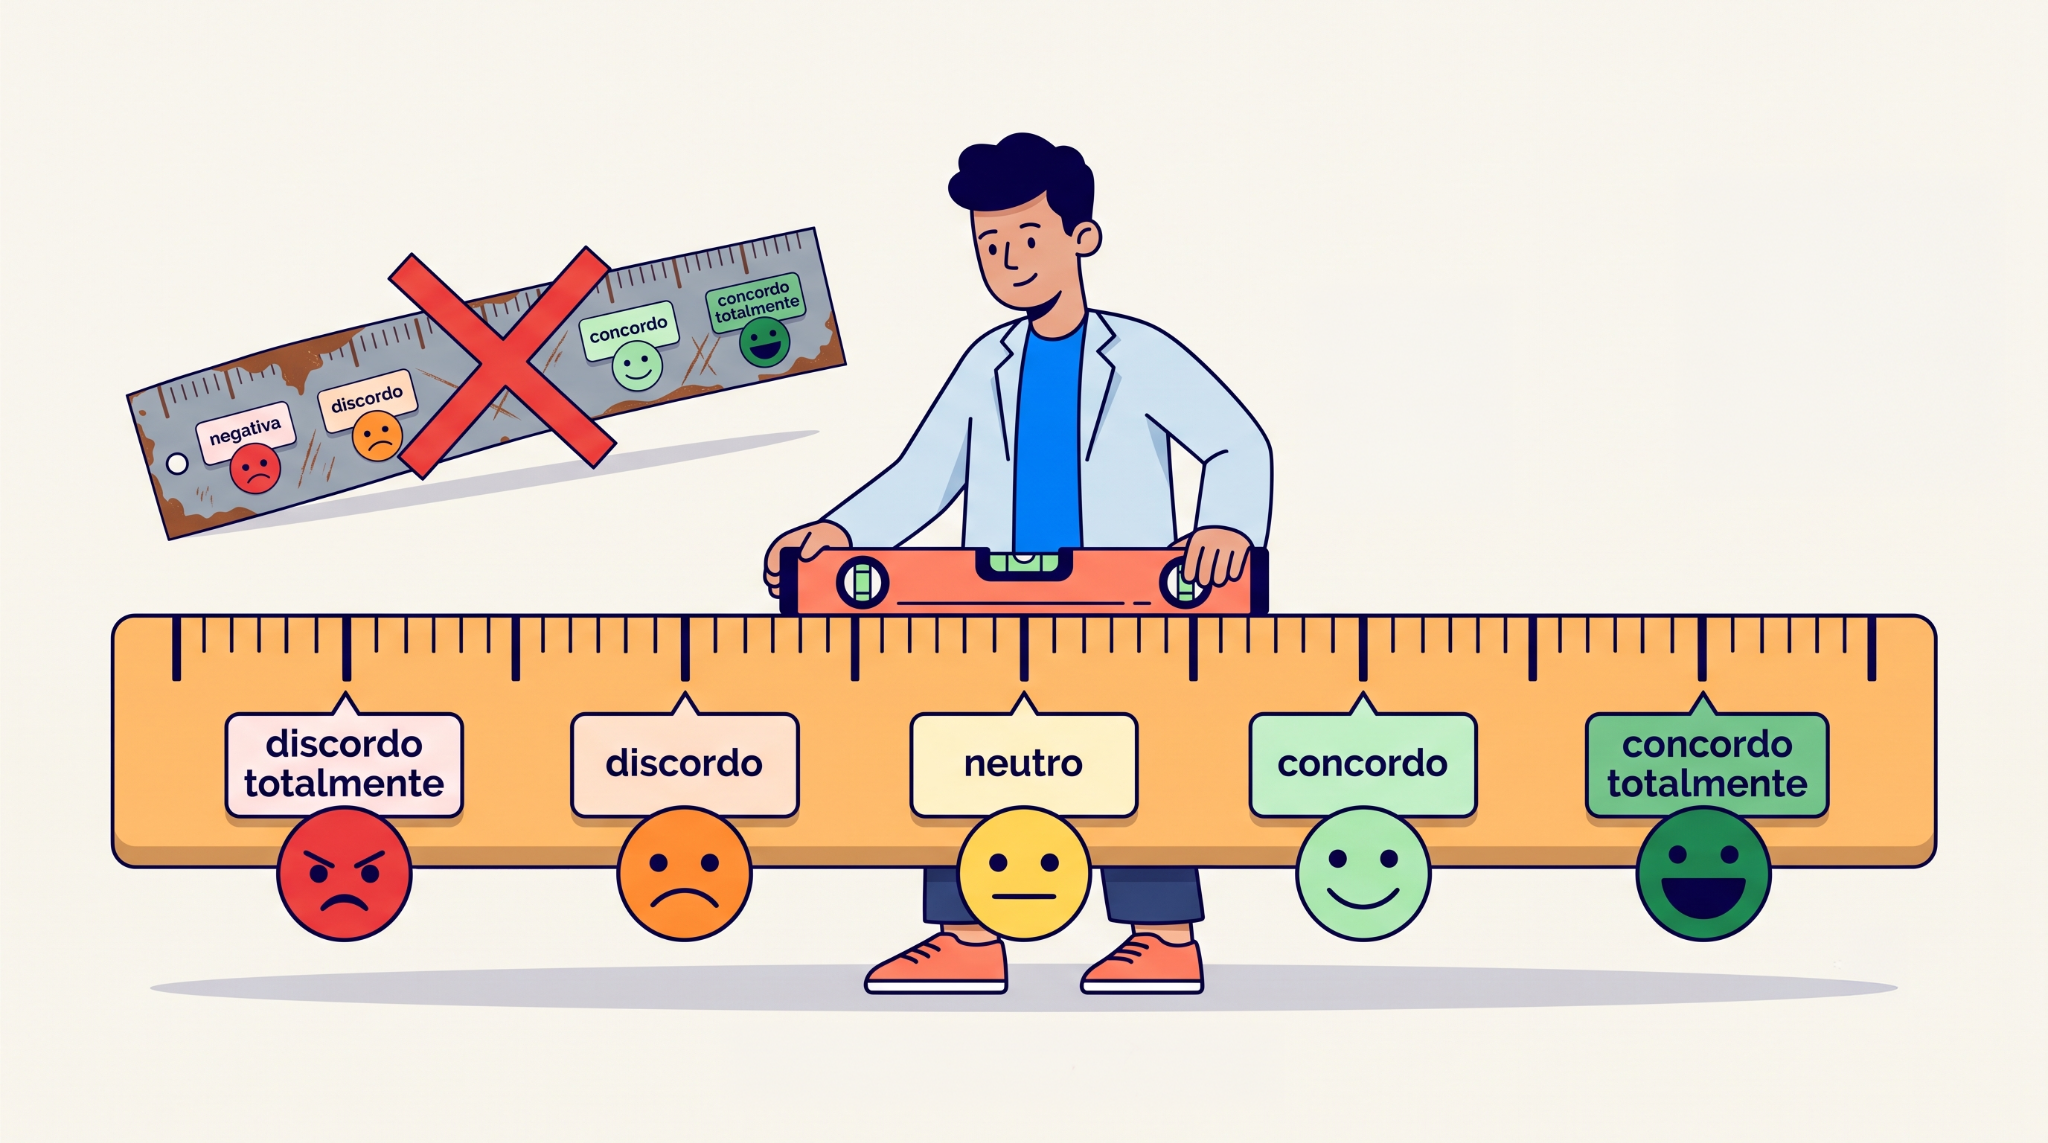
"Concordo totalmente" que você já respondeu uma escala Likert, mas montar uma boa é outra história. Nas Lojas Andorinha O RH das Lojas Andorinha, rede de moda com trinta lojas, lançou sua primeira pesquisa de clima com orgulho e uma escala desenhada em casa: quatro pontos, "para forçar posição", com os rótulos "ruim", "bom", "muito bom" e "excepcional". O resultado saiu cor-de-rosa: 91% do time entre "bom" e "excepcional", slide comemorativo pronto. A analista de dados da rede leu a escala antes de ler o resultado, e pediu para segurarem o slide. Três opções positivas contra uma negativa; nenhum meio honesto para quem estava "nem bem, nem mal"; e o degrau entre "ruim" e "bom" engolindo, num salto só, todo mundo que estava apenas insatisfeito, sem estar revoltado. A pesquisa não tinha medido o clima da rede. Tinha medido o clima da régua, e a régua nascera sorridente. A escala Likert: o problema que um psicólogo resolveu em 1932 Como se mede uma opinião? Um termômetro mede temperatura, uma balança mede peso, mas não existe aparelho que se aponte para uma pessoa e leia "satisfação: 7,3". Em 1932, o psicólogo americano Rensis Likert propôs, em sua tese de doutorado, uma solução tão simples que parece óbvia hoje: apresentar uma afirmação e pedir que a pessoa marque seu grau de concordância numa régua simétrica: "O atendimento da loja resolve meus problemas rapidamente."( ) Discordo totalmente ( ) Discordo ( ) Neutro ( ) Concordo ( ) Concordo totalmente Noventa anos depois, a escala Likert é o instrumento mais usado da pesquisa de opinião mundial, e um dos mais maltratados. Este artigo ensina a montar uma corretamente e a ler os resultados sem se enganar. A anatomia de uma Likert bem-feita 1. É uma afirmação, não uma pergunta.A escala mede reação a uma frase. "Como você avalia o atendimento?" com opções de "péssimo" a "ótimo" é uma escala de avaliação (rating): legítima, mas não é Likert. A distinção importa menos pelo nome e mais pela disciplina: a afirmação precisa ser clara, única e afirmável, e todas as regras de uma boa pergunta valem em dobro aqui. Afirmação dupla ("o atendimento é rápido e cordial") quebra a escala inteira. 2. Simetria: o mesmo número de degraus para cada lado.Duas opções positivas e duas negativas, com o neutro no centro. A pesquisa metodológica (resumida por Jon Krosnick, de Stanford, um dos maiores estudiosos de questionários) mostra que escalas desequilibradas empurram a resposta, e produzem aquele resultado suspeito de "94% de aprovação". 3. Todos os pontos rotulados.Krosnick e Fabrigar também documentaram que escalas com rótulos verbais em todos os pontos (e não só nas pontas) são mais confiáveis: as pessoas interpretam os degraus de forma mais parecida entre si. Números soltos (1 a 5, sem palavras) deixam cada respondente inventar sua própria régua. 4. Cinco ou sete pontos, e pronto.Décadas de estudos convergem: abaixo de 5 pontos perde-se sensibilidade; acima de 7, as pessoas não distinguem os degraus ("concordo moderadamente" vs. "concordo consideravelmente"?) e a qualidade não melhora. No contexto de coleta no ponto de venda (respondente em pé, no totem, com segundos de atenção), 5 pontos é o padrão sensato. 5. O dilema do ponto neutro.Com neutro, quem não tem opinião tem saída honesta. Sem neutro (escala de 4 ou 6), força-se a escolha de um lado. Não há resposta única: escalas pares evitam a "preguiça do meio" (marcar neutro para não pensar), mas fabricam opiniões de quem realmente não tem uma; e fabricar dado é pior que perder dado. A recomendação mais segura é manter o neutro, e quando a taxa de neutros for alta, tratar isso como informação ("os clientes não notaram esse aspecto") em vez de estorvo. Os três pecados na hora de analisar Montar bem é metade; a outra metade é ler direito. Pecado 1: tirar média como se fossem números de verdade.Os degraus da Likert são ordenados, mas não necessariamente equidistantes: a distância psicológica entre "concordo" e "concordo totalmente" pode não ser igual à distância entre "neutro" e "concordo". Tecnicamente, é uma escala ordinal, e há um debate metodológico honesto, com décadas de idas e vindas, sobre quando é aceitável tratá-la como numérica. A regra prática mais segura: média de um único item Likert é atalho arriscado; distribuição é sempre verdade. Reportar "72% concordam ou concordam totalmente; 11% discordam" comunica mais e engana menos do que "média 3,9" (a média esconde os extremos). Pecado 2: ignorar o estilo de resposta.Escalas de concordância sofrem de um viés conhecido: a aquiescência: a tendência humana de concordar com afirmações, qualquer afirmação. Parte dos "concordo" é pura gentileza. Antídotos: afirmações formuladas com neutralidade e, em questionários mais longos, alternar afirmações positivas e negativas para detectar quem concorda com tudo em linha reta (straightlining). Pecado 3: comparar escalas diferentes como se fossem iguais.A nota 4 numa escala de 5 não equivale a 8 numa escala de 10, nem o "concordo" de uma escala rotulada equivale ao "4" de uma escala numérica. Conversões de escala existem, mas são aproximações com perda. Regra de ouro para quem muda de questionário: mudou a escala, quebrou a série histórica: anote a data da mudança e compare com cuidado dali em diante. Likert no ponto de venda No ponto de venda, a escala Likert costuma aparecer em forma de perguntas de múltipla escolha, ou traduzida em linguagem visual: carinhas, estrelas, botões coloridos. A ciência é a mesma; os cuidados também: E um lembrete de humildade metodológica: a carinha mede a reação global daquele momento com altíssima taxa de resposta — essa é sua força. Para diagnóstico fino ("o problema é limpeza ou espera?"), ela precisa das perguntas específicas que vêm depois. Instrumento certo para cada trabalho. De volta à Andorinha Na Andorinha, a pesquisa de clima voltou a campo com uma régua honesta: cinco pontos simétricos, dois negativos, um meio de verdade, dois positivos, todos com rótulo. O retrato mudou: os 91% de céu azul viraram 63% de satisfeitos, 23% em cima do muro e 14% de insatisfeitos
A ética de quem pergunta: privacidade, honestidade e responsabilidade com dados
O cliente confiou a opinião dele a quem pergunta. E agora? É aqui que entra a ética de dados. Na Clínica Aurora Foi um dia de dois pedidos na Clínica Aurora, rede de clínicas médicas. De manhã, o coordenador da unidade em reforma mandou mensagem para Wagner, o administrador: "as notas desta semana despencaram por causa da obra; dá pra apagar essas respostas? Não é justo contar". À tarde, um parceiro comercial pediu "a lista de telefones dos pacientes que avaliaram bem", para oferecer um plano odontológico. Os dois pedidos eram razoáveis à primeira vista. Os dois vinham de gente boa, querendo o melhor para a casa. E aqui o dado tinha um peso a mais: era dado de paciente. Wagner levou os dois para a Dra. Beatriz, a sócia fundadora, na mesma conversa: — Um quer apagar dado que dói. O outro quer usar dado que não foi emprestado para isso. Eu nego os dois? O ativo invisível Toda vez que alguém toca uma carinha num totem, acontece uma pequena transação de confiança: o cliente entrega uma opinião (às vezes um desabafo, às vezes dados pessoais), apostando que será feito bom uso dela. Confiança é o ativo invisível de qualquer negócio que vive de perguntar. Invisível e assimétrico: leva anos para construir e pode ser perdida num único episódio. Uma série sobre pensar cientificamente precisa terminar aqui, porque rigor sem ética é só eficiência a serviço de qualquer coisa. Este artigo cobre os dois compromissos de quem vive de perguntar: cuidar do dado (a parte da lei) e não mentir com ele (a parte que nenhuma lei fiscaliza). Ética de dados, parte 1: a LGPD traduzida para o dia a dia A Lei Geral de Proteção de Dados (Lei nº 13.709/2018) regula o tratamento de dados pessoais no Brasil desde 2020, sob fiscalização da ANPD (Autoridade Nacional de Proteção de Dados). Mais do que um manual de proibições, ela é um princípio central com desdobramentos: o dado pessoal pertence ao titular; quem coleta é guardião temporário, com finalidade definida. O vocabulário mínimo que qualquer equipe que lida com dados de pesquisa deveria dominar: Dado pessoal é qualquer informação que identifique ou possa identificar uma pessoa: nome, e-mail, CPF, telefone, mas também combinações que identifiquem indiretamente. E os dados pessoais sensíveis são aqueles que, quando revelados, podem gerar algum tipo de discriminação, como raça, religião, orientação sexual ou política. Dado anonimizado, aquele que perdeu de forma irreversível o vínculo com a pessoa, está fora do alcance da lei. A nota "4 estrelas às 14h32" solta não identifica ninguém; associada ao CPF do programa de fidelidade, é dado pessoal e exige todo o cuidado da lei. Finalidade: dado coletado para um propósito informado só pode ser usado para aquele propósito. O e-mail coletado "para enviarmos a resolução do seu problema" não pode virar lista de marketing, a menos que isso tenha sido informado e consentido. Minimização: coletar apenas o necessário. Cada campo a mais num questionário não é só atrito de resposta; é passivo jurídico e ético. "Pode ser útil um dia" não é finalidade. Direitos do titular: a pessoa pode saber o que existe sobre ela, corrigir, e pedir eliminação do que foi coletado com base em consentimento. Se um respondente aciona esses direitos, precisa existir processo: a resposta certa do atendimento é acionar o responsável interno, nunca improvisar. Segurança e incidentes: vazamento de dados pessoais é incidente com obrigações legais de comunicação à ANPD e aos titulares em prazos definidos. A regra de ouro preventiva: dado pessoal não passeia: não vai em planilha por e-mail, não vai em print de WhatsApp, não vai em slide de apresentação com nome de cliente visível. Há uma camada extra para quem, como fornecedor de pesquisa, processa dados dos clientes de outra empresa. Na linguagem da lei, esse fornecedor costuma ser operador, processando dados sob instruções do controlador (o cliente contratante). Cada descuido nessa cadeia compromete a confiança de duas relações ao mesmo tempo. Parte 2: A honestidade com resultados (a parte que a lei não cobre) Nenhum artigo da LGPD proíbe "maquiar" um resultado de pesquisa. Essa parte é uma questão de ofício. Não caçar nota. Pressionar o cliente por um 10, escolher o momento da pergunta para inflar o placar, dificultar a resposta negativa: tudo isso produz um número bonito que mede a maquiagem, não a experiência. É a Lei de Goodhart operando pela via da tentação. Quem engana a métrica engana o gestor que decide por ela, e no limite engana a si mesmo (Feynman, sempre: você é a pessoa mais fácil de enganar). Não esconder o recorte inconveniente. Apresentar o trimestre bom e omitir o mês ruim, mostrar a média e esconder a distribuição, citar "os dados" sem mostrar a amostra: cada uma dessas escolhas é uma pequena fraude estatística socialmente aceita. O padrão saudável é outro: o dado que enfraquece a história vai junto. Não afirmar além do que o dado sustenta. "O NPS subiu" quando a variação está dentro da margem de erro; "a campanha causou o aumento" quando há só correlação. O vocabulário honesto existe e não é fraqueza: "os dados sugerem", "ainda não dá para separar do efeito da promoção", "a amostra é pequena para afirmar". Precisão sobre incerteza é sinal de sofisticação. Resultado ruim se entrega com o mesmo capricho do bom. Se um cliente tem um NPS em queda, o relatório não deveria suavizar: precisa contextualizar, diagnosticar e apontar caminho. Quem pesquisa é contratado para dizer a verdade útil, não a verdade agradável. É exatamente por isso que a palavra de quem entrega o resultado vale alguma coisa. Essa postura tem tradição: os códigos de ética das associações internacionais de pesquisa (como o Código ICC/ESOMAR, adotado em dezenas de países) estabelecem há décadas os mesmos pilares: voluntariedade do respondente, transparência de propósito, proteção do dado e obrigação de não distorcer ou deturpar resultados. São princípios de um ofício centenário — quem os segue está apenas se filiando a uma tradição bem estabelecida.
O ciclo fechado: pesquisa que não vira ação é desperdício
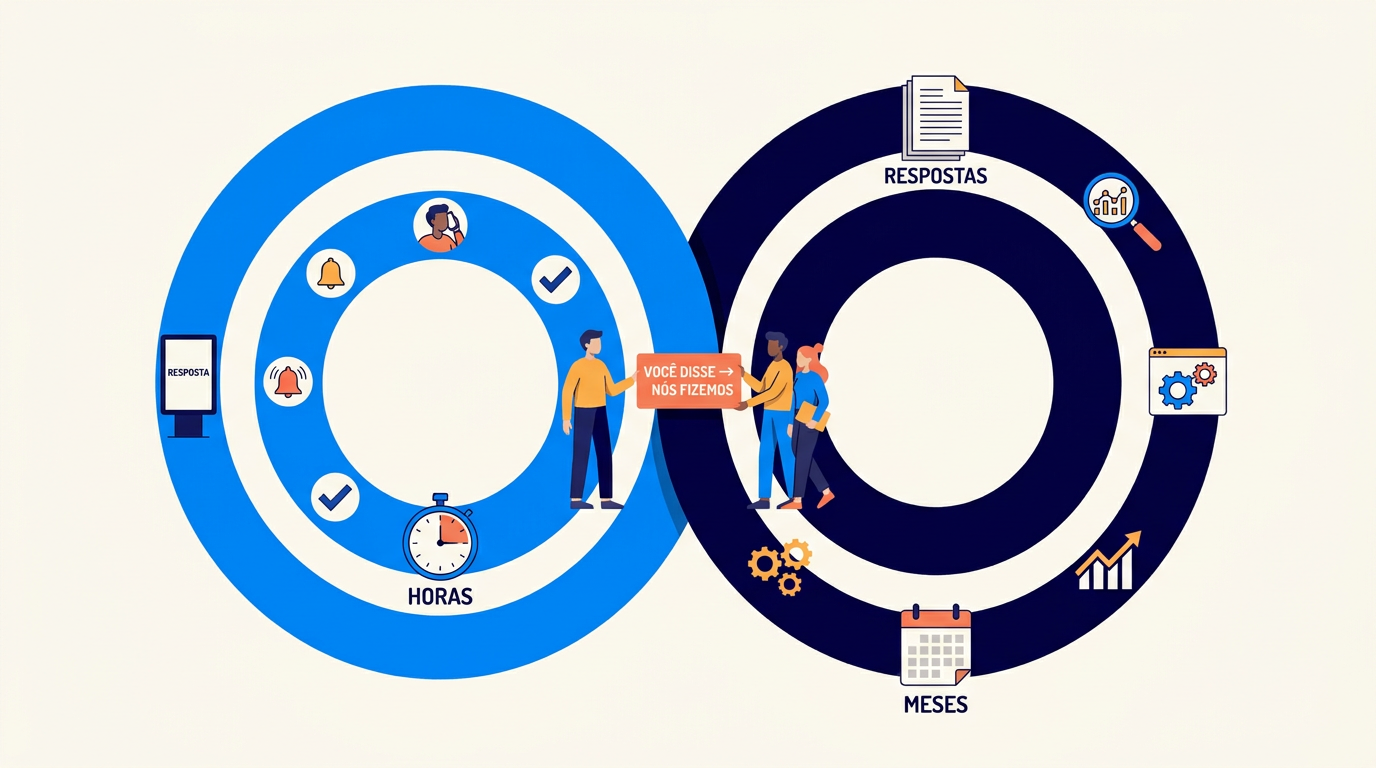
Perguntar e não agir é pior do que não perguntar: sem ciclo fechado, a pesquisa vira teatro. No Hotel Cambará Na triagem mensal de respostas do Hotel Cambará, Luana, a chefe de recepção, tropeçou numa avaliação de hóspede com duas semanas de idade: “Chuveiro frio no 204. Avisei na recepção na hora, ninguém resolveu. Nota 2.” O hóspede era corporativo, vinha recorrentemente pela mesma empresa. E o sistema mostrava o que ela temia: desde a resposta, as reservas dele passaram a cair no hotel concorrente. — Quem respondeu esse caso? — perguntou a Otávio, o gerente-geral. Otávio rolou a tela do sistema e não encontrou o que procurava. — Ninguém. A gente até comentou aqui… mas era semana de congresso, ficou para depois. O “depois” já durava catorze dias. O chuveiro do 204, ninguém sabia dizer se ainda saía frio. E a pergunta ficou pairando sobre o balcão da recepção: se responder não muda nada, por que o hóspede responderia de novo? O ciclo fechado começa com a promessa implícita de toda pergunta Quando uma empresa pergunta “como foi sua experiência?”, ela faz uma promessa silenciosa ao cliente: sua resposta vai servir para alguma coisa. Agora imagine o cliente que responde, aponta um problema real, dá detalhes… e nada muda. Na visita seguinte, a mesma fila, o mesmo banheiro, o mesmo caixa quebrado. O que ele aprende? Que responder é inútil. Pior: que a empresa pergunta por teatro. A literatura de experiência do cliente tem nome para isso: quebra de expectativa de feedback. E a consequência prática é mensurável: clientes que percebem que o feedback é ignorado param de responder (degradando a amostra) e ficam mais insatisfeitos do que se nunca tivessem sido perguntados. Perguntar e engavetar sai caro: é um investimento em frustração. Daí o princípio que dá título a este artigo, popularizado pela Bain & Company dentro do Net Promoter System: fechar o ciclo (closing the loop): garantir que cada resposta relevante percorra o caminho de volta, da escuta à ação e da ação de volta ao cliente. Os dois ciclos (e por que confundi-los custa caro) O sistema de ciclo fechado opera em duas engrenagens de tamanhos diferentes: O ciclo interno (inner loop): resposta → resposta rápida É o circuito individual, operacional, de horas ou dias: um detrator identificado gera um alerta; alguém responsável entra em contato, ouve, resolve o que for resolvível e registra a causa. Aqui vale conhecer o dado mais citado da área: a pesquisa sobre o paradoxo da recuperação de serviço (service recovery paradox) sugere que um cliente que teve um problema bem resolvido pode terminar mais leal do que um que nunca teve problema algum: o problema resolvido vira prova de que a empresa se importa. As meta-análises (como a de Matos, et all, 2007) mostram que o efeito existe, mas tem condições: funciona para falhas pontuais, bem tratadas e não repetidas. Ninguém perdoa a mesma falha duas vezes. Ou seja: o ciclo interno vai além da gentileza, é uma das alavancas de lealdade mais bem documentadas que existem. Mas só funciona com velocidade e sinceridade. Lembre-se da curva do esquecimento: a janela emocional para recuperar um detrator se fecha rápido, e o contato deve ser para resolver, não para pedir nota melhor. O ciclo externo (outer loop): padrões → mudança estrutural É o circuito coletivo, estratégico, de semanas ou meses: as causas registradas no ciclo interno se acumulam, viram padrões (“31% dos detratores do trimestre citam fila do caixa”), os padrões viram projetos, os projetos mudam o processo, e a mudança é verificada nos dados seguintes. É o método científico completo rodando: observação, hipótese, intervenção, medição. A confusão clássica: empresas que só rodam o ciclo interno enxugam gelo: apagam o mesmo incêndio individual para sempre, sem nunca remover a causa. Empresas que só rodam o externo abandonam clientes na porta: melhoram o processo para os futuros clientes enquanto os detratores de hoje vão embora sem resposta. O sistema completo precisa dos dois. O último elo, que poucos fazem: contar ao cliente Fechar o ciclo termina com um passo simples que a maioria pula: dizer ao cliente o que mudou por causa dele. “Você nos disse que a espera estava longa. Abrimos dois caixas no horário de pico.” Um cartaz na loja, uma mensagem, um aviso no app: o formato importa menos que o gesto. É o que transforma pesquisa de monólogo em conversa, e o que ensina o cliente de que responder vale a pena (a taxa de resposta sobe e a amostra melhora; tudo se conecta). Gestores de CX chamam isso de “you said, we did” (“você disse, nós fizemos”), prática padrão nos programas de voz do cliente mais maduros. E o gesto tem um fundamento que vai além da cortesia. Barry Oshry, estudioso das dinâmicas de poder nas organizações, descreve o cliente como um papel dentro do sistema, com uma contribuição própria a dar: a de validador, aquele que mantém o padrão alto, dá feedback detalhado e permanece envolvido na melhoria. O reflexo natural, porém, é outro: culpar o fornecedor e ir embora. Fechar o ciclo é o mecanismo que interrompe esse reflexo. Quando a resposta gera contato, ação e devolutiva, o cliente deixa de ser o juiz que dá a sentença e vai embora, e passa a ser o parceiro que aponta o conserto e volta para conferir. A pesquisa bem operada é o convite formal para ele ocupar esse papel. O checklist do Close the Loop Para avaliar (ou montar) qualquer programa de escuta: Seis “sims” = programa de verdade. Menos que isso = coleta de dados com boas intenções. Como testar se um programa realmente fecha o ciclo Uma boa forma de testar isso é fazer a pergunta certa: “e o que aconteceu com a última resposta negativa que vocês receberam?” O silêncio que costuma se seguir revela a lacuna: coletar é a metade fácil. O que separa pesquisa de teatro é o encanamento completo — a resposta que vira alerta, o alerta que vira
Experimentos internos: como testar ideias antes de apostar alto
Antes de discutir por 3 reuniões, teste por 3 dias: é a lógica dos experimentos internos. Na Academia Ritmo A pauta “volume da música” chegou à terceira reunião consecutiva na Academia Ritmo, rede de academias com três unidades, com as mesmas duas torcidas e nenhum dado novo. Fábio, o dono, sustentava que música alta é energia: “aluno treina mais, fica mais”. Renata, a gerente, sustentava que o volume espantava o pessoal da manhã e os alunos de mais idade: “e aluno que não gosta não reclama; some”. A ata da reunião anterior podia ser lida em voz alta: era idêntica ao debate em curso. No minuto quarenta, Renata desistiu de vencer e fez a proposta que encerrou o loop: — A gente já gastou três reuniões de opinião. Isso custa mais caro que o teste. Duas unidades com volume menor de manhã, uma como está, duas semanas. A realidade desempata, e ela não cobra hora. A reunião em loop Toda empresa conhece a cena: uma ideia divide o time. Metade acha que vai funcionar, metade acha que não. Argumentos de um lado, argumentos do outro. A reunião acaba sem decisão. Duas semanas depois, a mesma discussão, com os mesmos argumentos, porque nenhuma informação nova entrou na sala. O empate entre opiniões não se resolve com mais opinião. Se resolve com dado novo. E a forma mais barata de fabricar dado novo tem nome: experimento. A proposta deste artigo é mostrar como aplicar, no dia a dia de qualquer equipe, o mesmo método científico que sustenta uma boa pesquisa de satisfação: testar antes de apostar alto. A regra de ouro dos experimentos internos: aposte pequeno A lógica do experimento interno é economia pura: qual é o jeito mais barato e rápido de descobrir se essa ideia funciona? Essa filosofia tem lastro: é o núcleo do movimento Lean Startup, de Eric Ries (construir o teste mínimo, medir, aprender, e só então escalar), e é prática consolidada nas empresas de tecnologia mais estudadas do mundo. O motivo é um dado humilhante e libertador que essas empresas divulgam: a maioria das ideias testadas falha em produzir o efeito esperado. Ron Kohavi, que liderou experimentação na Microsoft, relata que só cerca de um terço das ideias testadas por lá melhorava de fato as métricas que pretendia melhorar; um terço não fazia diferença e um terço piorava. E eram ideias propostas por especialistas. Se especialistas erram dois terços dos palpites, a conclusão não é “não tenha ideias”; é “não aposte alto em palpite não testado”. A ficha de experimento: 5 campos antes de começar Um experimento se diferencia de “vamos tentar e ver no que dá” por um detalhe: as regras são definidas antes. Sem isso, o viés de confirmação redige a conclusão depois: qualquer resultado vira “deu certo”. A ficha mínima: Cinco campos, meia página. O custo de preenchê-la é 20 minutos; o custo de não preenchê-la é descobrir em produção, seis meses depois, que a aposta era ruim. Ou, tão ruim quanto: nunca descobrir. As armadilhas de quem começa Testar tudo ao mesmo tempo. Mudou o preço, o texto e o público na mesma semana? Se melhorar, foi o quê? Uma variável por experimento, ou aceite que só saberá o efeito do pacote. Escolher a métrica depois. Com liberdade para escolher a métrica após o resultado, alguma sempre terá subido. É a versão corporativa do atirador que desenha o alvo em volta do tiro. Encerrar quando está ganhando. Definiu duas semanas? São duas semanas. Parar no dia em que o número está bonito é colher ruído, não sinal (lembre-se da margem de erro: números pequenos balançam). Ignorar o contexto. O teste rodou na semana de promoção? Na baixa temporada? Anote junto ao resultado. Experimento interno raramente tem a pureza de laboratório; honestidade sobre as condições vale mais que fingir rigor. Confundir “falhou” com “fracassou”. A hipótese derrubada por um teste de 3 dias e R$ 0 é um dos produtos mais valiosos que existem: uma aposta ruim cancelada pelo preço de um palpite. No placar científico, “aprendemos que não” é vitória. Como isso conversa com a priorização de iniciativas Isso conversa direto com frameworks de priorização de iniciativas como o ICE score (impacto, confiança e esforço, popularizado por Sean Ellis): o experimento é o que alimenta o “C” de confiança. Uma iniciativa com hipótese testada em pequena escala sobe de confiança com dado em vez de retórica. O ciclo ideal: ideia → ficha de iniciativa → experimento pequeno → resultado → decisão de escalar (ou arquivar), com o aprendizado registrado para o time inteiro, inclusive quando a resposta é “não”. De volta à Ritmo Na Ritmo, a ficha de experimento saiu preenchida antes do café esfriar: hipótese (volume menor de manhã aumenta frequência e nota do turno), unidades pareadas, duas semanas, critérios combinados de antemão. Catorze dias depois, a realidade votou: a tarde não mudou nada, e a manhã surpreendeu: check-ins 9% maiores nas unidades de volume reduzido, com comentários novos do tipo “finalmente dá para conversar com o professor”. Fábio aceitou a derrota com a elegância de quem perdeu para o método, não para a Renata. A regra ficou na parede da sala: “terceira reunião sobre o mesmo empate é proibida; no lugar dela, marca-se o teste”. O resumo de uma frase (teste Feynman) “Empate de opinião não se desempata com voz mais alta; se desempata com um teste pequeno, combinado antes, que deixe a realidade dar o voto de minerva.” Fontes e leituras recomendadas RIES, Eric. A Startup Enxuta. Sextante, 2019. KOHAVI, Ron; TANG, Diane; XU, Ya. Trustworthy Online Controlled Experiments: A Practical Guide to A/B Testing. Cambridge University Press, 2020. THOMKE, Stefan. Experimentation Works: The Surprising Power of Business Experiments. Harvard Business Review Press, 2020. ELLIS, Sean; BROWN, Morgan. Hacking Growth. HarperCollins, 2017. (Origem prática do ICE score.) KOHAVI, Ron; CROOK, Thomas; LONGBOTHAM, Roger. “Online Experimentation at Microsoft”. Third Workshop on Data Mining Case Studies, 2009. (Fonte do dado “um terço melhora, um terço não muda, um terço piora”.)
O momento da verdade: Por que pesquisar na hora certa muda tudo
status: publish A memória do cliente tem prazo de validade. Um experimento mental sobre o momento da verdade Sexta-feira, você almoçou num restaurante novo. A comida veio rápida, o tempero estava certo, mas o garçom esqueceu sua bebida e você precisou pedir duas vezes. Cenário A: na saída, um totem pergunta: “Como foi sua experiência hoje?” Cenário B: na terça-feira seguinte, chega um e-mail: “Como foi sua experiência no último dia 3?” Mesma pessoa, mesmo almoço. As respostas serão iguais? A ciência da memória diz que não. E a diferença entre esses dois cenários é, nada modestamente, o fundamento científico do produto da Solvis. Este artigo explica o porquê. Fato 1: a memória apaga rápido, e começa pelos detalhes Em 1885, o psicólogo alemão Hermann Ebbinghaus publicou o primeiro estudo experimental da memória humana e desenhou a curva que leva seu nome: a curva do esquecimento. O achado central, replicado muitas vezes desde então (inclusive numa reprodução direta publicada por Murre e Dros em 2015): o esquecimento é brutalmente rápido no início (boa parte do que aprendemos se perde nas primeiras horas e dias) e depois desacelera. Para a pesquisa de satisfação, a consequência é direta: os detalhes da experiência (a bebida esquecida, o sorriso da atendente, os minutos de fila) são as primeiras vítimas do esquecimento. Dias depois, sobra uma impressão geral desbotada. E detalhe é justamente o que o gestor precisa para agir. Fato 2: o que sobra não é uma gravação, é uma reconstrução Pior do que esquecer: a memória edita. Quando lembramos de algo, não apertamos “play” numa gravação; nós reconstruímos a cena, e a reconstrução é influenciada pelo nosso humor de hoje, por conversas que tivemos depois, pelo que aconteceu em visitas seguintes. Os experimentos de Elizabeth Loftus (citados no artigo sobre perguntas) mostraram que até a redação de uma pergunta altera o que a pessoa “lembra” ter visto. O psicólogo Daniel Kahneman deu nomes a essa divisão: existe o eu que vivencia (experiencing self), que sente a experiência minuto a minuto, e o eu que lembra (remembering self), que conta a história depois, e os dois frequentemente discordam. A pesquisa de Kahneman e colegas identificou inclusive uma regra da edição: a regra do pico-fim (peak-end rule): a memória de uma experiência é dominada pelo momento mais intenso e pelo final, não pela média do todo. Num estudo clássico com pacientes de colonoscopia (Redelmeier e Kahneman, 1996), a lembrança da dor dependia muito mais do pico e dos minutos finais do que da duração total do desconforto. Tradução para o varejo: dias depois, o cliente não lembra mais da experiência em si, e sim de um resumo editado dela. A resposta dada 3 dias depois não é simplesmente a mesma resposta com atraso: é outra resposta, sobre a experiência reconstruída. Fato 3: quem responde dias depois não é todo mundo Além de o que se responde, o tempo muda quem responde. O e-mail de pesquisa enviado dias depois é respondido por uma minoria, tipicamente os extremos: o encantado e o furioso, que têm motivação para gastar tempo. O grande meio silencioso (a maioria dos clientes, cuja opinião define o rumo do negócio) simplesmente não abre o e-mail. É o viés de sobrevivência aplicado à pesquisa (o manual dos vieses) somado à auto-seleção (o caso Literary Digest, citado no artigo sobre amostra). No momento da experiência, no ponto de venda, a barreira de resposta é mínima (dois toques na saída) e todo perfil de cliente está ali: o apressado, o indiferente, o satisfeito-sem-drama. Pesquisar na hora não melhora só a memória da resposta: melhora também a amostra inteira. Juntando os três fatos Na hora (totem) Dias depois (e-mail) Memória Fresca, rica em detalhes Desbotada, sem detalhes Conteúdo A experiência vivida Um resumo editado (pico e fim) Quem responde Todos os perfis presentes Extremos motivados Serve para Diagnóstico e ação Visão geral tardia Uma nuance honesta (porque método científico exige honestidade): a resposta tardia não é “inútil”. O eu que lembra é quem decide se o cliente volta e o que ele conta aos amigos; medir a memória consolidada tem seu valor para estudos de marca. Mas para o gestor que precisa saber o que consertar na operação, esta semana, a resposta fresca, detalhada e representativa é incomparavelmente mais útil. E se a regra do pico-fim governa a lembrança, o fim da visita (exatamente onde está o totem) é também o último momento em que a loja ainda pode influenciar a história que o cliente vai contar. O que isso muda na prática Na prática, isso muda como qualquer empresa deveria desenhar sua estratégia de escuta. “Pesquisar dias depois mede outra coisa” não é um slogan: a frase resume mais de um século de pesquisa, de Ebbinghaus a Kahneman. É também a explicação para uma pergunta comum: por que a nota coletada na hora, no ponto de venda, costuma diferir da nota de uma pesquisa por e-mail enviada dias depois? Não é erro de nenhuma das duas — são instrumentos medindo coisas diferentes: a experiência vivida contra a memória editada, o público inteiro contra os extremos motivados a responder. Há também uma implicação de desenho: cada segundo a mais entre a experiência e a pergunta degrada o dado. A fluidez do fluxo de resposta não é uma questão estética — afeta diretamente a qualidade da medição. O resumo de uma frase (teste Feynman) “A opinião do cliente é como pão fresco: cada dia que passa, mais dura e mais diferente do que saiu do forno. Pergunte enquanto está quente.” Fontes e leituras recomendadas EBBINGHAUS, Hermann. Über das Gedächtnis (Sobre a Memória), 1885. Replicação moderna: MURRE, Jaap M. J.; DROS, Joeri. “Replication and Analysis of Ebbinghaus’ Forgetting Curve”. PLOS ONE, v. 10, 2015. KAHNEMAN, Daniel. Rápido e Devagar: Duas Formas de Pensar. Objetiva, 2012. (Parte 5: sobre os dois “eus”.) REDELMEIER, Donald A.; KAHNEMAN, Daniel. “Patients’ Memories of Painful Medical Treatments”. Pain, v. 66, 1996. (O estudo da regra do pico-fim.) LOFTUS, Elizabeth F.; PALMER, John C.
Quantas respostas bastam para confiar num resultado?
10 respostas não são pesquisa. 10 mil nem sempre são melhores. A pergunta que todo cliente faz “Mas com quantas respostas eu posso confiar no resultado?” É provavelmente a pergunta mais frequente de quem começa a medir satisfação, e uma das mais mal respondidas do mercado. Este artigo responde sem nenhuma fórmula, usando uma panela de sopa. A sopa e a colher Imagine uma panela gigante de sopa. Você quer saber se está boa de sal. Precisa tomar a panela inteira? Claro que não. Uma colherada basta, desde que você mexa a sopa antes. Essa imagem, usada há décadas por professores de estatística, carrega quase tudo que importa sobre amostragem: Em linguagem técnica: “mexer a sopa” é garantir uma amostra representativa, aquela em que todo tipo de cliente tem chance de aparecer. E é aqui que a maioria das pesquisas quebra. Erro nº 1 de amostragem: a colher que só pega a superfície O caso mais famoso da história: em 1936, a revista americana Literary Digest enviou 10 milhões de cédulas de pesquisa e recebeu 2,4 milhões de respostas, a maior pesquisa eleitoral já feita até então. Previu vitória folgada de Alf Landon sobre Franklin Roosevelt. Roosevelt venceu com uma das maiores margens da história. No mesmo ano, George Gallup acertou o resultado com uma amostra centenas de vezes menor. O que deu errado? A Digest tirou seus endereços de listas telefônicas e registros de automóveis: em plena Grande Depressão, isso significava consultar principalmente gente de renda alta. E, entre os consultados, respondeu quem quis (os mais insatisfeitos com o governo). Dois vieses de uma vez: amostra torta e auto-seleção. A lição, que vale até hoje: 2,4 milhões de respostas tortas perdem para 2 mil respostas bem colhidas. Tamanho não conserta viés; só torna o erro mais confiante. É por isso que “10 mil nem sempre são melhores”: se as 10 mil respostas vieram só de um perfil (só quem clica em link de e-mail, só quem estava muito irritado ou muito encantado), você tem uma montanha de dados sobre a superfície da sopa. Esse é também o argumento científico da coleta presencial no momento da experiência: no ponto de venda, todo perfil de cliente passa pelo totem: o apressado, o satisfeito-silencioso, o que jamais responderia um e-mail. A sopa vem mais mexida. Erro nº 2: a colherada minúscula (amostra insuficiente) O outro extremo: gerente olha o painel na segunda-feira, vê 8 respostas do fim de semana, sendo 3 negativas, e aciona o alarme: “37% de insatisfação!”. Com 8 respostas, o acaso manda no resultado. Duas famílias mal atendidas no sábado produzem uma “crise” que não existe. É o mesmo motivo pelo qual tirar cara 3 vezes em 4 lançamentos de moeda não prova que a moeda é viciada. A estatística mede essa incerteza com a margem de erro: um “colchão” em volta do número, dentro do qual o valor verdadeiro provavelmente está. Sem fórmulas, o que a equipe precisa saber de cor é a ordem de grandeza: (Valores aproximados, para uma população de 10000 clientes e nível de confiança de 95%, o padrão de mercado.) Use a nossa calculadora, para ter uma ideia mais precisa dos seus números. Repare em duas coisas. Primeiro: os retornos são decrescentes. Sair de 100 para 400 respostas ajuda muito; sair de 1.000 para 2.500 ajuda pouco. Segundo: a consequência prática para leitura de dashboards. Uma variação de 4 pontos no NPS de uma loja com 80 respostas no mês não é notícia; é ruído dentro da margem. Antes de comemorar ou apagar incêndio, pergunte: a variação é maior que a margem de erro? Erro nº 3: fatiar até não sobrar nada Uma rede tem 5.000 respostas no trimestre — ótimo. Mas aí alguém quer o NPS da loja do bairro X, no turno da noite, entre clientes de primeira visita. Sobraram 12 respostas. O painel mostra o número do mesmo jeito, e ele balança loucamente a cada semana. Regra prática: cada fatia tem a sua própria margem de erro, sempre maior que a do bolo inteiro. Cada filtro aplicado encolhe a amostra e alarga a incerteza. Fatias pequenas servem para gerar hipóteses (“parece haver um problema no turno da noite — vamos observar mais”), nunca para veredito. As três perguntas antes de confiar num número Quem faz essas três perguntas lê qualquer dashboard (nosso ou de qualquer ferramenta do mundo) com olhos de cientista. O resumo de uma frase (teste Feynman) “Para saber se a sopa está boa, não precisa tomar a panela: basta mexer bem e provar uma colherada de tamanho honesto.” Fontes e leituras recomendadas SQUIRE, Peverill. “Why the 1936 Literary Digest Poll Failed”. Public Opinion Quarterly, v. 52, 1988. HUFF, Darrell. Como Mentir com Estatística. Intrínseca, 2016 (original de 1954). (Capítulos sobre amostras enviesadas.) COCHRAN, William G. Sampling Techniques. 3ª ed. Wiley, 1977. (A referência técnica clássica sobre amostragem, para quem quiser as fórmulas.) WHEELAN, Charles. Estatística: O Que É, Para Que Serve, Como Funciona. Zahar, 2016. (Introdução acessível a margem de erro e amostragem.)
NPS sem mistério: o que o número diz (e o que ele não diz)
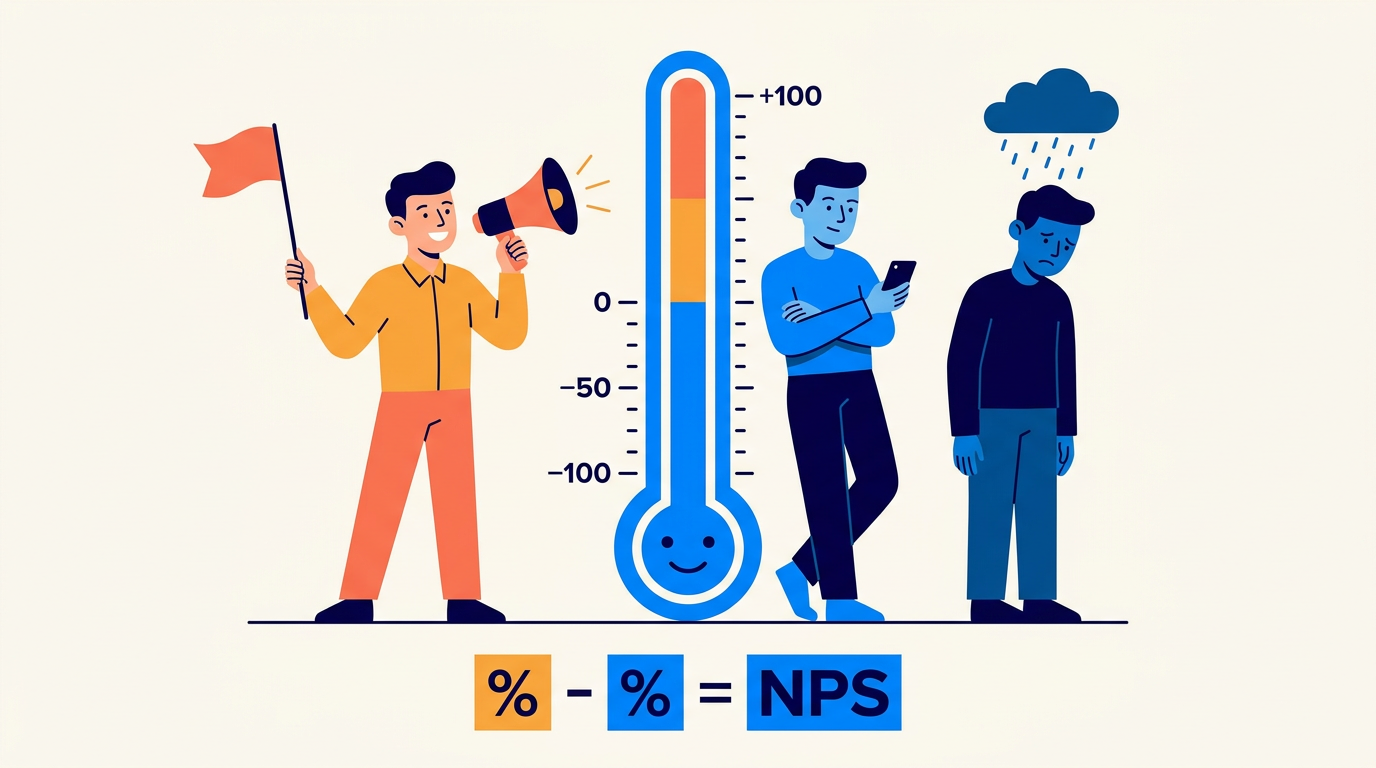
O cliente deu nota 7. Isso é bom ou ruim? Depende de quem responde — e depende de como o NPS trata essa nota. De onde veio esse número que todo mundo usa Em 2003, o consultor Frederick Reichheld, da Bain & Company, publicou na Harvard Business Review um artigo com um título ambicioso: “The One Number You Need to Grow” (o único número de que você precisa para crescer). A proposta era radical na sua simplicidade. Depois de testar dezenas de perguntas de pesquisa contra dados reais de recompra e indicação, Reichheld concluiu que uma pergunta superava quase todas as outras na maioria dos setores: “Em uma escala de 0 a 10, o quanto você recomendaria a [empresa] a um amigo ou colega?” Nascia o Net Promoter Score, o NPS. Vinte anos depois, é provavelmente a métrica de experiência do cliente mais usada no mundo, e a linguagem diária de boa parte dos nossos clientes. Por isso, todo mundo na Solvis precisa dominar a mecânica e a interpretação da métrica e, principalmente, os seus limites. A mecânica em 60 segundos As respostas de 0 a 10 dividem os clientes em três grupos: A conta: NPS = % de promotores − % de detratores O resultado vai de −100 (todo mundo detrator) a +100 (todo mundo promotor). Os neutros não entram na conta, mas entram no denominador: “empurrar” um neutro para promotor sobe o placar. Exemplo: 100 respostas, sendo 55 promotores, 30 neutros e 15 detratores. NPS = 55% − 15% = 40. As três pegadinhas de interpretação 1. A nota 7 não é “boa”, e isso é proposital. Na escola, 7 é aprovação. No NPS, 7 é neutro. Por quê? Porque as pessoas tendem a ser educadas em pesquisas e inflar notas (lembra da aquiescência, no artigo sobre perguntas?). A régua do NPS é dura de propósito: só conta como promotor quem demonstra entusiasmo inequívoco. Quando um cliente da Solvis pergunta “por que nota 8 não conta a favor?”, essa é a resposta: a escala desconta a gentileza. 2. NPS não é média. Duas lojas podem ter a mesma média de notas e NPS muito diferentes. Uma loja onde todos dão 8 tem NPS 0. Uma loja onde metade dá 10 e metade dá 6 também tem NPS 0. São situações completamente diferentes: a segunda tem fãs e insatisfeitos; a primeira, um mar de indiferença. Por isso, olhe sempre a distribuição das notas junto com o placar. 3. Comparar NPS entre setores (e países) é armadilha. O NPS “bom” varia por setor: bancos, supermercados e hospitais têm réguas naturais diferentes. Também varia com a cultura local: há evidência de que padrões de resposta a escalas mudam entre países. A comparação mais honesta é sempre você contra você mesmo ao longo do tempo, e contra concorrentes diretos medidos do mesmo jeito. O que o NPS não diz (e é aqui que nós entramos) O NPS funciona como um termômetro: mostra que há febre, mas não identifica a infecção. Um NPS que caiu de 62 para 48 não conta se o problema é fila, preço, produto ou o ar-condicionado quebrado. Por isso a pergunta de nota deve vir acompanhada da pergunta aberta (“o que motivou a sua nota?”) e de perguntas específicas por dimensão. É o conjunto que transforma o placar em diagnóstico. Vale conhecer também as críticas técnicas à métrica, publicadas em pesquisa acadêmica: estudos como o de Timothy Keiningham e colegas (Journal of Marketing, 2007) testaram a alegação de que o NPS seria o melhor preditor de crescimento e não conseguiram replicá-la: a satisfação tradicional previa crescimento tão bem quanto. O consenso prático que ficou é que o NPS vale pela simplicidade e pela comparabilidade, sem os poderes mágicos de previsão que o artigo original prometia. Quem promete que “subir NPS = crescer receita” está vendendo além da evidência. E há um risco de gestão documentado: quando o NPS vira meta de bônus individual, nasce a tentação de caçar nota em vez de melhorar a experiência (“me dá um 10 que me ajuda muito?”). Isso é uma manifestação da Lei de Goodhart: quando uma medida vira meta, deixa de ser uma boa medida. Uma nota coletada sob pressão diz mais sobre o constrangimento do cliente do que sobre a lealdade dele. O próprio criador está reclamando: e agora? Em 2025, num painel de mercado, o próprio Reichheld declarou estar “cansado de pesquisas”, e a frase virou manchete: “o NPS morreu?”. Lida por inteiro, porém, a reclamação dele tem endereço certo, e não é a métrica: é o NPS mal operado. Os alvos que ele cita são a pesquisa por e-mail em massa com 1% a 3% de resposta (amostra pequena e torta, como explica o artigo sobre amostra), a nota de cortesia ou mendigada por quem tem bônus atrelado (a Lei de Goodhart da seção anterior, em escala de mercado) e a coleta que não gera ação nenhuma. Repare: são três problemas de operação, não de fórmula, e cada um tem antídoto conhecido: coleta no momento da experiência, incentivo bem desenhado e ciclo fechado. A resposta construtiva do próprio Reichheld veio em “Net Promoter 3.0” (Harvard Business Review, 2021): complementar o placar declarado com uma régua comportamental, o Earned Growth Rate, que separa a receita “ganha” (clientes que voltam e clientes que chegam por indicação) da receita “comprada” (aquisição paga). A lógica é elegante: o promotor de verdade aparece no caixa, não só no questionário. É uma régua auditável e imune ao pedido de dez, embora exija um rastreamento da origem de cada cliente que poucas empresas têm hoje. Para a leitura diária, fica a lição: nota declarada e comportamento real são dois termômetros que se vigiam, e divergência entre eles é informação. No mesmo embalo, parte do mercado prega substituir pesquisas por “sinais” capturados por IA: carrinho abandonado, cliques de raiva, tom de voz. Dois cuidados antes de aderir. Primeiro, quem faz esse diagnóstico costuma vender exatamente a plataforma de sinais que receita, então separe o diagnóstico
Anatomia de uma boa pergunta: Por que o jeito de perguntar muda a resposta
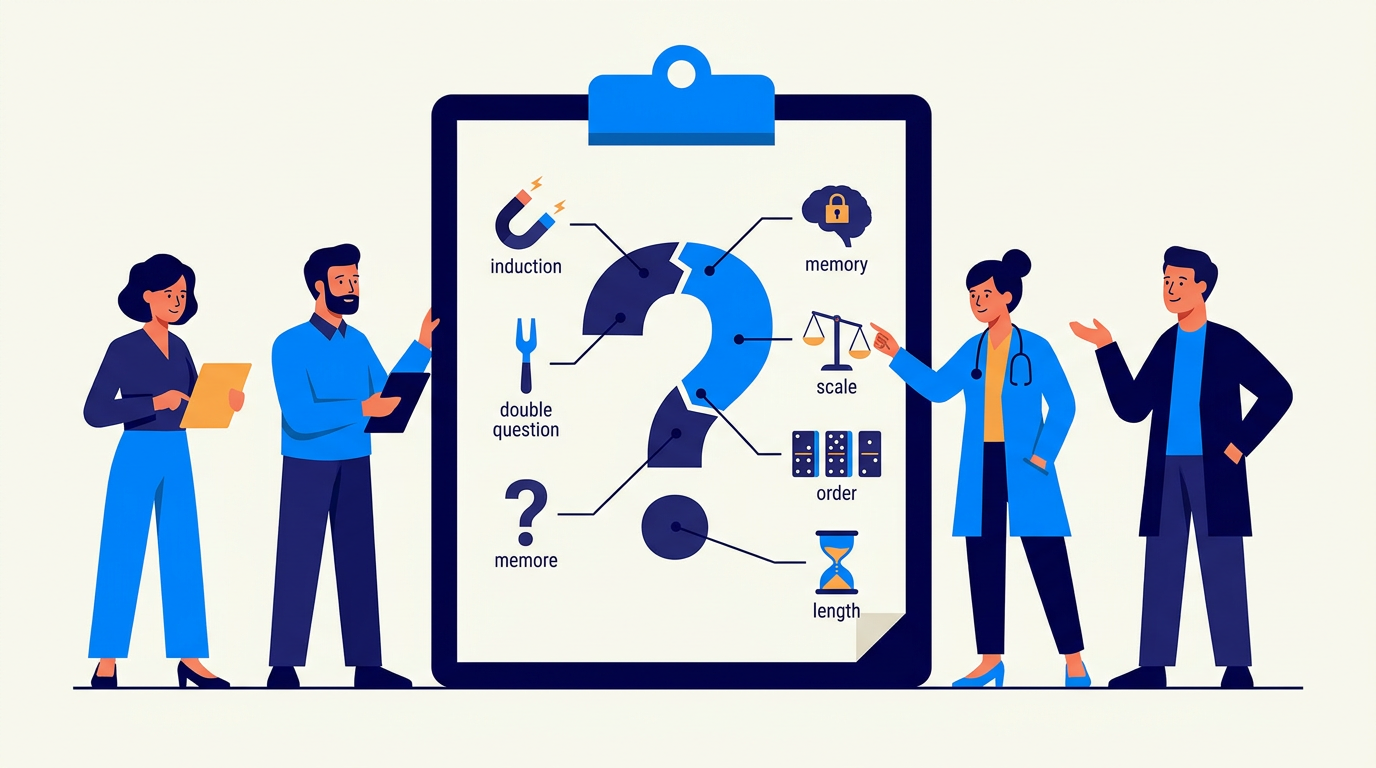
“Você gostou?” e “O que achou?” parecem iguais. Não são. Toda pergunta de pesquisa é um instrumento de medição, e instrumentos mal calibrados enganam. Na Clínica Aurora Wagner, administrador da Clínica Aurora, uma rede de clínicas médicas, tinha um rascunho pronto para o totem da recepção e a satisfação de quem enxugou tudo em uma linha: “Você ficou satisfeito com o atendimento da recepção e da equipe médica?”. Curta, educada, direta. Mari Ferreira, consultora da Solvis que acompanhava a implantação, leu a pergunta duas vezes e devolveu o notebook com outra pergunta no lugar de uma opinião: — Se o paciente responder 3… o que exatamente você vai consertar? Wagner abriu a boca para responder e percebeu a armadilha no meio do caminho. Um 3 podia ser uma hora de espera com uma consulta excelente, um médico atencioso atrás de uma recepção caótica, ou um paciente irritado com o convênio, sem culpa de ninguém dali. A pergunta era uma só; as respostas dentro dela eram três. A pergunta de pesquisa: o instrumento mais delicado “Um termômetro mal calibrado mede a febre errada. Uma balança desregulada mente o peso. E uma pergunta mal formulada coleta uma opinião que o cliente não tem.” A pergunta é o instrumento de medição da pesquisa, e é um instrumento delicado. Décadas de pesquisa em metodologia de questionários (a área tem até nome: survey methodology) mostram que mudanças aparentemente inocentes na redação, na ordem ou nas opções de resposta alteram os resultados de forma mensurável. Um exemplo clássico: em experimentos conduzidos pela psicóloga Elizabeth Loftus nos anos 1970, pessoas assistiam ao vídeo de um acidente de carro. Quando perguntadas “a que velocidade os carros iam quando se esmagaram?”, as estimativas eram significativamente maiores do que quando o verbo era “se bateram”. Uma palavra mudou a memória do que as pessoas viram. Se uma palavra faz isso com uma memória, imagine o que faz com uma opinião. Todo mundo na Solvis, de vendas a suporte, deveria saber reconhecer uma pergunta ruim. Este artigo é o manual de anatomia. As 7 fraturas mais comuns de uma pergunta 1. A pergunta induzida (leading question) Ela já carrega a resposta desejada dentro de si. “Você gostou?” pressupõe que houve gosto, e as pessoas tendem a concordar com pressuposições, um fenômeno documentado chamado aquiescência (a tendência de responder “sim” independentemente do conteúdo). “O que achou?” abre espaço para qualquer resposta. Parecem iguais; medem coisas diferentes. 2. A pergunta dupla (double-barreled) Duas perguntas vestidas de uma. Impossível responder com uma nota só. E se foi rápido e grosseiro? A nota 3 significa o quê? Regra simples: um assunto por pergunta. Se tem “e” no meio, desconfie. 3. A pergunta que exige memória demais Ninguém lembra. O respondente não deixa em branco: inventa um número plausível. Pergunte sobre períodos curtos e experiências recentes, tema tão importante para nós que tem artigo próprio nesta série (O momento da verdade). 4. O jargão e a ambiguidade Cada respondente entende uma coisa, e a média de interpretações diferentes não significa nada. Use a linguagem do respondente, não a da empresa. E troque termos vagos por quantidades. 5. A escala torta A escala é metade da pergunta. Fraturas comuns: A referência clássica aqui é a escala Likert (proposta pelo psicólogo Rensis Likert em 1932): afirmação + graus simétricos de concordância, com ponto neutro. Simples, testada há quase um século, e ainda assim frequentemente mal copiada. 6. A ordem que contamina Perguntas anteriores criam contexto para as seguintes. Perguntar “qual foi o problema do seu atendimento?” antes de “qual sua satisfação geral?” faz a nota geral cair: o respondente foi convidado a lembrar do problema primeiro. Regra prática: do geral para o específico, e perguntas delicadas (incluindo dados pessoais) por último. 7. O questionário-maratona Cada pergunta a mais custa atenção, e atenção é o que o respondente tem de mais escasso. Questionários longos sofrem de abandono e de respostas em linha reta (o respondente marca tudo 5 só para acabar logo, fenômeno conhecido como straightlining). No ponto de venda, onde o cliente responde em pé, no caminho da saída, a disciplina é ainda mais brutal: cada pergunta precisa pagar o próprio aluguel. Se a resposta não vai mudar nenhuma decisão, a pergunta não deveria existir. O teste de bancada: 5 perguntas antes de publicar Antes de qualquer questionário ir a campo, submeta cada pergunta a este checklist: E o teste final, herdado do método científico: teste-piloto. Peça para 5 pessoas responderem na sua frente, falando em voz alta o que entendem de cada pergunta (a técnica formal se chama entrevista cognitiva). É impressionante o que 20 minutos disso revelam. Por que isso importa para nós O cliente da Solvis não compra “um totem”: compra respostas confiáveis. E não existe resposta confiável saída de pergunta ruim: viés na entrada, lixo na saída. Saber reconhecer uma pergunta fraturada é, portanto, uma competência que atravessa toda a operação de quem coleta dados de satisfação: de quem atende o cliente no dia a dia a quem desenha os questionários e os fluxos de coleta. Cada pergunta bem formulada é um voto de confiança no dado que ela vai gerar — e cada uma malfeita é um ponto cego que ninguém percebe até doer. De volta à Aurora Na Aurora, a pergunta dupla virou duas perguntas inteiras, cada uma com um dono claro do outro lado: recepção para a escala e o fluxo de senhas, equipe médica para a coordenação clínica. Na primeira semana de coleta, o mistério se desfez: equipe médica 4,8, recepção 3,8. A nota que a pergunta emendada teria misturado num 4,3 sem endereço apontava agora para a espera do balcão, invisível até então. O teste da Mari entrou no ritual de bancada da clínica: antes de publicar qualquer pergunta, alguém responde mal a ela de propósito, e a equipe confere se saberia o que consertar. Pergunta que não passa, não entra. O resumo de uma frase (teste Feynman) “A pergunta é uma balança: se ela estiver torta, não
Achismo, opinião e evidência: qual é a diferença?
Entenda a diferença entre achismo, relato, dado sistemático e evidência testada e descubra como decisões baseadas em dados podem melhorar a gestão das empresas.
O Erro Invisível na Análise do PDV: Quando Trocar o Gerente Não É a Causa do Sucesso
Como Diagnósticos Equivocados Comprometem As Decisões Estratégicas no Varejo Imagine a seguinte situação: em uma rede varejista com 35 unidades físicas, a diretoria decide substituir o gerente de uma loja cujas métricas de desempenho estavam em queda. No mês subsequente à troca, a nota de satisfação do cliente no ponto de venda subiu 12 pontos, levando a alta liderança a comemorar o sucesso da decisão na reunião mensal de resultados. Entretanto, uma auditoria de processos subsequente revelou um fator crítico omitido pelo painel executivo: as obras viárias na avenida principal da loja foram concluídas naquele mesmo mês. Isso dobrou o fluxo de pedestres e facilitou o acesso dos consumidores ao estabelecimento. Dessa forma, o novo gestor recebeu o crédito por um incremento impulsionado, na realidade, pela normalização do tráfego urbano na região. Assumir que eventos simultâneos possuem relação direta de causa e efeito é um dos equívocos analíticos mais dispendiosos na gestão operacional. Confundir correlação estatística com causalidade induz a diagnósticos incorretos e alocação ineficiente de recursos de capital. Para se aprofundar em métricas de desempenho e otimização operacional, confira nosso guia sobre indicadores essenciais de satisfação do cliente no varejo. O Fenômeno da Variável Oculta: Entendendo a Dinâmica Um exemplo clássico Ilustra bem essa questão: nas regiões litorâneas, as vendas de sorvete e as ocorrências de afogamento apresentam picos exatamente nos mesmos meses do ano. Concluir que o consumo de sorvete provoca afogamentos seria uma falácia evidente. Nesse cenário, a variável oculta (ou de confusão) é a temperatura elevada. Os dias quentes atraem maior contingente de pessoas às praias, aumentando simultaneamente o consumo de produtos gelados e a densidade de banhistas no mar. A oscilação térmica é o fator primário que movimenta ambas as variáveis. No contexto do ponto de venda, a inteligência de dados aplicada requer esse mesmo rigor de análise estatística. Se o faturamento registrar alta imediatamente após o treinamento da equipe de atendimento, a causa real pode ser o treinamento, a sazonalidade do setor ou uma campanha promocional concorrente. Framework Analítico: As Quatro Perguntas para Validação de Hipóteses Para converter dados brutos em insights operacionais acionáveis com elevado grau de certeza, a liderança executiva deve submeter qualquer alteração de indicador a quatro questionamentos fundamentais antes de decidir investimentos. A primeira pergunta avalia a relevância estatística, verificando se a variação observada não é mero ruído temporal resultante de amostragens reduzidas ou intervalos de análise curtos. A segunda pergunta foca na identificação de variáveis exógenas e não mapeadas que possam estar influenciando simultaneamente os indicadores sob análise. A terceira pergunta investiga a causalidade reversa. Por exemplo, clientes altamente engajados costumam responder a pesquisas no momento da compra por já nutrirem afinidade com a marca, e não necessariamente o inverso. Para entender melhor como capturar o feedback correto sem viés de amostragem, veja a documentação sobre metodologias de coleta de feedback no momento da verdade. A quarta pergunta estabelece o protocolo de teste experimental. A validação mais segura ocorre ao estruturar testes controlados (A/B) em unidades selecionadas antes de padronizar alterações em toda a rede. Checklist de Bolso: As 4 Perguntas da Investigação de Causalidade Trata-se de uma oscilação casual? Amostras reduzidas e janelas de tempo limitadas frequentemente geram padrões ilusórios nos dashboards de gestão. Há variáveis exógenas intervindo? Fatores como sazonalidade, infraestrutura local, ações promocionais ou feriados sofreram alterações no mesmo período? A direção da causalidade está correta? O resultado observado impulsionou o indicador ou a métrica elevada precedeu a mudança? Como estruturar a validação experimental? A implementação de projetos-piloto em lojas de controle valida premissas antes de investimentos em escala global. No caso da rede varejista mencionada, o gerente permaneceu na liderança da unidade, contudo, o comitê executivo reestruturou seus protocolos de inteligência analítica. A empresa assimilou que a metodologia de coletar, interpretar e agir exige o isolamento criterioso de variáveis por meio de testes locais controlados antes de chancelar diretrizes globais. A ocorrência de dois indicadores não implica relação de causa e efeito. Antes de tomar decisões estratégicas, certifique-se de identificar todas as variáveis ocultas que podem estar influenciando os resultados. Reflita sobre sua operação: quando foi a última vez que uma alteração nos resultados foi atribuída à causa errada apenas pelo alinhamento temporário de dois gráficos nos relatórios mensais? Autor: Eduardo Peters