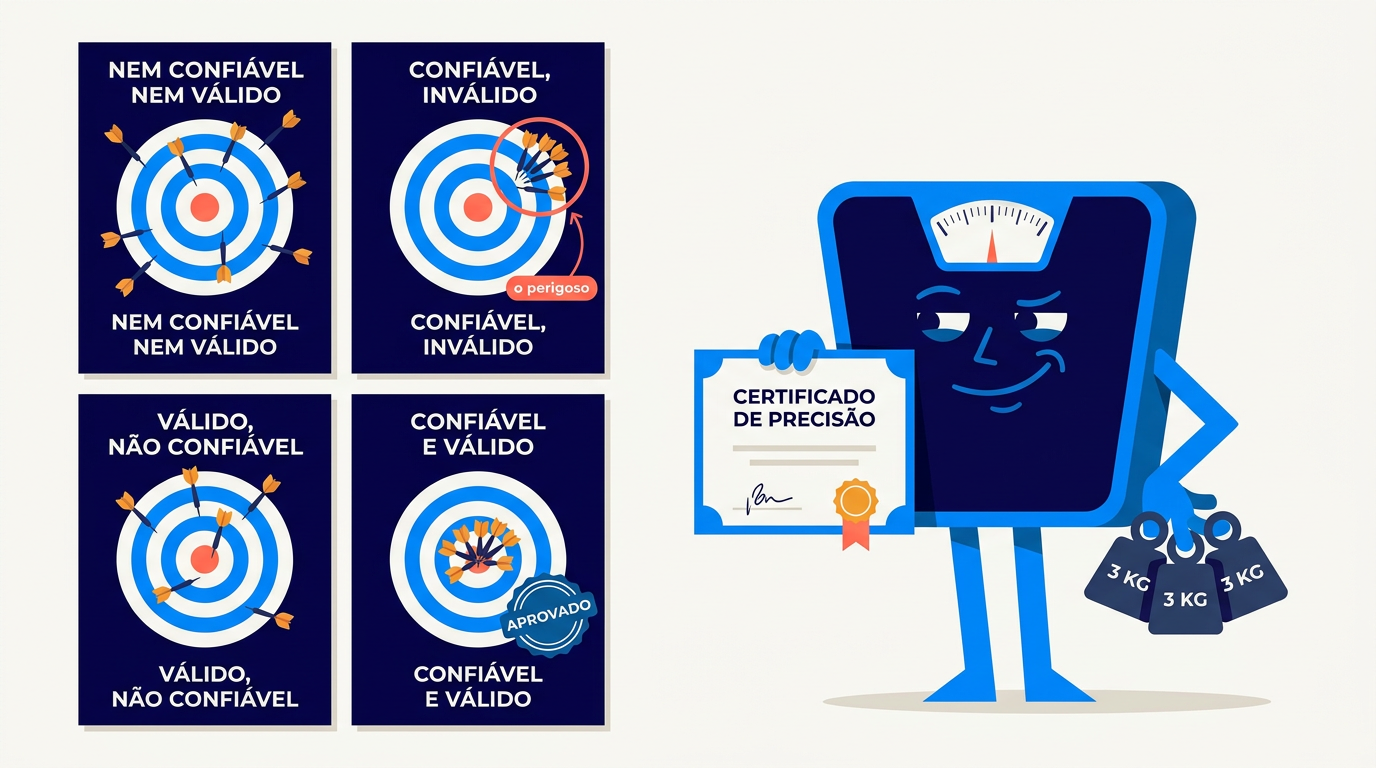
Uma balança que marca sempre 3 quilos a menos é confiável, e mente todos os dias. Validade e confiabilidade são as duas perguntas que todo instrumento de medição precisa responder. Na Clínica Aurora Na auditoria anual do questionário da Clínica Aurora, rede de clínicas médicas, Wagner, o administrador, parou numa pergunta veterana: “Você se sentiu bem na clínica?”. Criada dois anos antes, ela tinha um propósito original de que quase ninguém lembrava: monitorar a limpeza das unidades. A série histórica denunciava o problema: a nota oscilava com o tempo de espera, despencava nas semanas de calor (ar-condicionado no limite), subia em dezembro com a decoração de fim de ano, e permanecia serenamente indiferente aos dois episódios reais de falha de limpeza que a clínica tinha registrado no período. O instrumento era estável, até consistente no seu jeito: media alguma coisa, sempre do mesmo modo. Só não media limpeza. Media um humor geral de “estar bem”, temperado de espera e temperatura. — A régua não treme — resumiu Wagner para Mari, a consultora da Solvis. — Ela aponta para o alvo errado, com firmeza admirável. Validade e confiabilidade: as duas perguntas que ninguém faz ao instrumento Antes de confiar em qualquer medição (de temperatura, de peso ou de satisfação), a metrologia faz duas perguntas distintas: São independentes, e a combinação delas define quatro destinos possíveis para uma pesquisa. A imagem clássica é o alvo de dardos: O mercado de pesquisa vive cheio de balanças do segundo tipo: séries históricas lindas, estáveis, comparáveis, medindo consistentemente a coisa errada. Confiabilidade: o instrumento não pode tremer Três formas práticas de tremor, e como detectá-las: Tremor no tempo (estabilidade). Se nada mudou na operação, a medição deveria dar parecido esta semana e na próxima. Oscilação grande sem causa é sinal de instrumento ruim, ou de amostra pequena demais (artigo Amostra: antes de culpar o instrumento, confira a margem de erro; artigo Diferença real ou ruído?: diferença real ou ruído?). Tremor entre itens (consistência interna). Se cinco perguntas pretendem medir a mesma dimensão (digamos, “presteza”; artigo As cinco dimensões da qualidade de serviço), as respostas delas deveriam andar juntas. Quando uma destoa sistematicamente das irmãs, ela provavelmente mede outra coisa. A psicometria tem um índice clássico para isso, o alfa de Cronbach, que resume o quanto os itens de um grupo variam juntos. Não é preciso calculá-lo à mão; é preciso saber que a pergunta “esses itens medem mesmo a mesma coisa?” tem resposta verificável. Tremor entre leitores (concordância). Vale para a análise qualitativa: dois analistas categorizando os mesmos comentários (artigo Quali e quanti) deveriam chegar a etiquetas parecidas. Se cada um classifica de um jeito, o “31% citam espera” muda conforme quem conta. O instrumento aqui é o esquema de categorias, e ele está trêmulo. O que mais destrói confiabilidade na prática: perguntas ambíguas (cada um entende uma coisa; artigo Anatomia de uma boa pergunta), escalas sem rótulos (cada um inventa a régua; artigo Escala Likert) e mudanças de redação no meio da série histórica (mudou a pergunta, nasceu outro instrumento e a série quebrou; artigo Escala Likert, pecado 3). Validade: o instrumento não pode apontar para o lugar errado Quatro testes, do mais barato ao mais forte: 1. Validade de face: o teste do cheiro. A pergunta parece medir o que promete, para quem lê? “Você recomendaria?” tem cara de lealdade; “quantas estrelas?” tem cara de… alguma coisa. É o teste mais fraco, mas filtra os absurdos. O pré-teste cognitivo é onde ele acontece de verdade: descobrir o que o respondente entendeu pode ser bem diferente do que se perguntou. 2. Validade de conteúdo: o mapa cobre o território? “Satisfação com a loja” tem dimensões (artigo As cinco dimensões da qualidade de serviço: confiabilidade, presteza, segurança, empatia, tangíveis). Um questionário que só pergunta sobre limpeza mede um pedaço e assina pelo todo. Teste prático: liste as dimensões da experiência real do cliente (os comentários abertos são o mapa; artigo Quali e quanti) e confira o que o questionário cobre. 3. Validade de construto: o número se comporta como o conceito? Se sua métrica mede mesmo satisfação, ela deveria se relacionar com as coisas que a teoria manda: subir quando o serviço melhora, andar junto com recompra, cair após incidentes. Métrica que não reage a nada que deveria movê-la está medindo outra coisa (ou nada; artigo Métricas de vaidade). 4. Validade preditiva: o teste supremo. A nota de hoje prevê o comportamento de amanhã? Detratores abandonam mais? Notas de espera baixas antecedem queda de fluxo no horário? É o teste mais caro, porque exige cruzar pesquisa com comportamento real ao longo do tempo (artigo Tipos de pesquisa, pesquisa preditiva), e o único que fecha a questão. A literatura que ligou satisfação a resultado financeiro (artigo O caso financeiro da satisfação) é exatamente isso: validação preditiva em escala acadêmica. O checklist do instrumento honesto Antes de confiar numa série de dados, sua ou de terceiros: Cinco perguntas que separam medição de ritual. Por que isso importa Quando alguém pergunta “essa pesquisa funciona mesmo?”, está perguntando, sem o vocabulário, sobre validade e confiabilidade. Quem domina esses conceitos responde com critérios, não com convicção: mostra a consistência da série, o vínculo entre nota e comportamento, a cobertura das dimensões. É a diferença entre pedir confiança e demonstrá-la. De volta à Aurora Na Aurora, a pergunta simpática e inválida foi aposentada com honras e substituída por duas específicas, cada uma mirando o que a decisão precisava: limpeza (“recepção, consultório e banheiro estavam limpos?”) e conforto (“espera, temperatura e acomodação estavam bem?”). Na primeira falha de limpeza seguinte, a pergunta nova acusou o golpe em dois dias: exatamente o que a antiga nunca tinha feito. A auditoria anual ganhou o ritual dos alvos de dardos: para cada pergunta do questionário, “ela acerta sempre o mesmo lugar?” (confiabilidade) e “o lugar que ela acerta é o que queremos medir?” (validade). Pergunta que treme, conserta-se; pergunta que aponta para o alvo errado, por mais firme que seja, troca-se. O resumo de
Vieses do respondente: o que distorce a resposta antes de ela chegar ao dado
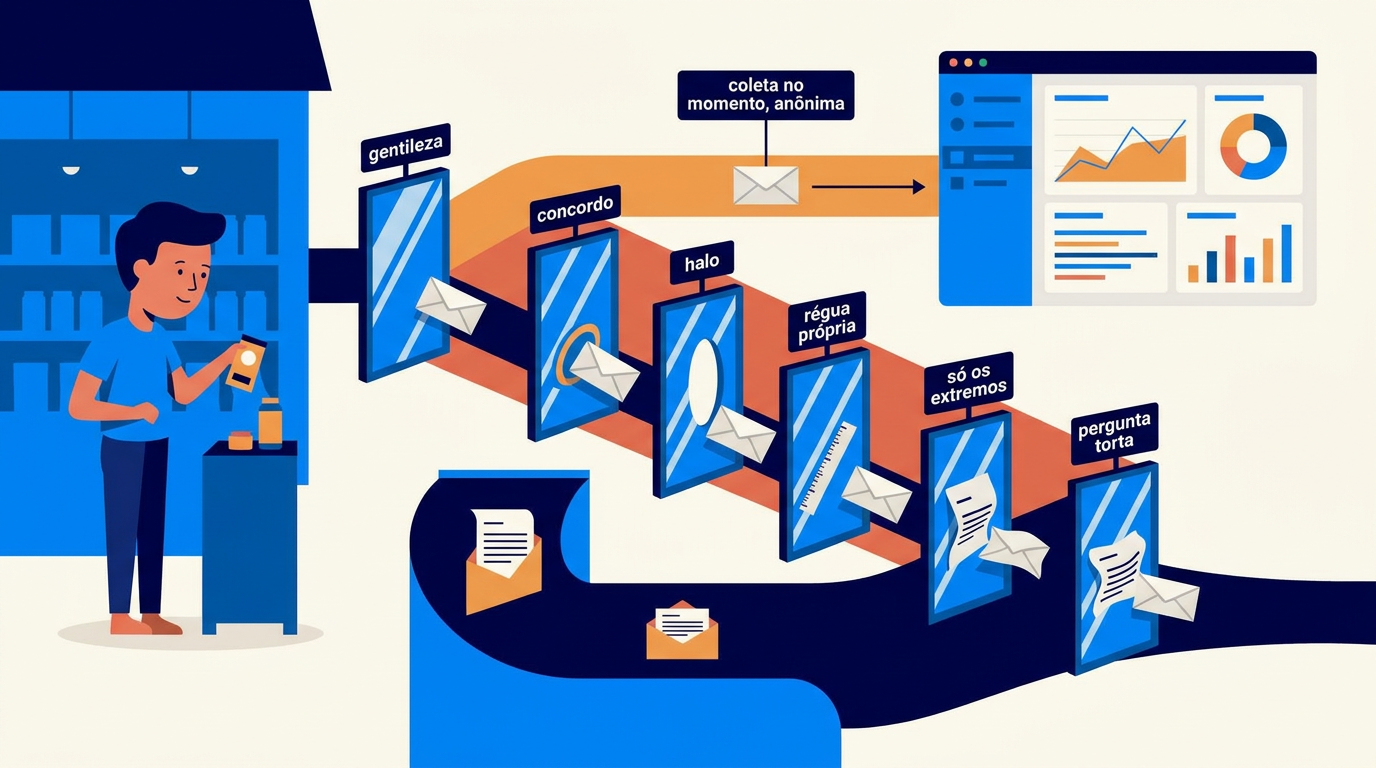
Os vieses de quem lê os dados são bem conhecidos. Os vieses do respondente, os de quem produz o dado, agem antes: nenhuma estatística posterior conserta o que já chegou torto. Na Clínica Aurora O coordenador mais novo da Clínica Aurora, rede de clínicas médicas, queria mostrar serviço e resolveu reforçar a medição por conta própria: passou uma semana na saída dos consultórios com uma prancheta, colhendo avaliações paciente a paciente, com sorriso e caneta em punho. Resultado: média 4,9. Mandou no grupo de coordenadores com três foguetes. Mari Ferreira, consultora da Solvis que acompanha a conta da Aurora, abriu na mesma tela o número do totem da mesma unidade, na mesma semana: 4,1. — Alguém aí está mentindo — disse o coordenador, meio rindo, meio ofendido. — Ninguém está mentindo — respondeu Mari, com a sobrancelha erguida de quem já tinha visto esse gráfico antes. — Mas pense no que é dizer “achei ruim”, olhando nos olhos, dentro da clínica que cuida da sua saúde. Uma dessas duas pesquisas está medindo outra coisa. Quer descobrir qual? O outro lado da balança: os vieses do respondente Os atalhos mentais de quem analisa (confirmação, ancoragem, sobrevivência) são só metade do problema. Há uma segunda família de vieses, que age antes, dentro da cabeça de quem responde. Eles distorcem o dado na origem, e nenhuma estatística posterior conserta o que já chegou torto (artigo Anatomia de uma boa pergunta: viés na entrada, lixo na saída). A boa notícia: são conhecidos, catalogados há décadas pela metodologia de pesquisa, e quase todos têm antídoto de projeto. Eis os sete que mais atacam pesquisas de satisfação. 1. Desejabilidade social: a resposta que fica bem As pessoas ajustam respostas para parecer (e se sentir) bem: mais generosas, mais saudáveis, menos reclamonas do que são. Em satisfação, o efeito clássico é a nota-gentileza: o cliente que não quer “prejudicar a moça do caixa” e dá 5 para uma experiência 3. O efeito cresce com a presença humana: pesquisa respondida na frente de um entrevistador (ou do próprio atendente) infla sistematicamente as notas, fenômeno medido em décadas de comparações entre modos de coleta. Antídoto de projeto: anonimato real e autoatendimento. O respondente sozinho diante da tela diz mais verdade do que diante de uma pessoa. É um argumento científico direto a favor do totem contra a prancheta do promotor. E nunca peça a avaliação através de quem está sendo avaliado (“dá uma notinha pra mim?”). 2. Aquiescência: a tendência a concordar Já apresentada nos artigos Anatomia de uma boa pergunta e Escala Likert: diante de uma afirmação, parte das pessoas concorda por padrão, qualquer que seja o conteúdo. Quando dá, prefira escalas de avaliação às de concordância e formule afirmações neutras. Em questionários longos, vale alternar o sentido das afirmações para flagrar quem concorda com tudo. 3. Halo na resposta: uma impressão pinta todas as notas O mesmo efeito halo que distorce quem analisa, agora do lado de lá: uma impressão dominante (o atendente simpático, a fila revoltante) contamina a avaliação de todos os itens. O cliente encantado com a vendedora dá 5 até para a limpeza do banheiro em que não entrou. Sinal de alerta na análise: notas idênticas em todos os itens, sem variação. Antídotos: perguntas específicas e concretas em vez de genéricas (“a fila andou rápido?” sofre menos halo que “avalie o atendimento”), o “não sei/não usei” como saída honesta (artigo Anatomia de uma boa pergunta), e a leitura por distribuição, que revela o bloco de respostas em linha reta. 4. Recência e pico: a memória edita a experiência A memória não guarda a média da experiência; guarda o pico e o final (a regra do pico-fim, documentada por Kahneman e Redelmeier). Uma hora de jantar impecável com dez minutos finais de espera pela maquininha vira, na lembrança, “demorou”. E quanto mais tempo passa, mais a edição avança (artigo O momento da verdade: Ebbinghaus). Antídotos: coletar no momento (a resposta de agora é menos editada) e saber o que se está medindo: a pesquisa transacional colhe a experiência; a relacional, semanas depois, colhe a memória da experiência (artigo Tipos de pesquisa). As duas são informação, mas não a mesma informação. 5. Estilos de resposta: cada pessoa tem uma régua Há quem nunca dê nota máxima (“10 é só pra Deus”) e quem dê 10 para tudo que não ofende. Há inclusive padrões culturais documentados: populações inteiras mais propensas aos extremos ou ao centro da escala. Entre lojas de perfis demográficos muito diferentes, parte da diferença de nota diz mais sobre a régua de cada público do que sobre a experiência. Antídotos: rótulos verbais em todos os pontos (artigo Escala Likert, que encurtam a variação de interpretação), comparar cada unidade com ela mesma no tempo antes de compará-la com as outras, e ligas de comparáveis (artigo Comparações justas). 6. Auto-seleção: o viés de quem aparece O mais estatístico dos vieses de respondente, já dissecado no artigo Amostra (Literary Digest): quem escolhe responder não representa quem não escolheu. Os extremos (encantados e furiosos) respondem mais; o meio silencioso, que é a maioria, some. A defesa está na coleta no fluxo natural da experiência, por onde todo perfil passa, e na fricção mínima, porque cada segundo de esforço a mais filtra mais gente do meio. Monitorar a taxa de resposta, e não só as notas, é o que revela a saúde da coleta. 7. Vieses embutidos no enunciado: quando o autor sabota Os três sabotadores que a redação instala dentro da pergunta: A tabela de bolso Viés O que faz Antídoto principal Desejabilidade social Nota-gentileza Anonimato, autoatendimento Aquiescência “Concordo” com tudo Avaliação em vez de concordância Halo Uma impressão pinta tudo Perguntas concretas + “não usei” Recência/pico Memória editada Coletar no momento Estilos de resposta Cada um com sua régua Rótulos verbais; comparar no tempo Auto-seleção Só os extremos aparecem Coleta no fluxo, fricção mínima Enunciado viciado A pergunta sopra a resposta Redação neutra, positiva, sem âncora Por que isso importa Metade desses vieses é atenuada por
A empresa que aprende: fechando o ciclo entre pesquisa, conhecimento e cultura
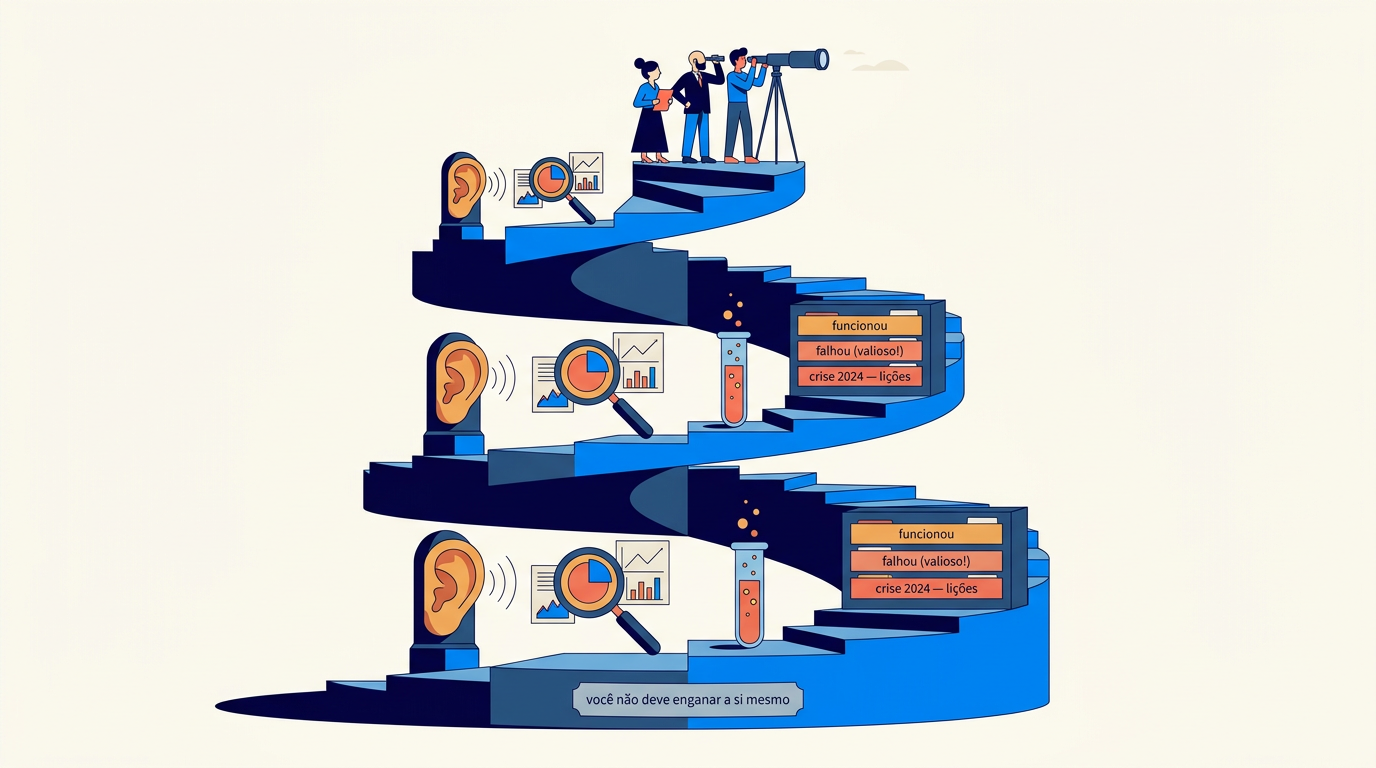
No fim, o concorrente pode copiar o produto, o preço e até o totem. O que não se copia é a velocidade com que uma empresa aprende. É isso que faz de uma empresa uma empresa que aprende. Na Casa Camélia A visita deu a Regina, gerente da unidade Centro da Casa Camélia, rede de restaurantes de Curitiba, uma sensação de déjà-vu. Na unidade nova, a equipe sofria com a fila do almoço engasgada na entrada, o gerente testava soluções no improviso, clientes desistiam na porta. Era, gesto por gesto, o problema que o Centro tinha vivido e resolvido dois anos antes, com uma ideia simples de remanejo do caixa e senha dupla no balcão. — A gente já resolveu isso — disse ela ao gerente novo. — Quem te passou o caderno de soluções? A resposta era a que ela temia: caderno nenhum. A solução do Centro morava na memória de quem a fez, e quem a fez já não estava na casa. A unidade nova não era negligente: estava pagando, com meses de fila, por um aprendizado que a empresa já tinha comprado uma vez. A pergunta que fecha o bloco Esta série dedicou um bloco à gestão da pesquisa. Começou com um organismo: o programa de Voz do Cliente e seu sistema nervoso (Voz do Cliente). Passou pelo dinheiro (O caso financeiro da satisfação), pelos ritos (Rituais de gestão), pelas metas (Metas de satisfação bem desenhadas), pelas pessoas (O elo colaborador-cliente), pela priorização (Priorização de melhorias), pela rede (Pesquisa em redes e franquias), pela inovação (Pesquisa e inovação) e pela crise (Gestão de crise guiada por pesquisa). Falta a pergunta de fundo, que é o teste final de tudo: a empresa está ficando mais inteligente com o tempo, ou apenas mais informada? A distinção é de Peter Senge e da tradição da “organização que aprende” (learning organization): informação é estoque; aprendizado é a mudança de comportamento que a informação provoca e que permanece quando as pessoas mudam de cadeira. Dá para ter dashboards impecáveis e mesmo assim redescobrir o mesmo erro a cada troca de gerente, reaprendendo do zero a cada ciclo. Os três vazamentos da empresa que aprende (por onde o aprendizado escapa) Vazamento 1: a lição que fica na cabeça de alguém.O gerente que aprendeu na crise de três anos atrás sai da empresa e leva a solução da próxima junto, embrulhada de presente. Conhecimento não documentado é conhecimento alugado. O antídoto tem nome ao longo da série: fichas de experimento arquivadas (artigo Experimentos internos, inclusive e principalmente as que falharam), postmortems escritos (artigo Gestão de crise guiada por pesquisa), atas de decisão com critério (artigo Rituais de gestão). O acervo dessas peças é a memória institucional de verdade. Sem ele, o que sobra é o que as pessoas lembram de contar umas para as outras, e isso não sobrevive a duas trocas de equipe. Vazamento 2: a lição documentada que ninguém consulta.O cemitério de PDFs: relatórios impecáveis que ninguém abre. Documentar não basta; o aprendizado precisa voltar ao fluxo de decisão: a ficha de iniciativa nova que pergunta “o que já testamos parecido?” (e a resposta é consultável); o padrão que virou norma revisada em vez de anexo; o radar de crise recalibrado pelo postmortem (artigo Gestão de crise guiada por pesquisa). A régua honesta: aprendizado que não mudou um processo, um checklist ou uma decisão ainda não aconteceu. É a versão institucional do teste do artigo Métricas de vaidade. Vazamento 3: a lição que ninguém teve coragem de registrar.O maior dos três. A pesquisadora Amy Edmondson, estudando equipes hospitalares, encontrou um paradoxo instrutivo: as melhores equipes reportavam mais erros, não porque erravam mais, mas porque tinham segurança psicológica para admitir. Sem ela, o erro existe do mesmo jeito; só a informação sobre ele morre. Empresa que pune o portador de má notícia está pagando pela coleta de dados e queimando o resultado: o experimento fracassado vira “sucesso parcial” no slide (artigo A ética de quem pergunta), o sinal de crise fica engavetado (artigo Gestão de crise guiada por pesquisa), a pesquisa interna mente (artigo O elo colaborador-cliente). Cultura não é o pôster na parede; é o que acontece com a próxima pessoa que traz um dado inconveniente. O ciclo completo (a série inteira em um parágrafo) Juntando as peças, o desenho da empresa que aprende é o método científico institucionalizado: a escuta contínua observa (Anatomia de uma boa pergunta, O momento da verdade, Escala Likert, CSAT, CES e NPS); a estatística honesta separa sinal de ruído (Amostra, Média mente, Regressão à média, Diferença real ou ruído?); os ritos julgam padrões e disparam apostas (Rituais de gestão, Priorização de melhorias); as apostas viram experimentos com critério (Experimentos internos, Pesquisa e inovação); os resultados, inclusive os fracassos, viram registro consultável (Gestão de crise guiada por pesquisa e este artigo); e o registro muda processos, metas e o próprio radar (O ciclo fechado, Voz do Cliente, Metas de satisfação bem desenhadas). O ciclo roda protegido por duas guardiãs: a ética com dados e pessoas (A ética de quem pergunta, O elo colaborador-cliente) e as métricas com guardiã (Métricas de vaidade, Metas de satisfação bem desenhadas). Cada volta completa, a empresa fica um pouco mais difícil de enganar, inclusive por ela mesma. Feynman, que inspirou esta série, fecharia assim: o primeiro princípio continua sendo não enganar a si mesmo. Uma empresa inteira operando esse princípio, com método e sem cinismo, é o que esta série tentou descrever, artigo por artigo. O teste de maturidade final (para a própria empresa) Seis perguntas, uma auditoria de aprendizado institucional em dez minutos: Não existe nota de corte: existe direção. Cada “sim” a mais é uma volta do ciclo girando um pouco melhor. De volta à Camélia Na Camélia, o déjà-vu da Regina virou inventário: quantas outras soluções a casa tinha comprado e perdido? A resposta institucional atacou os três vazamentos de uma vez: registro (toda solução que funciona vira ficha curta: problema, o que fizemos, o que mediu), dono
Priorização de melhorias: o que consertar primeiro quando tudo parece urgente
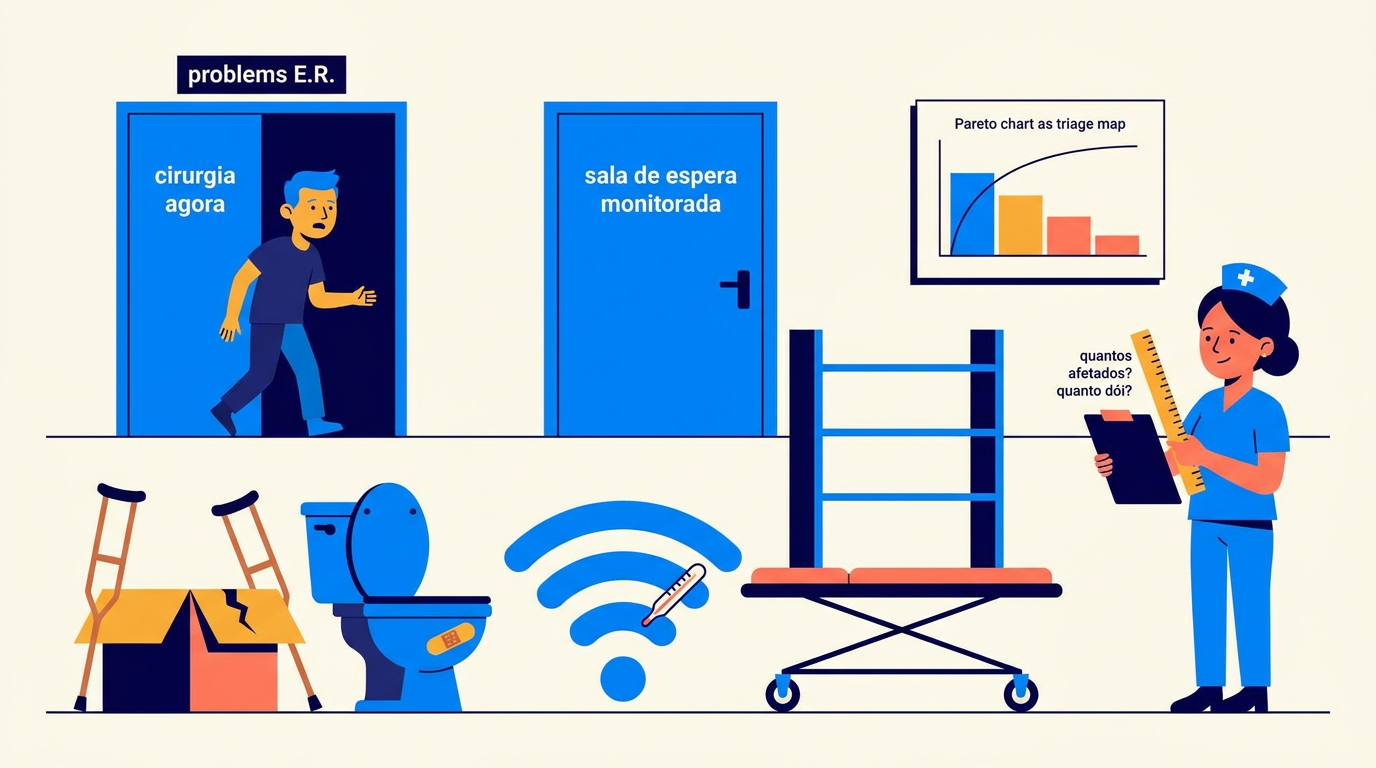
A lista de problemas sempre será maior que o orçamento. Priorizar é a decisão de gestão mais frequente que a pesquisa alimenta. Veja como fazer a priorização de melhorias sem virar um leilão de vieses. No Hotel Cambará Depois do semestre mais ouvido da história do Hotel Cambará, a parede da sala de reuniões virou um mural de post-its: quarenta melhorias apontadas pelos dados, uma ao lado da outra. Colchões do anexo, wi-fi do terceiro andar, fila do check-in, café da manhã que acaba cedo, estacionamento: quarenta soldados enfileirados. O efeito foi o contrário do pretendido. Nas três reuniões seguintes, a parede paralisou o hotel: tudo parecia urgente, começar por qualquer um parecia injusto com os outros trinta e nove, e a discussão recomeçava do zero a cada encontro. Otávio, o gerente-geral, resumiu o estado das coisas: — A gente descobriu quarenta problemas e criou o quadragésimo primeiro: essa parede. Ninguém sai daqui hoje até ela virar uma fila. O luxo de ter problemas demais Um programa de escuta funcionando produz um efeito colateral previsível: uma fila de problemas conhecidos maior que a capacidade de resolver. Fila no caixa, banheiro, estacionamento, ruptura de estoque, wi-fi, temperatura, um atendente específico… Qual primeiro? Sem método, a fila é furada pelos critérios de sempre: o problema mais recente (viés de recência), o mais dramático (disponibilidade), o do cliente que gritou mais alto (a amostra de um), ou o favorito do diretor (efeito halo hierárquico; no jargão de produto, o HiPPO, highest paid person’s opinion: a opinião de quem ganha mais decide). Este artigo organiza os métodos que substituem esse leilão de vieses. Ferramenta 1: o princípio de Pareto (a triagem) A observação empírica mais rentável da gestão de qualidade: os problemas não se distribuem uniformemente: poucas causas concentram a maioria das ocorrências. Joseph Juran, um dos pais do movimento da qualidade, batizou o padrão de princípio de Pareto (os “poucos vitais contra os muitos triviais”) e o transformou em ferramenta: ordene as categorias de problema por frequência e olhe a concentração. Tipicamente, 2 ou 3 categorias respondem por 60–80% das ocorrências. Na prática: as categorias dos comentários e das perguntas-diagnóstico (artigos As cinco dimensões da qualidade de serviço, Banco de 50 perguntas de satisfação e Quali e quanti) empilhadas num gráfico de barras ordenado. Trinta segundos de leitura e a fila de dez problemas vira uma triagem: os 2–3 vitais, e o resto. Duas ressalvas de série: confira se a concentração não é artefato de categoria larga demais (“atendimento” engole tudo; abra em subcategorias antes de concluir), e lembre que frequência de menção depende de quem responde (artigos Amostra e Quali e quanti). Ferramenta 2: frequência × impacto (a matriz que corrige o Pareto) Pareto ordena por volume, mas nem toda ocorrência pesa igual. A ruptura de estoque pode ser menos citada que a fila e ainda assim derrubar mais nota por ocorrência. A correção é cruzar dois eixos: O cruzamento gera a matriz com quatro cantos que se explicam sozinhos: frequente e grave (prioridade absoluta), raro e grave (previna e prepare a recuperação; artigo O ciclo fechado), frequente e leve (irritantes de escala: baratos de consertar costumam pagar bem), raro e leve (fila de espera). O refinamento fino vem do modelo Kano (spoiler do artigo Pesquisa e inovação): consertar básicos quebrados vale mais que polir encantamentos: a ausência de básico destrói mais nota do que o encanto constrói. Ferramenta 3: o ICE (o desempate executável) Impacto sozinho ignora o custo de agir. Para ordenar a fila final, o desempate prático (apresentado em Experimentos internos): ICE: Impacto (quanto move a experiência/o dinheiro; artigo O caso financeiro da satisfação), Confiança (que evidência sustenta a estimativa? A escada do artigo Achismo, opinião e evidência vira nota) e Esforço (custo, tempo, complexidade). Ranqueie, ataque do topo, e trate as notas como hipóteses: o piloto pequeno (artigo Experimentos internos) antes do rollout é o teste da nota de confiança. O fluxo completo da priorização de melhorias Repare no que o fluxo institucionaliza: a passagem do dado à decisão sem passar pelo leilão de vieses: cada etapa tem critério explícito que qualquer pessoa da equipe pode auditar (artigo A ética de quem pergunta: transparência) e desafiar (artigo Achismo, opinião e evidência: pelo degrau da evidência em vez do cargo). As quatro armadilhas da priorização Consertar o que é fácil em vez do que importa. O ICE mal usado degenera nisso: esforço baixo dominando a conta. Antídoto: impacto e esforço em colunas separadas e visíveis; “rápido e inútil” não pode se disfarçar de prioridade. Priorizar pela última reunião. A fila que muda a cada semana não é fila, é humor. A fila se revisa no rito mensal (artigo Rituais de gestão), com dado novo, e não a cada comentário forte (artigo Coincidências acontecem: rajada abre uma pergunta, sem valer como veredito). Atacar a fila inteira de uma vez. A lição central de As 4 Disciplinas da Execução (McChesney, Covey e Huling): o inimigo da execução não é a falta de plano, é o “vendaval”, o dia a dia operacional que consome toda a energia da equipe e devora as iniciativas de melhoria uma a uma. A fila mais bem ranqueada do mundo morre se virar oito frentes simultâneas: quem está imerso na operação executa uma ou duas melhorias por vez, com começo, meio e verificação, antes de puxar a próxima. Priorizar não é só ordenar a fila; é ter a disciplina de deixar o resto dela esperando. Esquecer o problema raro e catastrófico. Pareto é cego para o que quase não acontece mas destrói (a intoxicação, o vazamento, o episódio viral). Esses não disputam a fila de frequência: têm fila própria, de prevenção e preparo, assunto do artigo Gestão de crise guiada por pesquisa. De volta ao Cambará No Cambará, a parede virou fila em uma tarde, com três ferramentas em sequência. O Pareto triou: seis post-its concentravam 70% das reclamações. A matriz de frequência e impacto separou, desses seis, o que doía muito do que só acontecia
Metas de satisfação bem desenhadas: ambição sem maquiagem
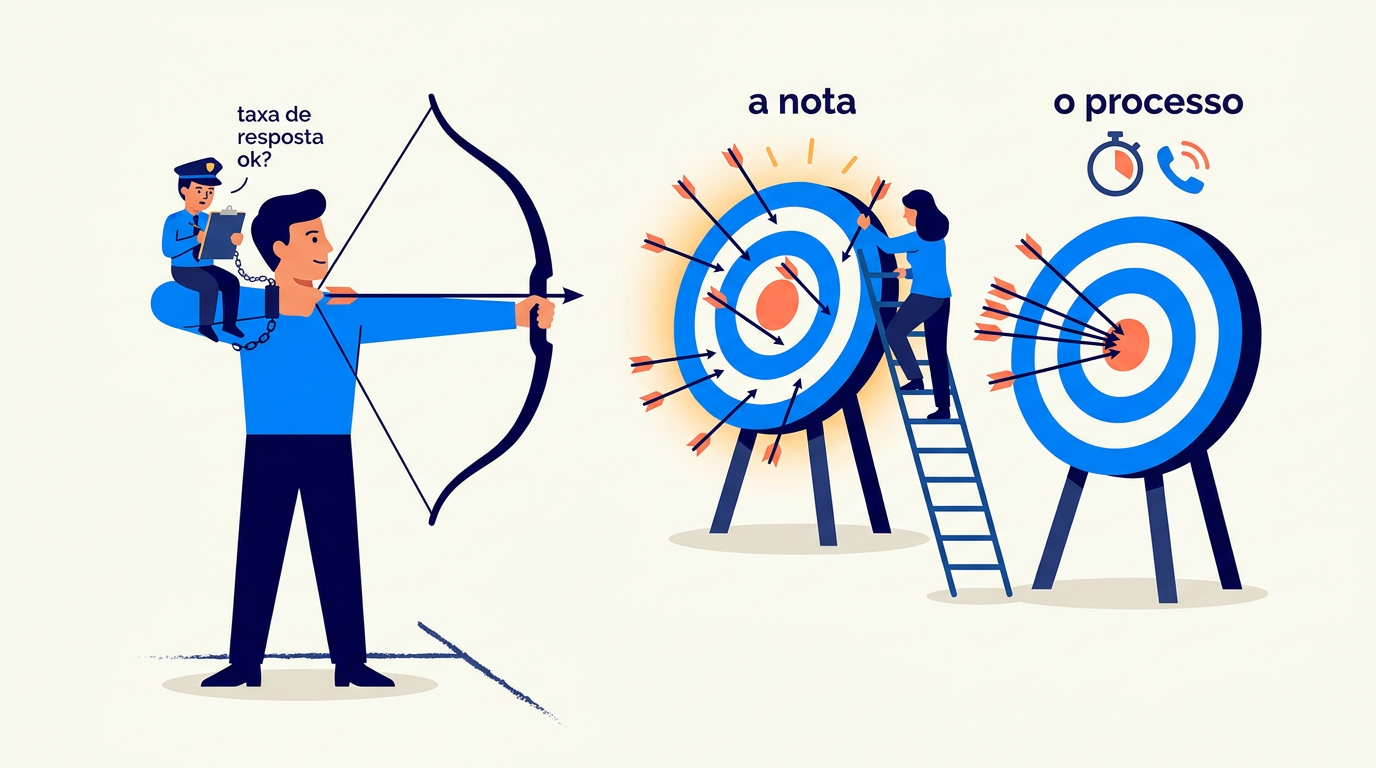
A meta errada não melhora a experiência; ensina a equipe a melhorar o número. Veja como desenhar metas de satisfação sem maquiagem. Nas Lojas Andorinha Na visita de rotina à loja do Centro das Lojas Andorinha, rede de moda com trinta lojas, Sônia, a diretora de operações, notou o detalhe na sala da equipe: o quadro da meta anual, “4,8 PARA TODAS AS LOJAS!”, anunciado com festa no kickoff de janeiro, estava virado para a parede. Igor, o gerente, não pediu desculpas; explicou, com a franqueza de março: — A gente partiu de 4,1. O pessoal fez a conta na segunda semana: não alcança nem com milagre. A loja do shopping partiu de 4,6 e vai bater andando. Mesma meta, corrida diferente. Meu time desistiu em fevereiro, e eu virei o quadro porque olhar para ele estava piorando o turno. Sônia anotou a cena no relatório com uma linha que doeu na diretoria: “a meta única, pensada para unir a rede, está produzindo desistência em metade dela”. O paradoxo das metas de satisfação Metas movem organizações. Locke e Latham, os pesquisadores por trás da teoria de metas que sustenta os OKRs, mostraram que metas específicas e desafiadoras superam o “faça o seu melhor”. Mas metas sobre métricas de percepção carregam um risco que metas de produção não têm: a nota pode ser melhorada sem melhorar aquilo que ela mede. É a Lei de Goodhart (artigos NPS sem mistério, A ética de quem pergunta e Métricas de vaidade) no seu habitat predileto, e a série já catalogou o bestiário: caça à nota no balcão, totem “esquecido” desligado no turno caótico, amostra purificada. A saída não é desistir de metas de satisfação, e sim desenhá-las com a estatística e as salvaguardas que esta série apresentou. Este artigo é o manual de desenho. Regra 1: linha de base antes de ambição Nenhuma meta antes de conhecer três números da série histórica (mínimo de 6–12 meses): Regra de bolso: a variação prometida na meta deve ser confortavelmente maior que o vaivém natural da métrica; senão ninguém saberá, nem no fim do período, se ela foi batida de verdade (artigo Diferença real ou ruído?). Regra 2: meta no processo, resultado no radar A distinção mais útil do desenho de metas: indicadores de resultado (NPS, CSAT: o placar) versus indicadores de direção (os processos que os produzem: tempo de fila, % de detratores contatados em 48h, taxa de resolução no primeiro contato). O placar tem duas fraquezas como meta: a equipe não o controla diretamente (ele mistura o esforço dela com mix, sazonalidade e acaso; artigos Regressão à média, Sazonalidade e séries temporais e Comparações justas), e é goodhartizável pela via da maquiagem. Os indicadores de direção são o oposto: controláveis, auditáveis, difíceis de falsificar sem melhorar de fato. O desenho maduro: metas duras nos indicadores de direção; o resultado como radar de validação (“se fizermos fila < 8min e ciclo fechado > 90%, o NPS deve subir; se não subir, nossa hipótese de direção está errada”; e isso é uma ficha de experimento, artigo Experimentos internos). Assim a cobrança recai sobre o que a equipe controla, e o placar mantém o papel de juiz honesto em vez de refém. A distinção tem canon próprio: é a segunda disciplina de As 4 Disciplinas da Execução (McChesney, Covey e Huling), que manda concentrar a energia da equipe nas medidas de direção justamente pelas duas qualidades que o placar não tem: são preditivas (movê-las move o resultado) e influenciáveis (a equipe consegue agir sobre elas nesta semana, não no fim do trimestre). O radar de validação acima é a aposta deles em formato de ficha: se a direção andar e o placar não seguir, a hipótese estava errada. Regra 3: toda meta nasce com a guardiã ao lado O par métrica + guardiã (artigo Métricas de vaidade) não é opcional em metas com bônus: E a auditoria de caminho (artigos Regressão à média e Diferença real ou ruído?) institucionalizada: salto abrupto de métrica com bônus atrelado dispara investigação antes de comemoração: regra anunciada com antecedência e aplicada sem drama, o que protege os honestos. Regra 4: o alvo certo depende da distribuição Dois refinamentos que a estatística da série entrega de graça: Mova a distribuição, não a média. “Subir a média de 4,3 para 4,5” é meta cega (artigos Média mente e O formato dos dados: a média comprimida no teto esconde onde está o jogo). Metas melhores miram as pontas: reduzir % de notas baixas (ataca causas de detração e o custo, artigo O caso financeiro da satisfação) ou converter neutros em promotores (artigo NPS sem mistério). Cada uma pede ações diferentes; a meta de média não pede nenhuma em particular. Percentil para experiência, média para custo. Em métricas de cauda longa (espera, resolução; artigo O formato dos dados), a meta honesta é de percentil: “p90 da fila abaixo de 10 minutos”. A meta de média convive alegremente com desastres individuais semanais. Regra 5: metas relativas a si mesmo, não ranking absoluto O ranking único de rede (“as 10 piores lojas do trimestre”) tropeça em tudo que o artigo Comparações justas catalogou: mix, porte, base pequena nos extremos, e em regressão à média (artigo Regressão à média: o “programa das piores” sempre parecerá funcionar). Desenhos mais justos: melhoria contra a própria linha de base (cada loja contra sua história, na mesma janela sazonal), ou ligas de comparáveis. Efeito colateral valioso: elimina a desculpa estrutural (“minha loja é diferente”) e o desânimo do fundo da tabela. O checklist de aprovação de uma meta de experiência Antes de qualquer meta ir para o contrato ou para o bônus: Com sete “sims”, a meta melhora a empresa; com menos, ela tende a melhorar apenas o número. De volta à Andorinha Na Andorinha, as metas do semestre seguinte nasceram de outro jeito: linha de base primeiro (cada loja contra a própria história), ambição em cima do controlável (meta no processo: tempo de resposta aos casos, causas atacadas, fila do caixa)
Rituais de gestão: a cadência que transforma dado em decisão
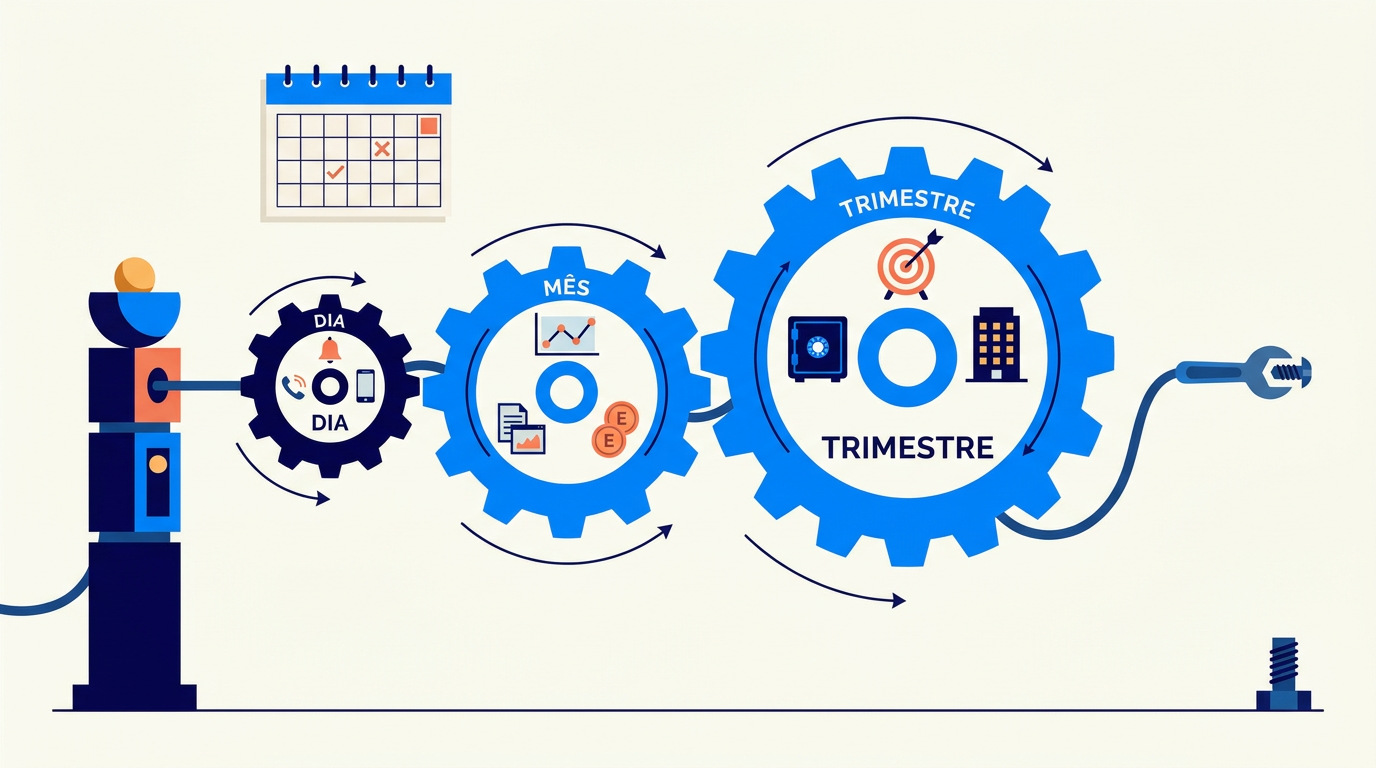
Dashboard não gerencia nada. Quem gerencia é a reunião que olha para ele, se ela existir, tiver dono e acabar em ação. São os rituais de gestão que fazem o dado virar ação. No Sabor Central O relatório que estragou o café da manhã de Nelson, diretor de contratos do Sabor Central, empresa de refeições coletivas, não falava de comensais: falava de acessos. O dashboard dos contratos, orgulho da empresa, bonito de doer, tinha sido aberto 7 vezes no mês inteiro. Quatro delas pela própria equipe que o mantém. Enquanto isso, as reclamações urgentes da semana eram discutidas na reunião mensal, mortas de velhas, e as tendências de fundo apareciam em conversas de corredor, vivas e sem dono. O dado existia, a ferramenta existia, a boa vontade existia. O que não existia era hora marcada: nenhuma reunião da empresa tinha o painel como pauta, então o painel não tinha plateia. — A gente construiu um sino ótimo — resumiu Paula, a nutricionista-chefe — e esqueceu de combinar quando ele toca. O elo perdido dos rituais de gestão Entre o dado coletado e a empresa transformada existe um elo que quase nunca aparece nos diagramas: a agenda. Literalmente: as reuniões, os horários, os nomes na sala. Informação só vira gestão quando tem um encontro marcado com uma decisão. A ciência da qualidade formalizou isso nos anos 1950: o ciclo PDCA de Deming (planejar → executar → verificar → agir) só roda se o “verificar” tiver hora marcada. Empresas com programas de escuta excelentes no papel fracassam neste elo: o dado chega, e não há rito que o consuma. Este artigo desenha a cadência mínima: três ritmos, cada um com sua alçada, todos governados pelo mesmo princípio. E vale enfrentar de frente o preconceito da moda: reunião não é o inimigo. Andy Grove, que comandou a Intel com mentalidade de engenheiro de produção, deu a essa tese sua formulação mais direta em High Output Management: a reunião é o meio pelo qual o trabalho de gestão acontece, e a pergunta certa nunca é “ter ou não ter reuniões”, e sim se cada uma tem formato, papel e cadência certos. A distinção dele organiza este artigo: reuniões de processo (regulares, que consomem informação em ritmo previsível) e reuniões de missão (pontuais, convocadas para produzir uma decisão específica). Os três rituais de gestão a seguir são reuniões de processo; a revisão de operações que Grove rodava na Intel é o ancestral direto do Ritual 2. O princípio: cada ritmo olha uma coisa diferente O erro universal das reuniões com dados é todas olharem o mesmo número do mesmo jeito: tipicamente, a diretoria discutindo o caso individual de terça-feira e o gerente tentando explicar a tendência trimestral. A divisão correta segue a estatística da série: Misturar as camadas produz os dois patológicos clássicos: a diretoria “tampering” em ruído diário (artigo Sazonalidade e séries temporais; Deming avisou) e a operação anestesiada para a tendência lenta que ninguém tem mandato de discutir. Ritual 1 — O semáforo diário (loja, 10 minutos) Quem: gerente da unidade com a equipe do turno. Olha: os alertas de ontem: detratores a contatar (com prazo, artigo O ciclo fechado), comentários abertos do dia, o número do dia contra o dia equivalente (terça com terça, artigo Sazonalidade e séries temporais). As três perguntas do rito: algum cliente precisa de resposta hoje? Algum comentário aponta algo consertável agora (o freezer, a fila das 12h)? Algo a escalar para cima? O placar do rito é o do jogador, não o do técnico. A observação é de As 4 Disciplinas da Execução (McChesney, Covey e Huling): equipe se engaja quando marca os próprios pontos num placar simples, visível e atualizado por ela mesma (os detratores de ontem, os contatos feitos, o número do dia contra a terça passada). O dashboard completo, com vinte recortes, é ferramenta da matriz; no turno, ele anestesia em vez de mobilizar. O que NÃO fazer: discutir tendência com dado de um dia (artigo Amostra: 8 respostas não são pesquisa) ou premiar/cobrar pelo número diário (artigo Regressão à média: o vaivém fabrica heróis e culpados por sorteio). Ritual 2 — A revisão de padrões (regional/processo, mensal, 1 hora) A reunião mais importante do sistema, e a mais malfeita do mundo corporativo. Quem: dono do processo com gerentes das unidades. Olha: séries com contexto sazonal (YoY, médias móveis; artigo Sazonalidade e séries temporais), distribuição além da média (artigos Média mente e O formato dos dados), categorias dos comentários (artigos As cinco dimensões da qualidade de serviço e Quali e quanti), o funil do ciclo fechado (% de detratores contatados em 48h; artigo O ciclo fechado). As regras de ouro desta reunião, destiladas da série inteira: Ritual 3 — A revisão estratégica (diretoria, trimestral) Olha: tendências longas contra metas (artigo Metas de satisfação bem desenhadas), o caso financeiro em atualização (artigo O caso financeiro da satisfação: casos fechados e valor capturado), decisões de investimento que a escuta está pedindo (a obra, o sistema, o quadro de pessoal), e a saúde do próprio programa (taxa de resposta, cobertura, integridade; os pares métrica + guardiã do artigo Métricas de vaidade). É aqui que a voz do cliente disputa orçamento de igual para igual, o estágio 3 de maturidade do artigo Voz do Cliente. Se o cliente só é citado nas reuniões “de CX”, o programa parou no estágio 2. A liturgia comum dos rituais de gestão (o que vale para os três ritos) Comece pelo cliente, literalmente. Um comentário verbatim (artigo Quali e quanti) ou uma ligação de recuperação da semana abre a reunião. Não é cerimônia: é o antídoto contra a abstração, porque número anestesia e história mobiliza (artigo Data storytelling). Proibido debate de achismo em assunto mensurável. A escada do artigo Achismo, opinião e evidência pendurada na parede: “em que degrau está essa afirmação?” é pergunta legítima de qualquer participante para qualquer participante, inclusive para o chefe. Ata de decisões, não de discussões. O registro que importa: o que decidimos, quem faz, até
O caso financeiro da satisfação: quanto vale um ponto de NPS?
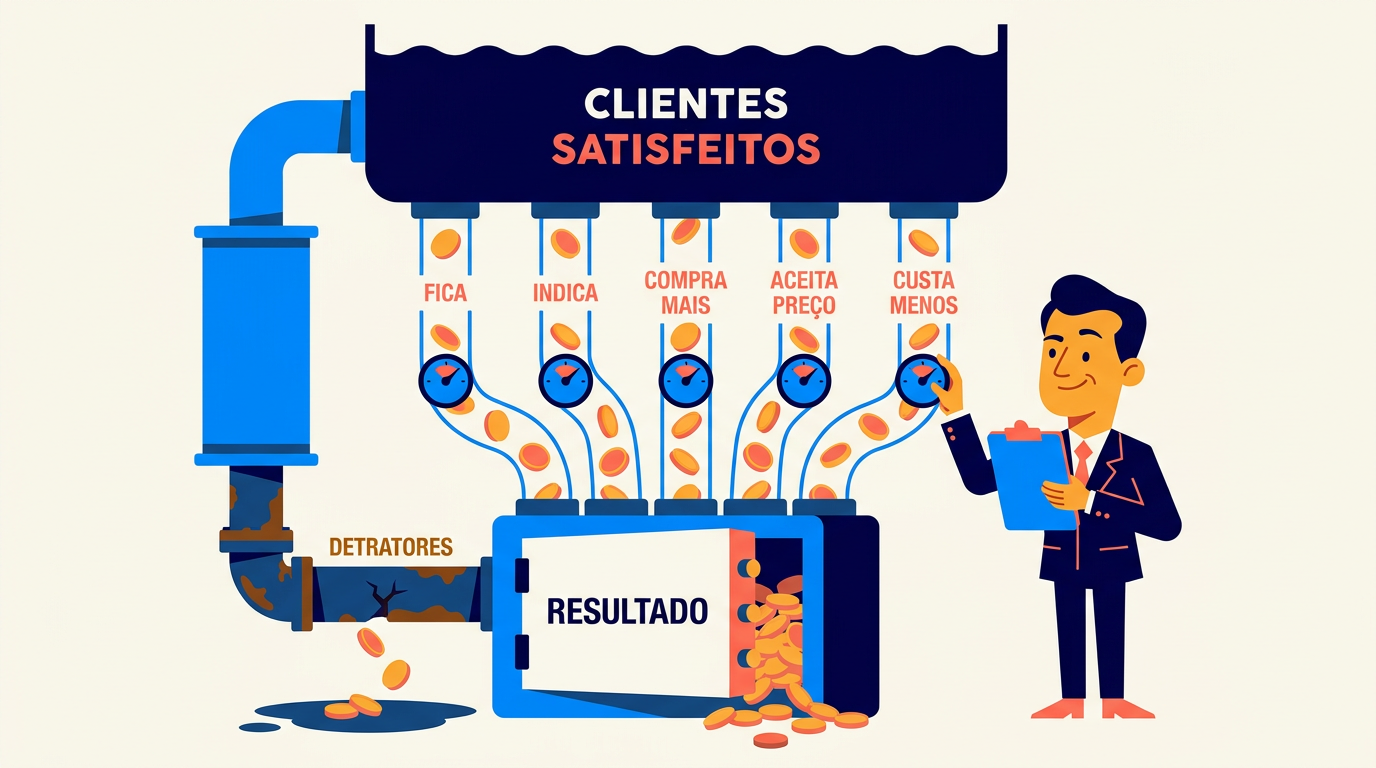
Experiência do cliente não é “coisa boa de se fazer”: é uma tese de investimento. E teses se defendem com números. Este é o caso financeiro da satisfação. Na Academia Ritmo Na reunião de orçamento da Academia Ritmo, rede de academias com três unidades, o contador chegou com a planilha anual e uma linha marcada em amarelo: “pesquisa de satisfação”. A proposta era educada e letal: cortar 60%. “É a linha mais fácil: não fecha unidade, não demite professor. E, com respeito, não consigo apontar o retorno.” Fábio, o dono, começou a responder com convicção e parou no meio da frase, com uma honestidade rara: a convicção era dele, mas a conta não existia. Em anos de pesquisa, a academia nunca tinha montado o caminho do dinheiro: quanto vale o aluno que fica mais um ano, o que traz o amigo, o que migra para o plano anual, o que custa menos atender. — Me dá noventa dias — disse ele. — Se a conta não fechar, o corte é seu. Se fechar, a linha amarela vira investimento no seu relatório. A pergunta do CFO: onde está o caso financeiro? Toda iniciativa de experiência do cliente eventualmente encontra a pergunta que a define: “e isso dá quanto de retorno?” Times de CX que respondem com adjetivos (“fideliza!”, “encanta!”) perdem o orçamento para quem responde com contas. A boa notícia: as contas existem, a evidência acumulada é farta, e o raciocínio cabe neste artigo. A má notícia (que é boa notícia para quem faz direito): o elo satisfação → dinheiro depende de mecanismos específicos e nada automáticos. Conhecer esses mecanismos é o que separa o caso financeiro sério do slide de motivação. A evidência de fundo: satisfação prevê resultado O elo agregado está bem documentado. O ACSI (The American Customer Satisfaction Index) permitiu testar a relação em escala: estudos liderados por Claes Fornell e colegas mostraram que empresas com satisfação consistentemente alta entregam retornos financeiros e de mercado superiores, e carteiras montadas com as líderes de satisfação bateram o mercado em horizontes longos (Fornell et al., Journal of Marketing, 2006; Anderson, Fornell e Mazvancheryl, 2004, documentaram a associação entre satisfação e valor ao acionista). Cautela metodológica de praxe (veja Diferença real ou ruído?): correlação em painel não é cheque em branco causal: empresas bem geridas tendem a ter clientes satisfeitos e bons resultados. Mas os mecanismos que ligam uma coisa à outra são observáveis, testáveis dentro de casa, e é neles que a gestão trabalha. Os cinco mecanismos (onde a satisfação vira dinheiro) 1. Retenção: o cliente que não foi embora.O mecanismo mais estudado. Reichheld e Sasser publicaram na HBR, em 1990, a análise clássica: pequenas melhorias na retenção têm efeitos desproporcionais no lucro, porque cliente retido dilui custo de aquisição, tende a comprar mais com o tempo e custa menos para servir. A conta local: qual o valor médio de um cliente/ano × quantos detratores viram ex-clientes × quantos a recuperação salva (artigo O ciclo fechado: o ciclo interno tem ROI direto por aqui). 2. Boca a boca: o marketing que a operação fabrica.Promotores indicam; detratores desindicam, com alcance assimétrico (a reclamação viaja mais). O custo de aquisição evitado por indicação é mensurável: pergunte “como nos conheceu?” (pergunta 41 do banco, artigo Banco de 50 perguntas de satisfação) e acompanhe a fração “indicação” ao longo do tempo contra a evolução do NPS. 3. Carteira: o cliente satisfeito compra mais.Frequência, tíquete, categorias adicionais. O teste interno é o cruzamento (com os cuidados que toda correlação exige): clientes promotores gastam mais depois de virarem promotores? A ordem temporal ajuda a separar causa de seleção. O quarto mecanismo é o preço, e ele funciona porque a satisfação compra tolerância. Clientes satisfeitos aceitam reajustes com menos evasão, ou seja, a elasticidade-preço cai com a lealdade. Em tempos de inflação de custos, isso vira o colchão que amortece o repasse. O quinto costuma ser esquecido: a operação que erra menos gasta menos. Insatisfação custa caro para dentro, em retrabalho, trocas, compensações, tempo de gestão apagando incêndio e rotatividade de equipe exausta (artigo O elo colaborador-cliente). Reduzir a causa-raiz dos detratores (ciclo externo, artigo O ciclo fechado) é projeto de redução de custo tanto quanto de receita. Montando o caso na prática: a árvore do ROI O caso financeiro de um programa (ou de uma melhoria específica) se monta em quatro passos, todos com ferramentas já apresentadas na série: E o teste contínuo do programa: decisões que mudaram por causa da escuta, com valor estimado. O portfólio de “casos fechados” vale mais que qualquer correlação de slide. As duas armadilhas do caso financeiro A promessa linear. “Cada ponto de NPS vale R$ X” é retórica perigosa: a relação não é linear (sair de 20 para 30 ≠ sair de 70 para 80), varia por setor e por mecanismo dominante, e vira meta goodhartizável na hora (artigos NPS sem mistério e Métricas de vaidade). Prefira sempre a versão por mecanismo: “reduzir detratores de fila em 30% vale ~R$ X em retenção”. O elo invertido no tempo. Resultado financeiro também melhora satisfação (empresa lucrativa investe mais em loja, gente e estoque), a flecha de mão dupla da causalidade. Por isso o caso sério se constrói com experimentos e casos fechados (mudança → movimento medido → resultado), não só com correlações de painel. De volta à Ritmo Na Ritmo, os noventa dias renderam a árvore que faltava: retenção (alunos em risco recuperados pelo ciclo fechado, multiplicados pela mensalidade anual), indicação (matrículas que chegavam com “vim porque me falaram”), carteira (migrações para o plano anual entre os satisfeitos), preço (o reajuste testado que não gerou êxodo) e custo (menos cancelamento, menos negociação de última hora na recepção). Premissas conservadoras, tudo auditável pelo contador, que ajudou a montar. A conta fechou com folga, e a linha amarela mudou de nome no orçamento seguinte, assinada por ele: de “pesquisa (despesa)” para “sistema de escuta (retenção de receita)”. Fábio guardou a lição: “o financeiro não compra fé; compra fluxo. E fluxo se
Como um gráfico mente: manual de defesa visual
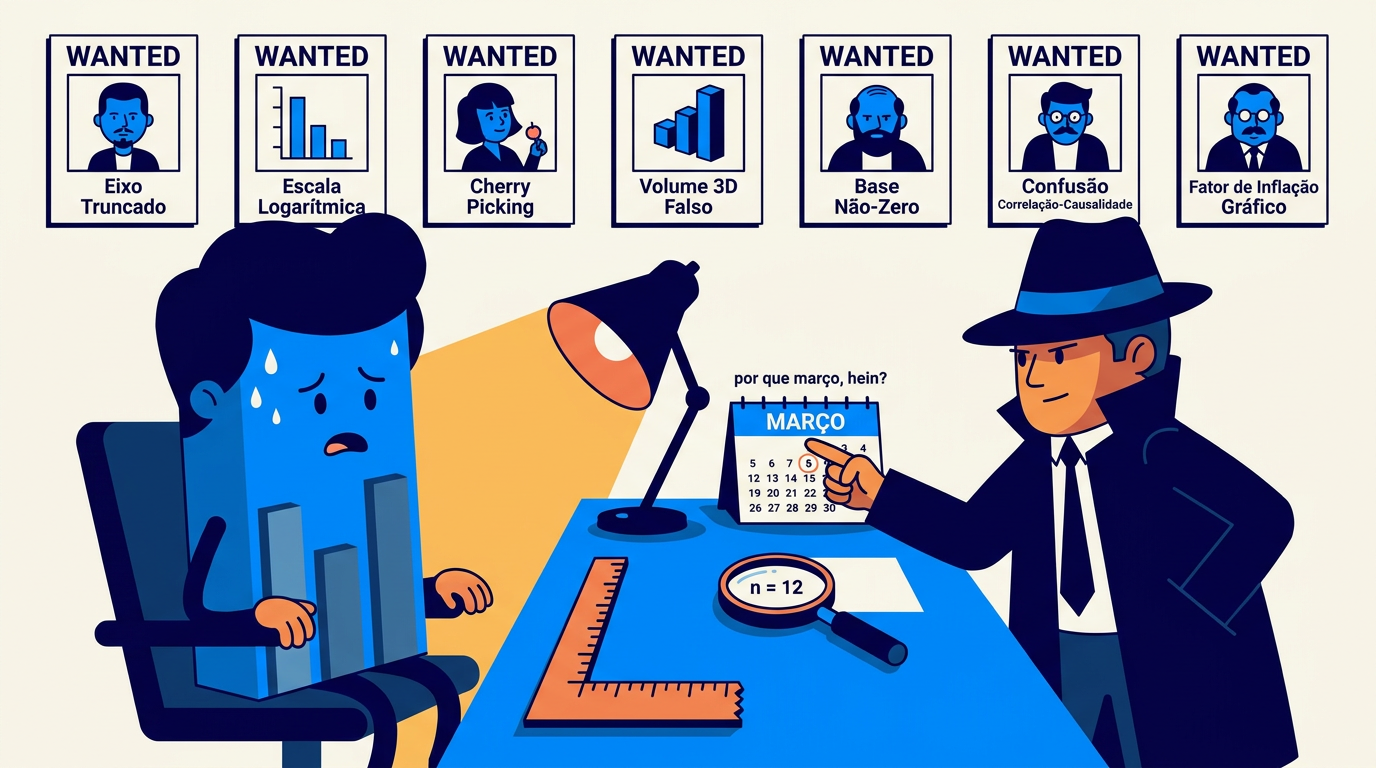
Um gráfico enganoso pode estar 100% correto nos números e ainda assim mentir com a imagem. Aprenda a revistar os dois. Nas Lojas Andorinha O fornecedor de sistemas de fila chegou às Lojas Andorinha, rede de moda com trinta lojas, com uma proposta cara e um gráfico irresistível: a “explosão de conversão” de um cliente após adotar a solução, uma linha subindo como foguete. Metade da sala já fazia contas de instalação. Igor, gerente da loja do Centro, pediu licença, papel e régua. Refez o gráfico à mão, com o eixo começando no zero. O foguete pousou: a subida era de 4,31 para 4,42 em oito meses, um décimo honesto esticado por um eixo que começava em 4,25 e por uma janela que, por coincidência, abria exatamente no pior mês do cliente. — O número de vocês pode até ser bom — disse ele, virando o papel para o vendedor. — Mas o desenho está fazendo hora extra. O gráfico enganoso: a mentira que não precisa de números falsos O artigo Data storytelling ensinou a construir gráficos honestos. Este é o espelho: como ler os gráficos dos outros (relatórios de fornecedores, benchmarks de mercado, posts virais, propostas) com colete à prova de retórica visual. A premissa desconfortável: a maioria dos gráficos enganosos usa dados verdadeiros. A distorção mora nas escolhas visuais: eixo, escala, área, recorte, cor. Edward Tufte deu nome ao fenômeno nos anos 1980 e até propôs medi-lo (o “fator de mentira”: a razão entre o tamanho do efeito na imagem e o tamanho do efeito nos dados). Alberto Cairo, professor de visualização, escreveu o manual moderno do tema com um título que serve de lema: How Charts Lie. Eis as sete técnicas mais comuns, com o antídoto de cada uma. 1. O eixo Y truncado: o drama fabricado O clássico absoluto. A satisfação foi de 4,20 para 4,26, mas o eixo começa em 4,18, e a segunda barra fica quatro vezes tão alta quanto a primeira. Variação de 1,4% vira paredão visual. Antídoto: procure o zero do eixo (em gráficos de barra, ele é obrigatório: a barra codifica valor pela altura total). Em gráficos de linha, eixo cortado é aceitável para mostrar detalhe, desde que sinalizado. A pergunta-reflexo: “quanto isso mudou em números, mesmo?” E a régua do artigo Diferença real ou ruído?: essa mudança supera o ruído? Exemplo com dados fictícios. O aumento é de 0,06 ponto. Com a base em 4,18, a altura visível passa de 0,02 para 0,08: quatro vezes maior. 2. O duplo eixo: a correlação encomendada Duas linhas, duas escalas (uma à esquerda, outra à direita), calibradas para as curvas dançarem juntas. Com liberdade para escolher as duas escalas, quase qualquer par de séries “se acompanha”. É o gerador visual de correlações espúrias (o clássico das correlações espúrias, que “sincroniza” filmes de Nicolas Cage com afogamentos em piscinas, era exatamente isso). Antídoto: desconfie por padrão de eixos duplos; pergunte como ficaria cada série normalizada (variação %, base 100). Quem tem um caso sólido raramente precisa desse recurso. Exemplo com dados fictícios. À esquerda, as escalas fazem as curvas coincidir. À direita, a base comum revela aumentos de 6% e 60%; a coincidência visual não demonstra causalidade. 3. Área e volume: o exagero quadrático Para mostrar que B é o dobro de A, o designer desenha um círculo com o dobro do raio, que tem quatro vezes a área. Pictogramas que crescem em altura e largura, bolhas, moedas empilhadas em 3D: o olho lê área/volume, e a diferença real sai inflada ao quadrado (ou ao cubo). A defesa é lembrar que diferenças quantitativas se leem com segurança em comprimento (barras), não em área. Bolha bonita é para impressão geral; decisão pede barra. Exemplo com dados fictícios. Os dados dobram, mas a área do círculo quadruplica. As barras mostram a proporção correta. 4. O recorte temporal conveniente “Crescimento impressionante desde março!” E março foi o fundo do poço (escolhido a dedo). Toda série tem um ponto de partida que conta a história desejada; quem corta a janela escolhe a manchete. É a versão gráfica da regressão à média (Regressão à média) e da sazonalidade ignorada (Sazonalidade e séries temporais: comparar dezembro com janeiro em vez de dezembro com dezembro). Antídoto: peça a série mais longa (“como está contra o mesmo período do ano passado? e nos últimos 3 anos?”) e desconfie de janelas que começam em vales ou picos. Exemplo com dados fictícios. De março a junho, as vendas crescem 60%. Incluindo janeiro, o saldo até junho é uma queda de 20%. 5. O acumulado que nunca desce A escada rolante do artigo Métricas de vaidade em forma de gráfico: “total acumulado” sobe para sempre, mesmo com o negócio encolhendo. Primo dele: o gráfico de “crescimento do crescimento” (mostra a taxa, esconde que a taxa está caindo). Nos dois casos, peça a métrica por período, ou seja, novos por mês em vez de total desde a fundação. Se o apresentador resistir, você já sabe por quê. Exemplo com dados fictícios. O acumulado chega a 300 clientes, enquanto a aquisição mensal cai de 100 para 20. São os mesmos dados, respondendo a perguntas diferentes. 6. A escala e o mapa que distorcem Escalas logarítmicas apresentadas sem aviso (achatam explosões e dramatizam começos); mapas onde área geográfica vira proxy de importância (municípios enormes e vazios dominam a tela, o “problema do mapa eleitoral”); cores escolhidas para alarmar (vermelho para variação de 0,1). Antídoto: leia a legenda e a escala antes do desenho. São os 5 segundos mais rentáveis da leitura de qualquer gráfico. E lembre-se de que cor não é dado: é editorial. Exemplo com dados fictícios. Este exemplo ilustra a escolha da escala: distâncias iguais no eixo logarítmico representam multiplicações, não acréscimos iguais. A escala logarítmica é válida, mas precisa ser identificada. 7. O gráfico sem contexto de incerteza Barras comparando lojas com 30 respostas cada, sem margem de erro; linhas de “tendência” traçadas sobre 3 pontos; o ranking em que o 1º e o
Coincidências acontecem: a lei dos números muito grandes
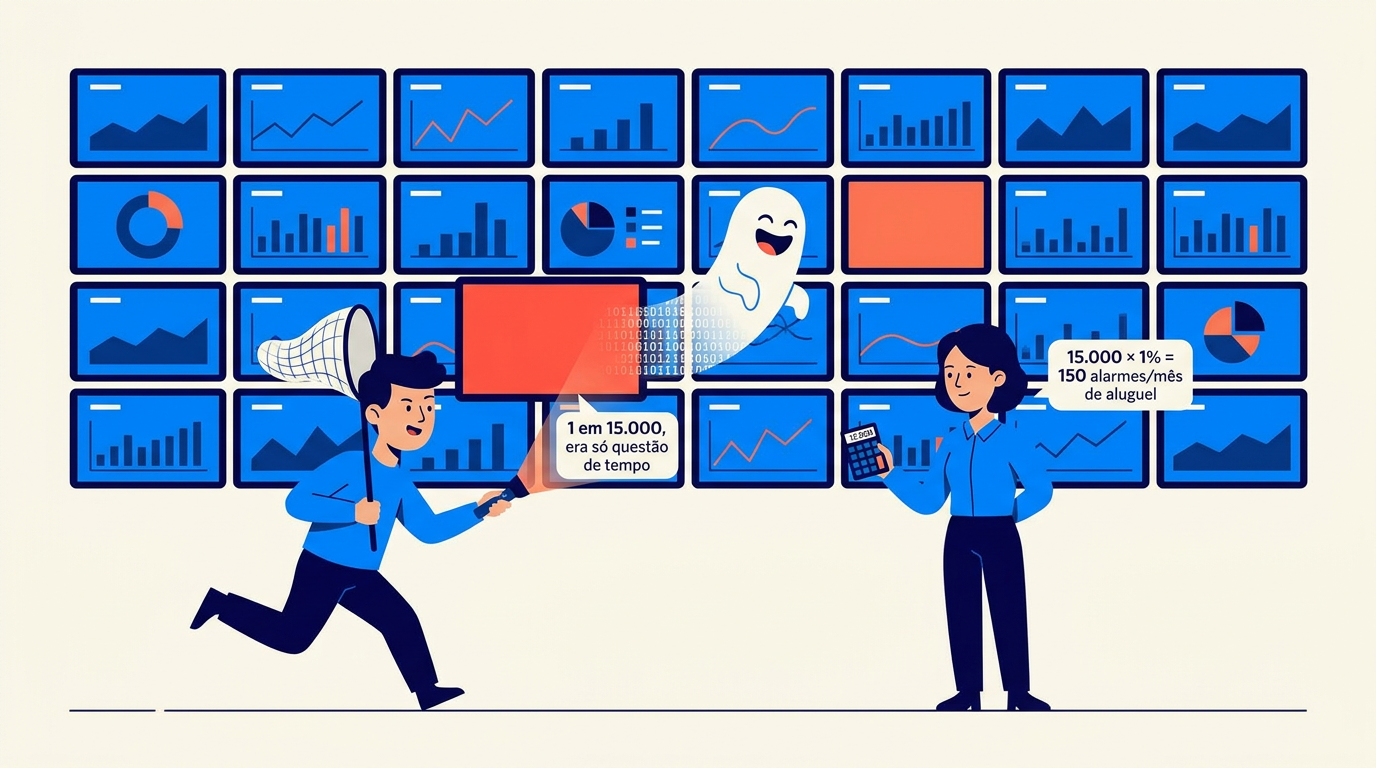
Com tentativas suficientes, o improvável vira rotina, e o cérebro humano vira caçador de fantasmas. É a lei dos números muito grandes em ação. No Supermercado Farol O painel novo do Supermercado Farol, rede com cinco lojas, cruzava tudo com tudo: nota por dia da semana, por clima, por horário, por seção, por loja. Foi lá que Caio, o gerente da loja principal, garimpou o achado que anunciou por e-mail com assunto em caixa alta: “DESCOBERTA: terças-feiras de chuva têm nota 0,4 acima da média!”. Já havia até esboço de plano: promoção de dia de chuva, para surfar o fenômeno. A analista da rede respondeu com uma conta em vez de uma opinião. Entre cortes e combinações, o painel oferecia alguns milhares de cruzamentos possíveis. Em milhares de tentativas, o acaso não é um risco: é uma fábrica. Alguma “terça chuvosa” sempre aparece, como num caça-níquel de alavanca puxada o dia inteiro: de vez em quando três limões se alinham, e ninguém chama de milagre. O milagre estatisticamente obrigatório: a lei dos números muito grandes Qual a chance de alguém ganhar na loteria duas vezes? Praticamente nula, para você. Mas para alguém, em algum lugar, algum dia? Quase certa. Milhões de pessoas jogando, semana após semana, ano após ano: em algum ponto, o “milagre” é aritmeticamente inevitável, e sempre vira notícia, porque noticiamos o ganhador, nunca os milhões de não ganhadores ao lado dele. Os estatísticos Persi Diaconis e Frederick Mosteller, num artigo clássico sobre o estudo de coincidências, formularam a lei dos números verdadeiramente grandes: com uma amostra suficientemente grande, qualquer coisa escandalosa tende a acontecer. Sem magia, sem conspiração: só multiplicação. A consequência para quem trabalha com dados é direta: uma empresa que monitora muitas métricas, em muitas lojas, todos os dias, está rodando milhões de “tentativas”, e vai testemunhar “milagres” estatísticos toda semana. Saber disso muda a leitura de metade dos alarmes. O cérebro odeia o acaso (e inventa histórias) O acaso verdadeiro é desconfortável de olhar. O cérebro humano, uma máquina de padrões, prefere qualquer história a nenhuma: A falácia do apostador. Deu “cara” cinco vezes seguidas; agora “tem que” dar coroa. Não tem: a moeda não tem memória, e a probabilidade segue 50%. No trabalho, o mesmo raciocínio veste terno: “tivemos três meses ruins, estatisticamente agora melhora” (não existe “estatisticamente” nessa frase; existe esperança) ou “essa loja já deu problema demais este ano, a cota dela acabou”. O acaso não distribui cotas. Sequências aleatórias parecem intencionais. Pergunte a alguém para “inventar” 50 lançamentos de moeda: a pessoa alterna demais, evitando sequências longas, porque CCCCC “não parece aleatório”. O acaso real é cheio de rajadas: em 100 lançamentos honestos, uma sequência de 6+ caras seguidas é mais provável que não. Tradução: cinco avaliações negativas em sequência no mesmo turno podem ser perfeitamente compatíveis com uma operação estável (as “8 respostas de segunda-feira” do artigo Amostra, vistas pela lente da probabilidade). Uma rajada dessas merece verificação, mas só a persistência confirma alguma coisa (Diferença real ou ruído?). A mão quente. O estudo famoso de Gilovich, Vallone e Tversky (1985) analisou arremessos no basquete e concluiu que a “mão quente” (o jogador “embalado” que “não erra mais”) era em grande parte ilusão de percepção sobre sequências aleatórias. (Honestidade científica: análises modernas, como a de Miller e Sanjurjo em 2018, mostraram um erro sutil no método original; algum efeito real de mão quente parece existir, menor do que a crença popular. A lição dupla é ainda melhor: o instinto humano superestima padrões em rajadas, e até cientistas revisam conclusões diante de método melhor.) Onde isso morde: o alarme que se pesca sozinho Junte a lei dos números muito grandes com o hábito de olhar dashboards fatiados (pegadinha 4 do artigo Diferença real ou ruído?) e nasce o monstro doméstico: Uma rede com 50 lojas × 10 métricas × 30 dias = 15.000 números por mês. Se cada número tem 1% de chance de parecer “anômalo” por puro acaso, são ~150 anomalias mensais fabricadas pelo nada. Quem sai caçando explicação para cada uma vai encontrar: o cérebro fornece a história com prazer (a obra na rua! o gerente novo! a chuva!), e a empresa passa a gerenciar fantasmas, exatamente o “tampering” contra o qual Deming alertava (Sazonalidade e séries temporais). As defesas já estão espalhadas pela série; aqui, reunidas: Espere X falsos alarmes por mês: literalmente calcule o X. Se o painel monitora N números com limiar de “5% de estranheza”, N × 5% alarmes mensais são o aluguel estatístico do painel. Só o excedente merece investigação. Rajada vira hipótese; repetição vira caso. Anomalia detectada na pescaria só é promovida a fato se persistir em dados novos (veja Achismo, opinião e evidência e Diferença real ou ruído?). O acaso não sustenta performances longas. Pergunte “quantas tentativas houve?” antes de se impressionar com qualquer coincidência: do cliente que reclamou duas vezes no mesmo dia (“quantos clientes temos?”) à métrica que “sempre cai na sexta” (“em quantas sextas olhamos?”). Cuidado redobrado com o que foi encontrado versus o que foi previsto. A previsão registrada antes (“apostamos que o turno da noite cairá”) que se confirma vale muito; o padrão achado depois, vasculhando, vale pouco até segunda ordem; é a ficha de experimento (Experimentos internos) protegendo contra o atirador que desenha o alvo em volta do tiro. O outro lado: não vire cético de pedra A lição não é ignorar padrões, e sim precificar o acaso antes de comprar a história. Rajadas reais existem: o freezer que quebrou gera mesmo cinco reclamações seguidas; o funcionário novo gera mesmo uma sexta-feira ruim. A diferença entre o fantasma e o fato não está na cara do padrão (rajadas aleatórias e causais são idênticas de perto); está no teste: causa real deixa outras digitais (o comentário aberto citando o freezer; veja Quali e quanti) e persiste ou se repete sob observação. Fantasma evapora na amostra seguinte. De volta ao Farol No Farol, a descoberta das terças chuvosas recebeu o tratamento que o acaso merece: virou
Comparações justas: per capita, normalização e benchmarking honesto
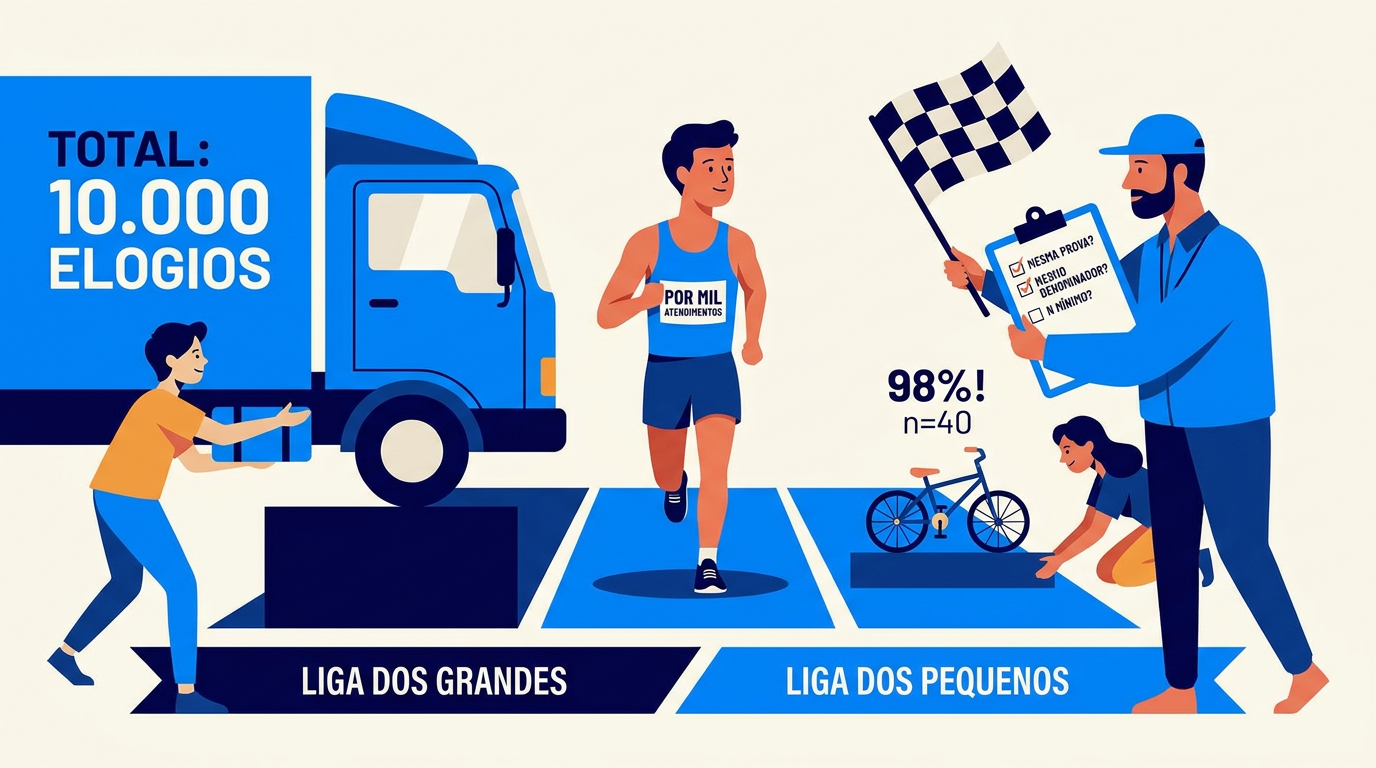
A loja gigante sempre “vence” em totais e a butique sempre “vence” em porcentagens: comparação justa começa escolhendo o denominador certo. É a base do benchmarking honesto. Nas Lojas Andorinha O ranking mensal das trinta lojas da rede Andorinha era impresso e colado na copa de cada uma. E todo mês contava a mesma história: a loja do Centro em último. A equipe já nem olhava o quadro; o líder de vendas tinha parado de mencionar o ranking, “para não desanimar mais ninguém”. Igor, o gerente, levou o incômodo para Sônia, a diretora de operações, com números em vez de queixa: a loja do Centro atendia o triplo de clientes das outras, quase tudo público de passagem, de rua, com pressa, o perfil que avalia mais duro em qualquer lugar do mundo. As lojinhas de bairro, pequenas e de clientela cativa, ocupavam o pódio todo mês. — O quadro compara notas — resumiu ele. — Mas ninguém ali está correndo a mesma prova. O campeonato viciado e o benchmarking honesto O ranking mensal da rede: a megaloja do shopping lidera em elogios recebidos (claro: recebe muito mais clientes), enquanto a lojinha de bairro lidera em % de notas máximas (claro: 40 clientes fiéis que conhecem a dona pelo nome). Cada uma “vence” na métrica que seu tamanho favorece, e o ranking premia geografia e metragem, não gestão. Comparar coisas de tamanhos diferentes é provavelmente a operação estatística mais comum da gestão, e uma das mais malfeitas. Este artigo reúne as regras da comparação justa. Regra 1: totais comparam tamanhos; taxas comparam desempenhos “São Paulo tem mais acidentes que Roraima” diz mais sobre população do que sobre trânsito. A correção universal é o per capita: dividir pelo denominador que neutraliza o tamanho. Reclamações por mil atendimentos, elogios por cem respostas, vendas por metro quadrado, respostas por totem por dia. A escolha do denominador é uma decisão de mérito, não de matemática: reclamações por cliente ou por transação? Vendas por loja ou por funcionário? Cada denominador responde uma pergunta diferente, e quem escolhe o denominador escolhe o vencedor (a mina 4 do artigo Porcentagem, ponto percentual e o crescimento de 300%, agora em versão ranking). O hábito da casa: denominador nomeado no título da métrica, sempre. Regra 2: taxa sem volume também engana (o retorno da base pequena) Corrigido o tamanho, nasce o vício oposto: a lojinha de 40 respostas com “98% de satisfação” no topo do ranking. Taxas de bases minúsculas balançam loucamente (veja Amostra e Diferença real ou ruído?): os primeiros e últimos lugares de qualquer ranking de taxa tendem a ser as unidades menores, pela pura matemática da variância (é o fenômeno que faz escolas pequenas dominarem simultaneamente os topos e os fundos dos rankings educacionais, um exemplo clássico da literatura estatística). Correções práticas, em ordem de sofisticação: exigir n mínimo para entrar no ranking; mostrar a taxa com margem de erro (barras de incerteza matam brigas de ranking na hora); ou agrupar unidades em ligas por porte e comparar dentro de cada liga. Regra 3: compare o comparável (ou ajuste pelo mix) Mesmo com taxas e n adequados, resta a pergunta: as unidades jogam o mesmo jogo? A loja de rodoviária atende viajantes apressados; a de bairro, vizinhos recorrentes. Público, horário, mix de produto e região mudam a nota sem que a gestão mude: é o paradoxo de Simpson (Média mente) e o mix de horário (Sazonalidade e séries temporais) na escala da rede. As defesas, da mais simples à mais trabalhosa: Ligas/clusters: comparar rodoviária com rodoviária, shopping com shopping. Comparar cada unidade consigo mesma: a evolução da loja contra a própria história (veja NPS sem mistério e Sazonalidade e séries temporais) é imune ao mix estrutural; por isso é a comparação padrão mais segura. Padronizar o recorte: comparar todas as lojas no mesmo tipo de hora (o almoço de A contra o almoço de B). E o teto de sofisticação, para conversas de benchmarking externo: ajustes por perfil, como os usados em comparações de hospitais e escolas (ninguém compara mortalidade de um hospital de trauma com uma clínica de check-up sem ajuste de risco). Se a saúde precisa disso para comparar hospitais, o varejo precisa da versão simples disso para comparar lojas. Regra 4: cuidado com o índice composto (a média de maçãs com parafusos) A tentação final do benchmarking: fundir tudo num “score geral”: 40% satisfação + 30% tempo de espera + 30% conversão = Índice da Loja. Índices compostos são úteis para comunicar (um número, um ranking), mas carregam três pegadinhas que quem os consome precisa conhecer: Os pesos são opinião vestida de matemática. Por que 40/30/30 e não 50/25/25? A escolha muda o campeão, e raramente é debatida com a seriedade de qualquer outra decisão editorial. Peso é hipótese: merece justificativa e revisão. O índice esconde os movimentos internos. O score fica estável enquanto satisfação despenca e conversão sobe, duas notícias enormes que se cancelam no agregado (a lição de Média mente, uma escala acima). Índice bom vem sempre com o “abre” dos componentes. Componentes em escalas diferentes precisam de normalização, e a normalização tem escolhas. Transformar minutos, notas e % numa régua comum (0–100, percentis, z-scores) envolve decisões técnicas que mudam resultados. Não é errado; é editorial, e deve estar documentado. Regra da casa para índices (próprios ou de mercado): antes de aceitar o ranking, pedir os componentes, os pesos e a justificativa dos pesos. Quem não fornece os três está pedindo fé em vez de oferecer análise. O checklist da comparação justa Diante de qualquer ranking, benchmark ou “loja X vs. loja Y”: É total ou taxa? Se total, o ranking mede tamanho. Qual o denominador, e ele é o mesmo para todos? Qual o n de cada unidade? Topos e fundos de ranking são território de base pequena. As unidades jogam o mesmo jogo? (mix, público, horário), ou estou comparando rodoviária com bairro? Se é índice composto: quais os componentes, os pesos, e quem os escolheu? E a alternativa que