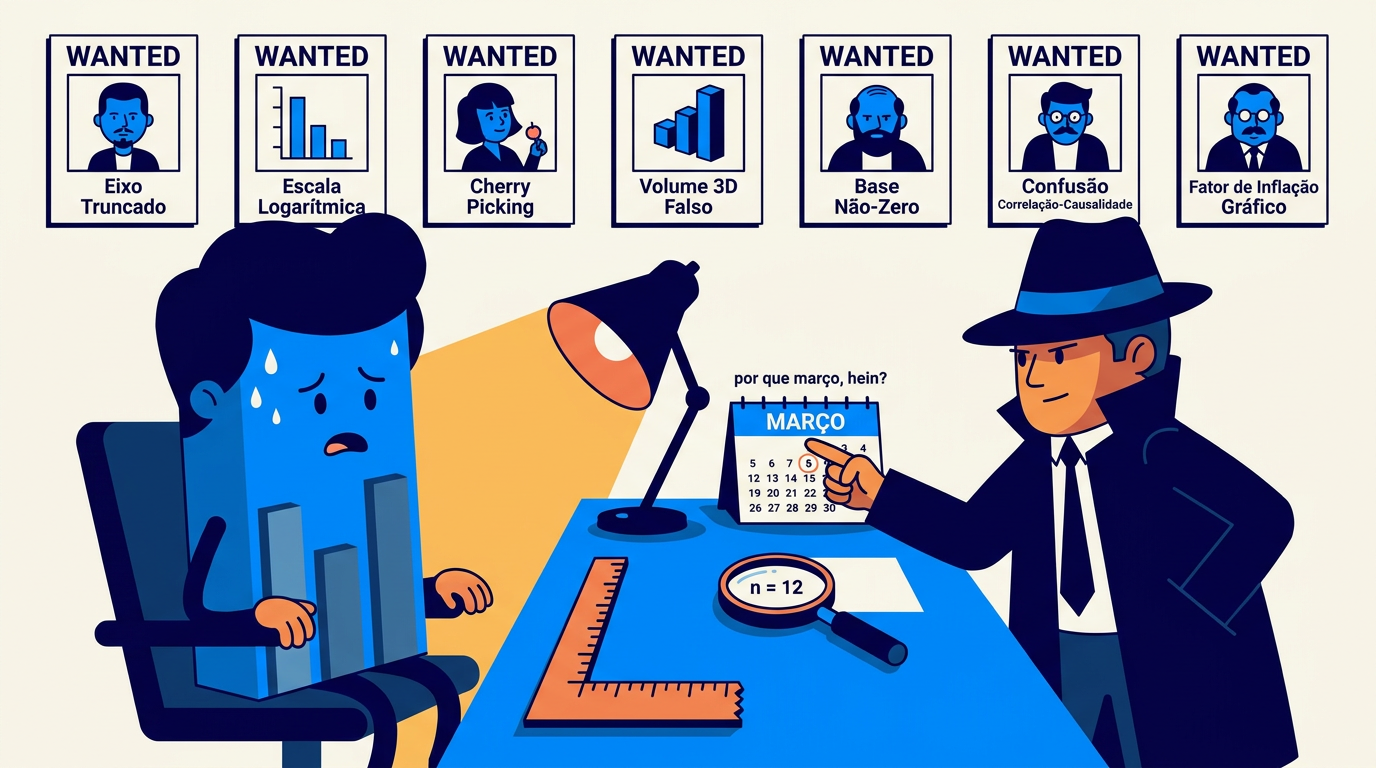
Um gráfico enganoso pode estar 100% correto nos números e ainda assim mentir com a imagem. Aprenda a revistar os dois. Nas Lojas Andorinha O fornecedor de sistemas de fila chegou às Lojas Andorinha, rede de moda com trinta lojas, com uma proposta cara e um gráfico irresistível: a “explosão de conversão” de um cliente após adotar a solução, uma linha subindo como foguete. Metade da sala já fazia contas de instalação. Igor, gerente da loja do Centro, pediu licença, papel e régua. Refez o gráfico à mão, com o eixo começando no zero. O foguete pousou: a subida era de 4,31 para 4,42 em oito meses, um décimo honesto esticado por um eixo que começava em 4,25 e por uma janela que, por coincidência, abria exatamente no pior mês do cliente. — O número de vocês pode até ser bom — disse ele, virando o papel para o vendedor. — Mas o desenho está fazendo hora extra. O gráfico enganoso: a mentira que não precisa de números falsos O artigo Data storytelling ensinou a construir gráficos honestos. Este é o espelho: como ler os gráficos dos outros (relatórios de fornecedores, benchmarks de mercado, posts virais, propostas) com colete à prova de retórica visual. A premissa desconfortável: a maioria dos gráficos enganosos usa dados verdadeiros. A distorção mora nas escolhas visuais: eixo, escala, área, recorte, cor. Edward Tufte deu nome ao fenômeno nos anos 1980 e até propôs medi-lo (o “fator de mentira”: a razão entre o tamanho do efeito na imagem e o tamanho do efeito nos dados). Alberto Cairo, professor de visualização, escreveu o manual moderno do tema com um título que serve de lema: How Charts Lie. Eis as sete técnicas mais comuns, com o antídoto de cada uma. 1. O eixo Y truncado: o drama fabricado O clássico absoluto. A satisfação foi de 4,20 para 4,26, mas o eixo começa em 4,18, e a segunda barra fica quatro vezes tão alta quanto a primeira. Variação de 1,4% vira paredão visual. Antídoto: procure o zero do eixo (em gráficos de barra, ele é obrigatório: a barra codifica valor pela altura total). Em gráficos de linha, eixo cortado é aceitável para mostrar detalhe, desde que sinalizado. A pergunta-reflexo: “quanto isso mudou em números, mesmo?” E a régua do artigo Diferença real ou ruído?: essa mudança supera o ruído? Exemplo com dados fictícios. O aumento é de 0,06 ponto. Com a base em 4,18, a altura visível passa de 0,02 para 0,08: quatro vezes maior. 2. O duplo eixo: a correlação encomendada Duas linhas, duas escalas (uma à esquerda, outra à direita), calibradas para as curvas dançarem juntas. Com liberdade para escolher as duas escalas, quase qualquer par de séries “se acompanha”. É o gerador visual de correlações espúrias (o clássico das correlações espúrias, que “sincroniza” filmes de Nicolas Cage com afogamentos em piscinas, era exatamente isso). Antídoto: desconfie por padrão de eixos duplos; pergunte como ficaria cada série normalizada (variação %, base 100). Quem tem um caso sólido raramente precisa desse recurso. Exemplo com dados fictícios. À esquerda, as escalas fazem as curvas coincidir. À direita, a base comum revela aumentos de 6% e 60%; a coincidência visual não demonstra causalidade. 3. Área e volume: o exagero quadrático Para mostrar que B é o dobro de A, o designer desenha um círculo com o dobro do raio, que tem quatro vezes a área. Pictogramas que crescem em altura e largura, bolhas, moedas empilhadas em 3D: o olho lê área/volume, e a diferença real sai inflada ao quadrado (ou ao cubo). A defesa é lembrar que diferenças quantitativas se leem com segurança em comprimento (barras), não em área. Bolha bonita é para impressão geral; decisão pede barra. Exemplo com dados fictícios. Os dados dobram, mas a área do círculo quadruplica. As barras mostram a proporção correta. 4. O recorte temporal conveniente “Crescimento impressionante desde março!” E março foi o fundo do poço (escolhido a dedo). Toda série tem um ponto de partida que conta a história desejada; quem corta a janela escolhe a manchete. É a versão gráfica da regressão à média (Regressão à média) e da sazonalidade ignorada (Sazonalidade e séries temporais: comparar dezembro com janeiro em vez de dezembro com dezembro). Antídoto: peça a série mais longa (“como está contra o mesmo período do ano passado? e nos últimos 3 anos?”) e desconfie de janelas que começam em vales ou picos. Exemplo com dados fictícios. De março a junho, as vendas crescem 60%. Incluindo janeiro, o saldo até junho é uma queda de 20%. 5. O acumulado que nunca desce A escada rolante do artigo Métricas de vaidade em forma de gráfico: “total acumulado” sobe para sempre, mesmo com o negócio encolhendo. Primo dele: o gráfico de “crescimento do crescimento” (mostra a taxa, esconde que a taxa está caindo). Nos dois casos, peça a métrica por período, ou seja, novos por mês em vez de total desde a fundação. Se o apresentador resistir, você já sabe por quê. Exemplo com dados fictícios. O acumulado chega a 300 clientes, enquanto a aquisição mensal cai de 100 para 20. São os mesmos dados, respondendo a perguntas diferentes. 6. A escala e o mapa que distorcem Escalas logarítmicas apresentadas sem aviso (achatam explosões e dramatizam começos); mapas onde área geográfica vira proxy de importância (municípios enormes e vazios dominam a tela, o “problema do mapa eleitoral”); cores escolhidas para alarmar (vermelho para variação de 0,1). Antídoto: leia a legenda e a escala antes do desenho. São os 5 segundos mais rentáveis da leitura de qualquer gráfico. E lembre-se de que cor não é dado: é editorial. Exemplo com dados fictícios. Este exemplo ilustra a escolha da escala: distâncias iguais no eixo logarítmico representam multiplicações, não acréscimos iguais. A escala logarítmica é válida, mas precisa ser identificada. 7. O gráfico sem contexto de incerteza Barras comparando lojas com 30 respostas cada, sem margem de erro; linhas de “tendência” traçadas sobre 3 pontos; o ranking em que o 1º e o
Coincidências acontecem: a lei dos números muito grandes
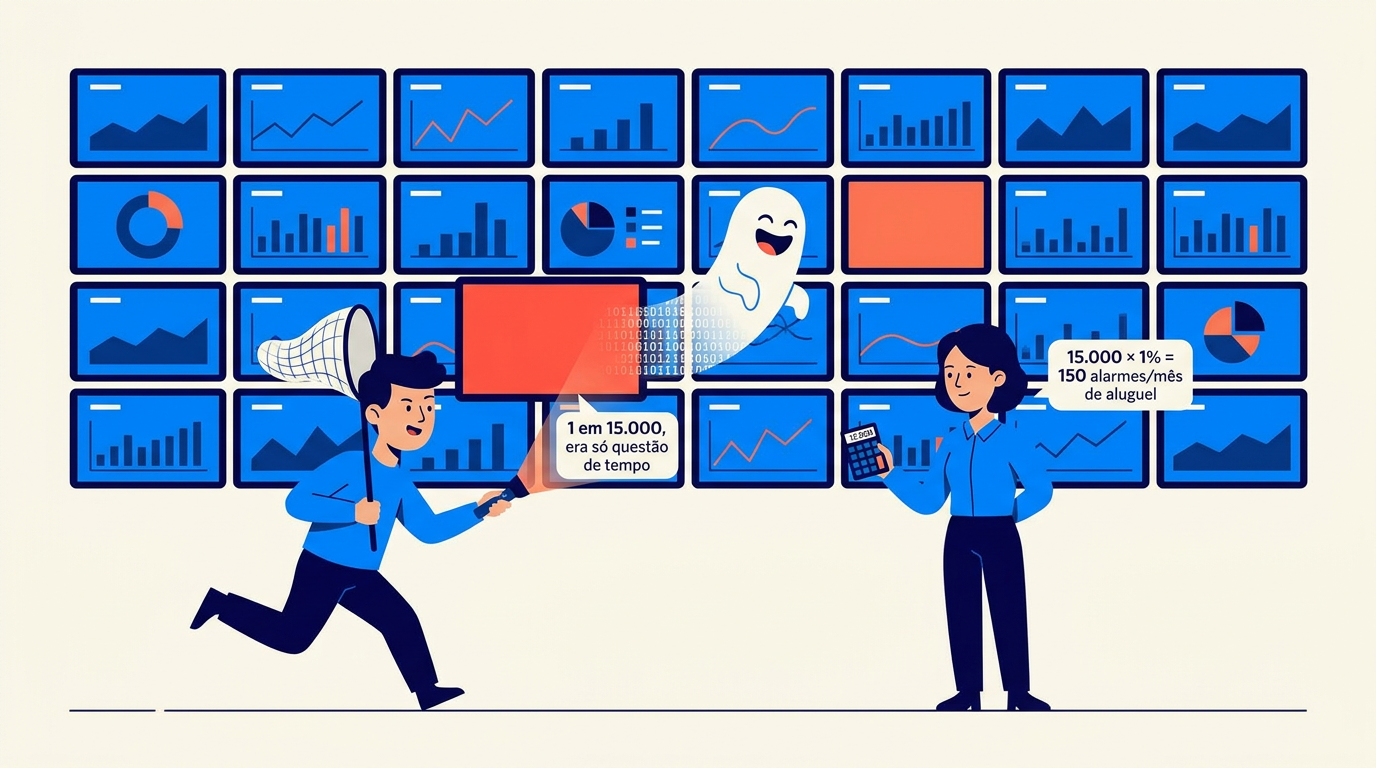
Com tentativas suficientes, o improvável vira rotina, e o cérebro humano vira caçador de fantasmas. É a lei dos números muito grandes em ação. No Supermercado Farol O painel novo do Supermercado Farol, rede com cinco lojas, cruzava tudo com tudo: nota por dia da semana, por clima, por horário, por seção, por loja. Foi lá que Caio, o gerente da loja principal, garimpou o achado que anunciou por e-mail com assunto em caixa alta: “DESCOBERTA: terças-feiras de chuva têm nota 0,4 acima da média!”. Já havia até esboço de plano: promoção de dia de chuva, para surfar o fenômeno. A analista da rede respondeu com uma conta em vez de uma opinião. Entre cortes e combinações, o painel oferecia alguns milhares de cruzamentos possíveis. Em milhares de tentativas, o acaso não é um risco: é uma fábrica. Alguma “terça chuvosa” sempre aparece, como num caça-níquel de alavanca puxada o dia inteiro: de vez em quando três limões se alinham, e ninguém chama de milagre. O milagre estatisticamente obrigatório: a lei dos números muito grandes Qual a chance de alguém ganhar na loteria duas vezes? Praticamente nula, para você. Mas para alguém, em algum lugar, algum dia? Quase certa. Milhões de pessoas jogando, semana após semana, ano após ano: em algum ponto, o “milagre” é aritmeticamente inevitável, e sempre vira notícia, porque noticiamos o ganhador, nunca os milhões de não ganhadores ao lado dele. Os estatísticos Persi Diaconis e Frederick Mosteller, num artigo clássico sobre o estudo de coincidências, formularam a lei dos números verdadeiramente grandes: com uma amostra suficientemente grande, qualquer coisa escandalosa tende a acontecer. Sem magia, sem conspiração: só multiplicação. A consequência para quem trabalha com dados é direta: uma empresa que monitora muitas métricas, em muitas lojas, todos os dias, está rodando milhões de “tentativas”, e vai testemunhar “milagres” estatísticos toda semana. Saber disso muda a leitura de metade dos alarmes. O cérebro odeia o acaso (e inventa histórias) O acaso verdadeiro é desconfortável de olhar. O cérebro humano, uma máquina de padrões, prefere qualquer história a nenhuma: A falácia do apostador. Deu “cara” cinco vezes seguidas; agora “tem que” dar coroa. Não tem: a moeda não tem memória, e a probabilidade segue 50%. No trabalho, o mesmo raciocínio veste terno: “tivemos três meses ruins, estatisticamente agora melhora” (não existe “estatisticamente” nessa frase; existe esperança) ou “essa loja já deu problema demais este ano, a cota dela acabou”. O acaso não distribui cotas. Sequências aleatórias parecem intencionais. Pergunte a alguém para “inventar” 50 lançamentos de moeda: a pessoa alterna demais, evitando sequências longas, porque CCCCC “não parece aleatório”. O acaso real é cheio de rajadas: em 100 lançamentos honestos, uma sequência de 6+ caras seguidas é mais provável que não. Tradução: cinco avaliações negativas em sequência no mesmo turno podem ser perfeitamente compatíveis com uma operação estável (as “8 respostas de segunda-feira” do artigo Amostra, vistas pela lente da probabilidade). Uma rajada dessas merece verificação, mas só a persistência confirma alguma coisa (Diferença real ou ruído?). A mão quente. O estudo famoso de Gilovich, Vallone e Tversky (1985) analisou arremessos no basquete e concluiu que a “mão quente” (o jogador “embalado” que “não erra mais”) era em grande parte ilusão de percepção sobre sequências aleatórias. (Honestidade científica: análises modernas, como a de Miller e Sanjurjo em 2018, mostraram um erro sutil no método original; algum efeito real de mão quente parece existir, menor do que a crença popular. A lição dupla é ainda melhor: o instinto humano superestima padrões em rajadas, e até cientistas revisam conclusões diante de método melhor.) Onde isso morde: o alarme que se pesca sozinho Junte a lei dos números muito grandes com o hábito de olhar dashboards fatiados (pegadinha 4 do artigo Diferença real ou ruído?) e nasce o monstro doméstico: Uma rede com 50 lojas × 10 métricas × 30 dias = 15.000 números por mês. Se cada número tem 1% de chance de parecer “anômalo” por puro acaso, são ~150 anomalias mensais fabricadas pelo nada. Quem sai caçando explicação para cada uma vai encontrar: o cérebro fornece a história com prazer (a obra na rua! o gerente novo! a chuva!), e a empresa passa a gerenciar fantasmas, exatamente o “tampering” contra o qual Deming alertava (Sazonalidade e séries temporais). As defesas já estão espalhadas pela série; aqui, reunidas: Espere X falsos alarmes por mês: literalmente calcule o X. Se o painel monitora N números com limiar de “5% de estranheza”, N × 5% alarmes mensais são o aluguel estatístico do painel. Só o excedente merece investigação. Rajada vira hipótese; repetição vira caso. Anomalia detectada na pescaria só é promovida a fato se persistir em dados novos (veja Achismo, opinião e evidência e Diferença real ou ruído?). O acaso não sustenta performances longas. Pergunte “quantas tentativas houve?” antes de se impressionar com qualquer coincidência: do cliente que reclamou duas vezes no mesmo dia (“quantos clientes temos?”) à métrica que “sempre cai na sexta” (“em quantas sextas olhamos?”). Cuidado redobrado com o que foi encontrado versus o que foi previsto. A previsão registrada antes (“apostamos que o turno da noite cairá”) que se confirma vale muito; o padrão achado depois, vasculhando, vale pouco até segunda ordem; é a ficha de experimento (Experimentos internos) protegendo contra o atirador que desenha o alvo em volta do tiro. O outro lado: não vire cético de pedra A lição não é ignorar padrões, e sim precificar o acaso antes de comprar a história. Rajadas reais existem: o freezer que quebrou gera mesmo cinco reclamações seguidas; o funcionário novo gera mesmo uma sexta-feira ruim. A diferença entre o fantasma e o fato não está na cara do padrão (rajadas aleatórias e causais são idênticas de perto); está no teste: causa real deixa outras digitais (o comentário aberto citando o freezer; veja Quali e quanti) e persiste ou se repete sob observação. Fantasma evapora na amostra seguinte. De volta ao Farol No Farol, a descoberta das terças chuvosas recebeu o tratamento que o acaso merece: virou
Comparações justas: per capita, normalização e benchmarking honesto
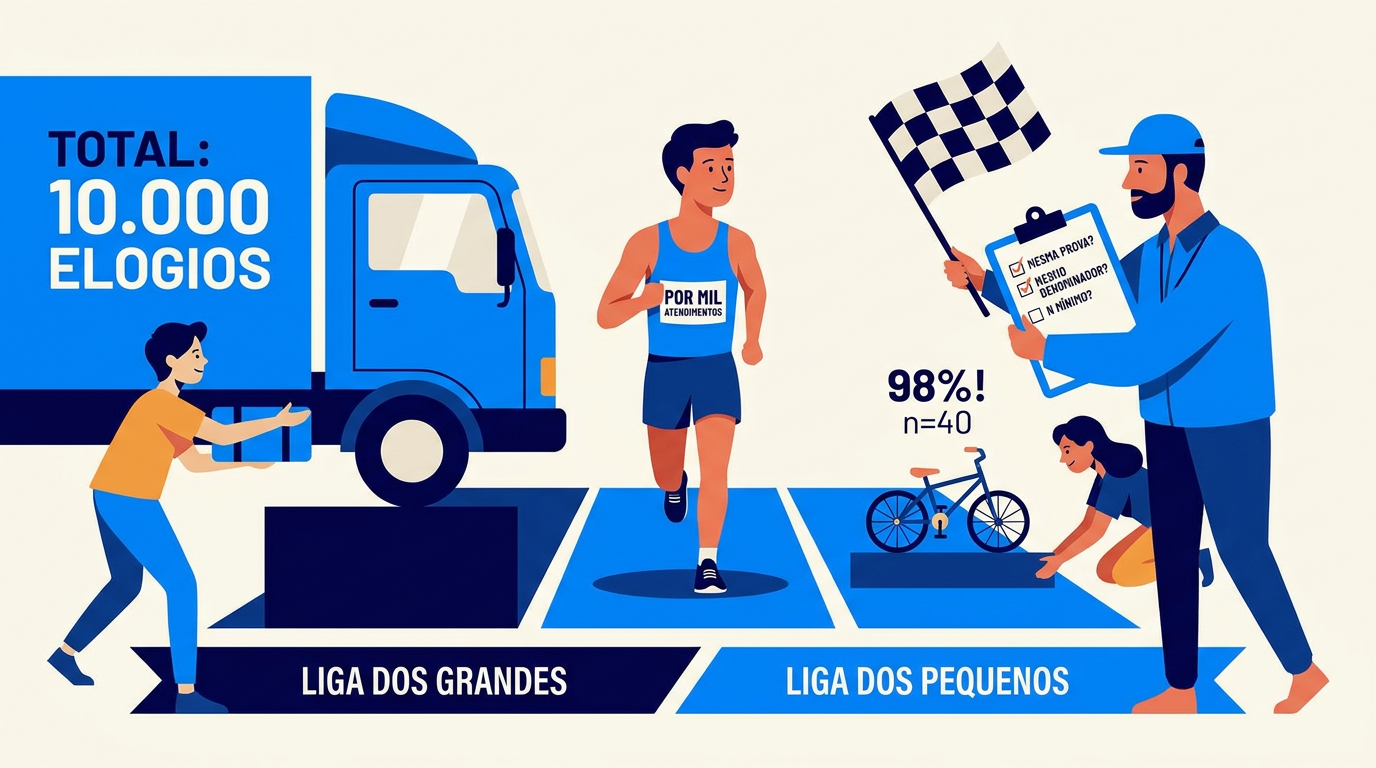
A loja gigante sempre “vence” em totais e a butique sempre “vence” em porcentagens: comparação justa começa escolhendo o denominador certo. É a base do benchmarking honesto. Nas Lojas Andorinha O ranking mensal das trinta lojas da rede Andorinha era impresso e colado na copa de cada uma. E todo mês contava a mesma história: a loja do Centro em último. A equipe já nem olhava o quadro; o líder de vendas tinha parado de mencionar o ranking, “para não desanimar mais ninguém”. Igor, o gerente, levou o incômodo para Sônia, a diretora de operações, com números em vez de queixa: a loja do Centro atendia o triplo de clientes das outras, quase tudo público de passagem, de rua, com pressa, o perfil que avalia mais duro em qualquer lugar do mundo. As lojinhas de bairro, pequenas e de clientela cativa, ocupavam o pódio todo mês. — O quadro compara notas — resumiu ele. — Mas ninguém ali está correndo a mesma prova. O campeonato viciado e o benchmarking honesto O ranking mensal da rede: a megaloja do shopping lidera em elogios recebidos (claro: recebe muito mais clientes), enquanto a lojinha de bairro lidera em % de notas máximas (claro: 40 clientes fiéis que conhecem a dona pelo nome). Cada uma “vence” na métrica que seu tamanho favorece, e o ranking premia geografia e metragem, não gestão. Comparar coisas de tamanhos diferentes é provavelmente a operação estatística mais comum da gestão, e uma das mais malfeitas. Este artigo reúne as regras da comparação justa. Regra 1: totais comparam tamanhos; taxas comparam desempenhos “São Paulo tem mais acidentes que Roraima” diz mais sobre população do que sobre trânsito. A correção universal é o per capita: dividir pelo denominador que neutraliza o tamanho. Reclamações por mil atendimentos, elogios por cem respostas, vendas por metro quadrado, respostas por totem por dia. A escolha do denominador é uma decisão de mérito, não de matemática: reclamações por cliente ou por transação? Vendas por loja ou por funcionário? Cada denominador responde uma pergunta diferente, e quem escolhe o denominador escolhe o vencedor (a mina 4 do artigo Porcentagem, ponto percentual e o crescimento de 300%, agora em versão ranking). O hábito da casa: denominador nomeado no título da métrica, sempre. Regra 2: taxa sem volume também engana (o retorno da base pequena) Corrigido o tamanho, nasce o vício oposto: a lojinha de 40 respostas com “98% de satisfação” no topo do ranking. Taxas de bases minúsculas balançam loucamente (veja Amostra e Diferença real ou ruído?): os primeiros e últimos lugares de qualquer ranking de taxa tendem a ser as unidades menores, pela pura matemática da variância (é o fenômeno que faz escolas pequenas dominarem simultaneamente os topos e os fundos dos rankings educacionais, um exemplo clássico da literatura estatística). Correções práticas, em ordem de sofisticação: exigir n mínimo para entrar no ranking; mostrar a taxa com margem de erro (barras de incerteza matam brigas de ranking na hora); ou agrupar unidades em ligas por porte e comparar dentro de cada liga. Regra 3: compare o comparável (ou ajuste pelo mix) Mesmo com taxas e n adequados, resta a pergunta: as unidades jogam o mesmo jogo? A loja de rodoviária atende viajantes apressados; a de bairro, vizinhos recorrentes. Público, horário, mix de produto e região mudam a nota sem que a gestão mude: é o paradoxo de Simpson (Média mente) e o mix de horário (Sazonalidade e séries temporais) na escala da rede. As defesas, da mais simples à mais trabalhosa: Ligas/clusters: comparar rodoviária com rodoviária, shopping com shopping. Comparar cada unidade consigo mesma: a evolução da loja contra a própria história (veja NPS sem mistério e Sazonalidade e séries temporais) é imune ao mix estrutural; por isso é a comparação padrão mais segura. Padronizar o recorte: comparar todas as lojas no mesmo tipo de hora (o almoço de A contra o almoço de B). E o teto de sofisticação, para conversas de benchmarking externo: ajustes por perfil, como os usados em comparações de hospitais e escolas (ninguém compara mortalidade de um hospital de trauma com uma clínica de check-up sem ajuste de risco). Se a saúde precisa disso para comparar hospitais, o varejo precisa da versão simples disso para comparar lojas. Regra 4: cuidado com o índice composto (a média de maçãs com parafusos) A tentação final do benchmarking: fundir tudo num “score geral”: 40% satisfação + 30% tempo de espera + 30% conversão = Índice da Loja. Índices compostos são úteis para comunicar (um número, um ranking), mas carregam três pegadinhas que quem os consome precisa conhecer: Os pesos são opinião vestida de matemática. Por que 40/30/30 e não 50/25/25? A escolha muda o campeão, e raramente é debatida com a seriedade de qualquer outra decisão editorial. Peso é hipótese: merece justificativa e revisão. O índice esconde os movimentos internos. O score fica estável enquanto satisfação despenca e conversão sobe, duas notícias enormes que se cancelam no agregado (a lição de Média mente, uma escala acima). Índice bom vem sempre com o “abre” dos componentes. Componentes em escalas diferentes precisam de normalização, e a normalização tem escolhas. Transformar minutos, notas e % numa régua comum (0–100, percentis, z-scores) envolve decisões técnicas que mudam resultados. Não é errado; é editorial, e deve estar documentado. Regra da casa para índices (próprios ou de mercado): antes de aceitar o ranking, pedir os componentes, os pesos e a justificativa dos pesos. Quem não fornece os três está pedindo fé em vez de oferecer análise. O checklist da comparação justa Diante de qualquer ranking, benchmark ou “loja X vs. loja Y”: É total ou taxa? Se total, o ranking mede tamanho. Qual o denominador, e ele é o mesmo para todos? Qual o n de cada unidade? Topos e fundos de ranking são território de base pequena. As unidades jogam o mesmo jogo? (mix, público, horário), ou estou comparando rodoviária com bairro? Se é índice composto: quais os componentes, os pesos, e quem os escolheu? E a alternativa que
Porcentagem, ponto percentual e o crescimento de 300%
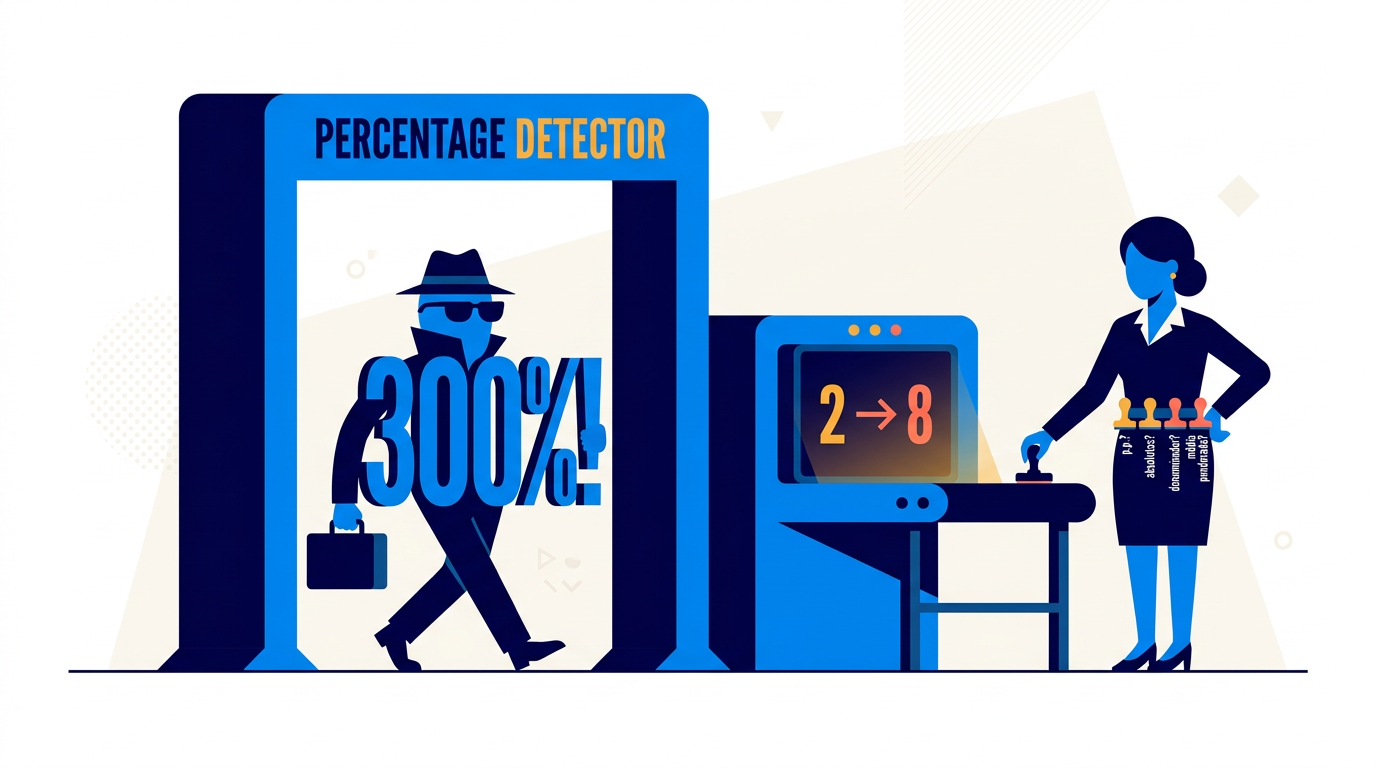
A aritmética mais simples do escritório é a que mais engana, quase sempre sem má intenção. E tudo começa na diferença entre porcentagem e ponto percentual. No Supermercado Farol Foi um dia de duas festas no Supermercado Farol, rede com cinco lojas. De manhã, o marketing comemorou em post interno: “cadastros no clube de fidelidade cresceram 300%!”. À tarde, a operação anunciou na reunião: “reclamações do açougue caíram 50%!”. Dona Ivone, a fundadora, aplaudiu as duas e, por via das dúvidas, pediu os números por trás dos por cento. As festas murcharam juntas. Os cadastros tinham ido de 12 para 48, num universo de nove mil clientes por semana: o 300% era verdadeiro e, por enquanto, irrelevante. As reclamações tinham caído de 2 para 1, na semana de feriado em que o movimento inteiro caíra junto. Ivone devolveu os dois slides com a mesma anotação na margem, a lápis: “por cento de quê? e quanto é isso em gente?” O quiz de um minuto Três afirmações, todas tecnicamente verdadeiras, todas potencialmente enganosas: “Nossa taxa de resposta subiu 10%.” “As reclamações cresceram 300%!” “A ação caiu 50% e depois subiu 50%: voltamos ao ponto de partida.” A terceira é falsa na conclusão (caiu de 100 para 50; subiu 50% de 50 = 75; faltam 25%). A segunda pode descrever “de 1 para 4 reclamações”. E a primeira é ambígua a ponto de significar duas coisas com um abismo entre elas. Porcentagem é a língua franca dos negócios, e um campo minado aritmético. Este artigo desarma as cinco minas mais pisadas e, no fim, mostra que todas elas já estavam catalogadas em 1954. Mina 1: por cento × ponto percentual A taxa de resposta era 40% e foi para 44%. Ela subiu: 4 pontos percentuais (a diferença absoluta: 44 − 40), e 10 por cento (a variação relativa: 4 é 10% de 40). As duas frases descrevem o mesmo fato, mas “subiu 10%” sugere, para metade da sala, que a taxa foi de 40% para 50%. Em métricas que já são porcentagens (taxa de resposta, % de detratores, participação), a confusão é sistemática e às vezes conveniente: “reduzimos a insatisfação em 20%!” soa melhor que “de 10% para 8%”. Regra da casa: variações de métricas percentuais se reportam sempre em pontos percentuais (abreviado p.p.): “subiu 4 p.p., de 40% para 44%”. O NPS, que já é uma subtração de porcentagens (NPS sem mistério), idem: “o NPS subiu 6 pontos”, nunca “6%”. Mina 2: o crescimento espetacular sobre base minúscula “Reclamações sobre o app cresceram 300%.” Pânico? Depende: eram 2, viraram 8. Num universo de 5.000 respostas, isso é estatisticamente invisível (veja Amostra e Diferença real ou ruído?), mas a manchete de 300% viaja pela empresa causando reuniões. Variação relativa amplifica bases pequenas: qualquer coisa rara que dobre “cresceu 100%”. O inverso também engana: um problema gigante que melhora pouco gera porcentagem tímida (“as filas caíram 3%” pode ser a melhor notícia do ano em volume absoluto de clientes beneficiados). Regra da casa: porcentagem de variação nunca viaja sozinha: sempre com os valores absolutos ao lado, como em “de 2 para 8 casos (+300%)”. A dupla desarma tanto o pânico quanto o triunfalismo indevidos. E antes de reagir a qualquer variação percentual, a pergunta do artigo Amostra: quantos casos são? Parênteses para a vida: esse é o recurso preferido dos jornalistas, em manchetes para impressionar a audiência (“casos de X triplicam!”) sem dizer que eram dois e viraram seis. Tome cuidado: a pergunta “quantos casos são?” vale para o jornal da manhã tanto quanto para o slide da tarde. Mina 3: subiu e desceu não se cancelam Quedas e altas percentuais são assimétricas: cair 50% exige subir 100% para voltar. Uma nota que cai 20% e sobe 20% termina 4% abaixo do início. Parece pedantismo até aparecer em decisão real: “perdemos 30% das respostas na mudança do fluxo, mas já recuperamos 30%” significa que ainda faltam 9%, e o slide de “recuperação completa” está errado. Por isso, em voltas e comparações multiperíodo, a regra da casa é comparar níveis (“estávamos em X, estamos em Y”) em vez de empilhar variações. Mina 4: porcentagem de quê? (o denominador escondido) Toda porcentagem é uma fração usando chapéu de número, e quem escolhe o denominador escolhe a história: “80% dos que responderam” ≠ “80% dos clientes” (a diferença é a taxa de resposta e seu viés; veja Amostra e O momento da verdade). “% de reclamações sobre atendimento entre as reclamações” pode subir porque o atendimento piorou ou porque as outras categorias melhoraram. Proporção interna muda sem que nada mude no numerador: é matemática de fatia de pizza: uma fatia cresce quando outra encolhe. “Satisfação de 92% entre clientes ativos” pode melhorar simplesmente porque os insatisfeitos foram embora: o denominador foi purificado pela evasão (viés de sobrevivência, na sua forma mais elegante). Regra da casa: diante de qualquer porcentagem, pergunte em voz alta: “por cento de quê, exatamente?”, e se o denominador pode ter mudado junto. É a pergunta irmã do “número solto é achismo com dígitos” (veja Achismo, opinião e evidência). Parênteses para a vida: essa é uma das formas de distorcer fatos nas pesquisas eleitorais. O mesmo candidato pode ter “40% dos votos válidos” e “31% do total de entrevistados”; a diferença são os brancos, nulos e indecisos que saíram do denominador. Os dois números são verdadeiros, e a campanha escolhe o que lhe convém. Tome cuidado. Mina 5: porcentagens não se somam nem se tiram média (quase nunca) Duas armadilhas de planilha: Média de porcentagens sem peso: a loja A tem 90% de satisfação com 1.000 respostas; a B, 50% com 10 respostas. “Média da rede: 70%”? Não: a média correta, ponderada pelo volume, é ~89,6%. Tirar média simples de taxas com bases diferentes dá voz de gigante a amostras anãs (e é primo do paradoxo de Simpson, explicado em Média mente). Somar porcentagens de perguntas multi-resposta: nas caixas de seleção (O cardápio de perguntas), as opções somam mais de 100%: cada
O formato dos dados: nem tudo é um sino
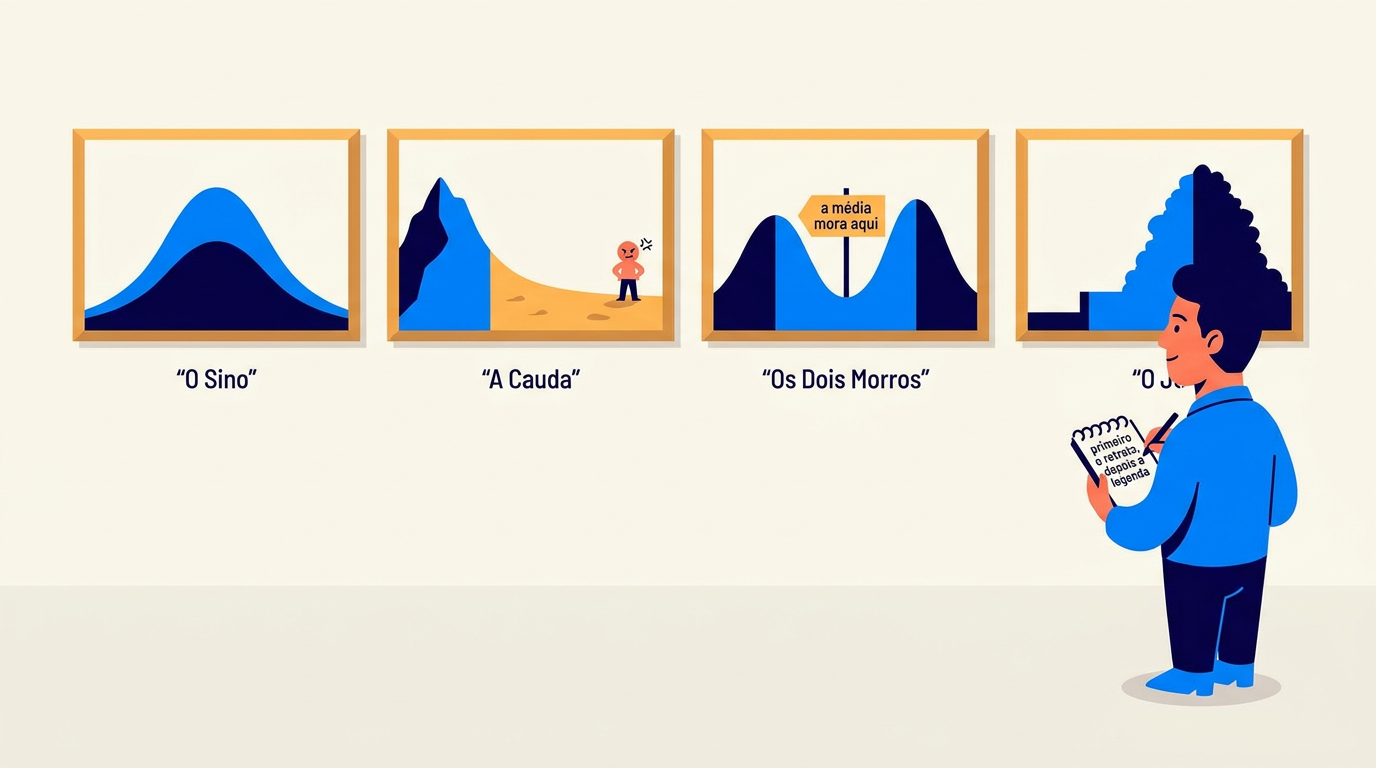
Antes de calcular qualquer coisa, pergunte que forma os dados têm: o resumo certo depende do desenho, e é o histograma de dados que o revela. No Hotel Cambará A média do mês do Hotel Cambará veio redonda: 4,6. Slide pronto, mês dado como bom. Mari Ferreira, consultora da Solvis, pediu uma coisa antes de arquivarem: o desenho. Não a média: o histograma, as notas empilhadas por valor. O desenho contou outra história. A pilha encostava no teto do 5, escorria pelo 4, e lá embaixo, quase discreta, uma cauda de notas 1 e 2: 6% das estadias, concentradas, quando abriram os cortes, nos check-ins depois das 22h e nos quartos do anexo antigo. A média 4,6 engolia aquela cauda sem soluçar: matematicamente correta, humanamente cega para os oitenta hóspedes do mês que tinham dormido mal. E hóspede que dorme mal escreve avaliação pública. — O seu mês não foi “4,6” — disse Mari. — Foi ótimo para muitos e péssimo para alguns. São duas gestões diferentes. O histograma de dados: o retrato antes da legenda Um histograma (a contagem de quantos casos caem em cada faixa) é o retrato de uma métrica. Média, mediana e desvio padrão são legendas desse retrato. E legenda sem retrato engana: o quarteto de Anscombe (Média mente) provou que resumos idênticos podem descrever desenhos opostos. Este artigo é um álbum dos quatro retratos que mais aparecem na análise de dados de satisfação, e do que cada um exige de quem o lê. Retrato 1: o sino (distribuição normal) O formato célebre: simétrico, amontoado no centro, raro nas pontas. Aparece quando o valor resulta de muitos fatores pequenos e independentes se somando: alturas de pessoas, erros de medição, médias de amostras grandes. É o lar da regra 68/95 (Desvio padrão sem dor) e o pressuposto silencioso de muitas ferramentas estatísticas. O erro cultural é achar que ele é o padrão do mundo. Não é. No dia a dia dos negócios, o sino é minoria e assumi-lo onde não existe produz as leituras erradas dos próximos três retratos. Retrato 2: a cauda longa (assimetria) Tempos de espera, tíquete de compra, tempo de resolução de chamado: quase todos os valores são modestos, mas uma minoria se estica numa cauda longa para a direita. Não há tempo de espera negativo, mas há o dia em que o sistema caiu e a fila levou 50 minutos. Consequências práticas: Média > mediana, em geral. A cauda puxa a média para cima do caso típico (o bilionário no bar, do artigo Média mente). “Tempo médio de espera: 9 minutos” pode conviver com “metade dos clientes espera menos de 5”. A ferramenta certa são os percentis. O valor abaixo do qual fica X% dos casos: a mediana é o p50; o p90 diz “90% dos clientes esperam menos que isto”. A engenharia de software gerencia latência de sistemas assim há décadas reportando p90/p95/p99 em vez de médias, precisamente porque a experiência ruim mora na cauda. Para operações de fila e atendimento, vale a mesma lente: a média mede o custo; o p90 mede a raiva. Metas honestas falam de percentil. “Atender em até 10 minutos em 90% dos casos” é uma promessa gerenciável e medível; “tempo médio de 8 minutos” pode ser cumprida enquanto um cliente por hora vive um desastre. Retrato 3: os dois morros (bimodal) Duas corcovas no histograma = duas populações misturadas vivendo experiências distintas: o almoço executivo e o jantar de sábado; o cliente novo e o habitual; o caixa humano e o autoatendimento. A média de uma bimodal cai no vale entre os morros, exatamente onde quase ninguém está. É o retrato mais traiçoeiro para resumos: qualquer número único descreve um cliente que não existe. A leitura certa não é resumir melhor; é separar as populações (segmentar; veja Média mente e Sazonalidade e séries temporais) e tratar cada morro como a história que ele é. O desvio padrão inflado sem explicação (Desvio padrão sem dor) é frequentemente o primeiro sintoma de bimodalidade escondida. Retrato 4: o “J” das notas de satisfação O retrato mais frequente nos painéis de satisfação: notas de satisfação não formam sino: amontoam-se no topo da escala (muitos 5, alguns 4), com um segundo grupinho menor no fundo (os 1 dos episódios ruins) e pouca coisa no meio. A literatura de marketing documenta isso há décadas: distribuições de satisfação são tipicamente assimétricas com concentração no extremo positivo (o levantamento clássico de Peterson e Wilson, 1992, já apontava o padrão e suas causas, do viés de quem escolhe responder e do desejo de ser gentil). Consequências para quem lê dashboards: A média fica cega no teto. Se quase todos marcam 4 ou 5, a média comprime tudo entre 4,2 e 4,6: parece estabilidade, mas o efeito teto está escondendo o movimento. Onde a ação acontece é nas pontas: acompanhe as proporções (% de notas máximas e % de notas baixas) em vez da média espremida. (O NPS, com seus promotores e detratores, é precisamente essa leitura institucionalizada; veja NPS sem mistério.) O meio vazio não é falta de opinião. Nota 3 em escala com formato J é frequentemente um “quase-detrator” educado. Trate a faixa média como zona de investigação, não como “neutros satisfeitos”. Pequenas quedas na média podem ser grandes notícias. Numa distribuição empilhada no teto, a média só cai quando gente migra para o fundo: uma queda de 0,2 pode significar que os casos ruins dobraram. Abra sempre a distribuição (Média mente) antes de julgar a magnitude. O hábito que resume o artigo Diante de qualquer métrica nova, peça o histograma antes de qualquer resumo. Trinta segundos de olhar respondem: é sino (média e desvio funcionam)? Cauda longa (mediana e p90)? Dois morros (segmente antes de tudo)? Empilhado no teto (proporções nas pontas)? Só então escolha a legenda. Resumo estatístico é como embalagem: precisa caber no formato do conteúdo, e é o conteúdo que manda. De volta ao Cambará No Cambará, o fechamento mensal ganhou um morador novo ao lado da média: o
Desvio padrão sem dor: o número que deveria acompanhar toda média
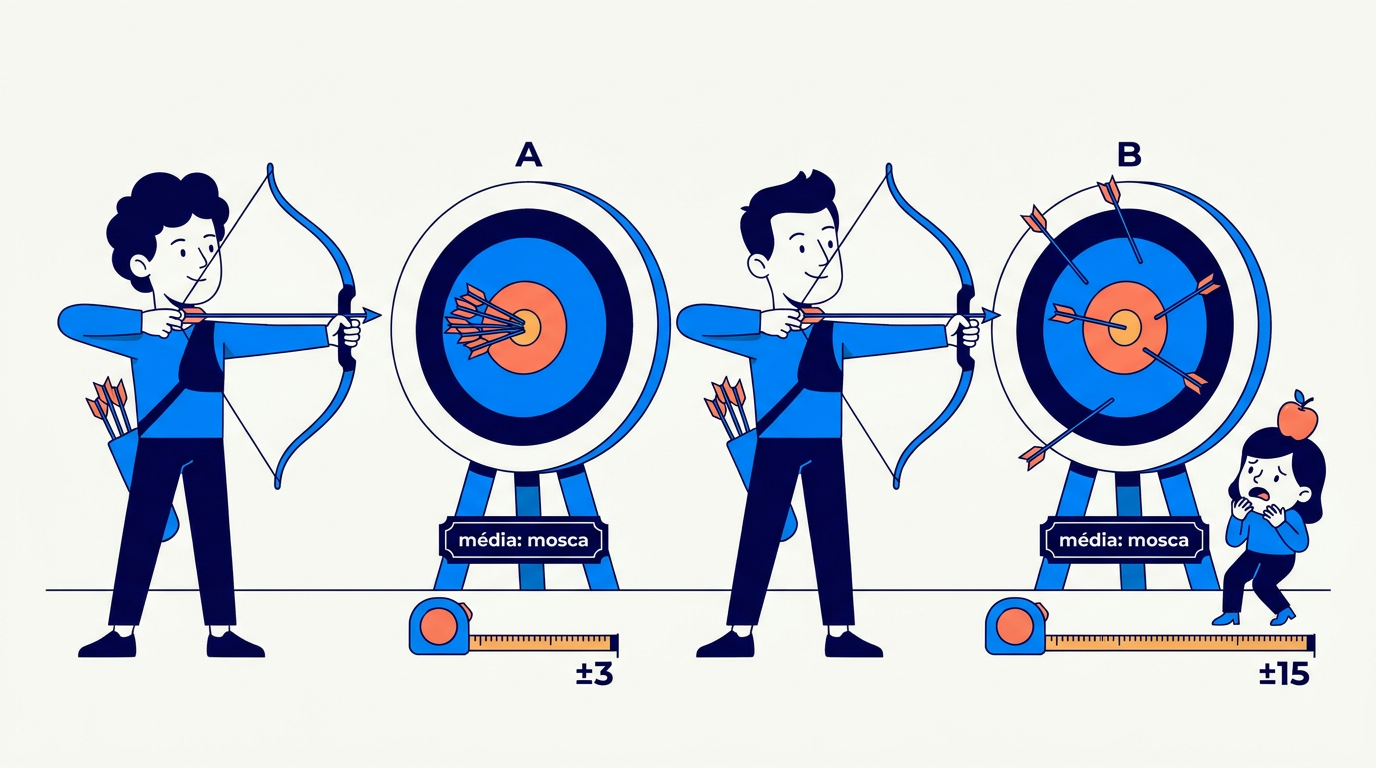
Duas lojas com média 4,2 podem ser um relógio suíço e uma montanha-russa. O desvio padrão é o que conta a diferença. Na Clínica Aurora Wagner, administrador da Clínica Aurora, rede de clínicas médicas, tinha uma vaga de coordenador de fisioterapia e dois finalistas: o fisioterapeuta mais antigo da casa e a recém-chegada que impressionava a todos. Decidido a não escolher no feeling, foi ao painel buscar o dado: a média das avaliações dos pacientes nos últimos seis meses. O veterano: 4,3. A novata: 4,3. — Empate, resumiu para a Dra. Beatriz, a sócia. Seis meses de dado para terminar no cara ou coroa. Beatriz pediu para ver as notas, não as médias. As da novata eram uma fileira constante de 4, com alguns 5 espalhados. As do veterano alternavam 5 e 3: dias de gala e dias de tropeço se revezando. — Mesma média, disse ela, devolvendo o tablet. Mas você diria que é a mesma promessa? O empate, de repente, não parecia mais empate. A pergunta que falta A média esconde os extremos. A pergunta natural é: existe um número que diga o quanto ela esconde? Existe, e é provavelmente o número mais importante que quase nunca aparece nos slides. Pense em dois entregadores de pizza. Os dois entregam, em média, em 30 minutos. Mas o entregador A entrega sempre entre 25 e 35; o B, às vezes em 10, às vezes em 55. Mesma média, negócios completamente diferentes: com A dá para prometer prazo; com B, cada pedido é uma loteria. Os dois têm o mesmo nível; o que muda é o espalhamento. E cliente, como regra geral, odeia loteria: a experiência imprevisível corrói confiança mesmo quando a média é boa (a dimensão "confiabilidade" da qualidade de serviço). O desvio padrão é o termômetro desse espalhamento: um número que resume o quão longe da média os valores costumam ficar. A intuição, sem fórmula Não é preciso decorar a conta (a planilha faz com DESVPAD / STDEV). É preciso entender o que o número diz: Leia o desvio padrão como "o erro típico da promessa da média": quando você diz "em média X" e alguém vive um caso concreto, o desvio padrão estima o tamanho usual da diferença entre a promessa e a vivência. E há uma régua de bolso famosa para dados razoavelmente "comportados", em forma de sino: a regra 68/95 — cerca de 68% dos valores caem a até 1 desvio padrão da média, e cerca de 95% a até 2 desvios. O entregador A (média 30, desvio 3): 95% das entregas entre 24 e 36 minutos. O B (média 30, desvio 15): 95% entre 0 e 60, informação que não informa nada. Três usos práticos imediatos 1. Compare a consistência, além do nível.Duas lojas com a mesma nota média não são gêmeas: a de menor desvio entrega experiência previsível; a de maior desvio tem clientes encantados e clientes furiosos se revezando (a "guerra de extremos", agora com número). Gestão madura persegue as duas coisas: subir a média e apertar o espalhamento. Aliás, muitas vezes a segunda vem primeiro: padronizar o processo (reduzir desvio) costuma ser mais barato que elevar a média inteira. 2. Julgue se uma variação é grande "para os padrões da casa"."A nota caiu 0,3" é muito ou pouco? Depende do vaivém natural da série, e o desvio padrão das variações mensais é exatamente a régua desse vaivém. Queda de 0,3 numa loja cujo mês a mês oscila tipicamente 0,4? Rotina. A mesma queda numa loja que oscila 0,1? Alarme legítimo. É a lógica da carta de controle no modo manual: medir a variação em "desvios da normalidade" em vez de valor absoluto. 3. Detecte o outlier com critério, não com olhômetro."Fora da curva" ganha definição operacional: um valor a 3+ desvios da média é raro o bastante para merecer investigação individual (erro de coleta? caso extraordinário real?). Regra da casa: outlier se investiga antes de se excluir; exclusão silenciosa de pontos incômodos é maquiagem. As pegadinhas do desvio padrão Ele também é sequestrável por outliers. Como a média, o desvio padrão infla com valores extremos: o bilionário no bar bagunça os dois. Para dados muito assimétricos (tempos, valores monetários), os percentis fazem um trabalho mais honesto — assunto para outra ocasião. Desvio grande nem sempre é problema; às vezes é composição. Uma loja com desvio alto nas notas pode não ser "inconstante": pode ter dois públicos vivendo duas experiências (almoço executivo apressado vs. jantar tranquilo). O desvio padrão detecta a mistura; a segmentação revela quem são as parcelas. É um número que abre uma pergunta em vez de fechá-la. Comparar desvios exige mesma escala e mesmo contexto. Desvio de 0,5 numa escala de 5 é enorme; numa escala de 0 a 10 é modesto. E tempos de espera de restaurante não se comparam com tempos de banco. Quando precisar comparar espalhamentos de grandezas diferentes, existe a versão normalizada (o coeficiente de variação: desvio ÷ média), mas na maior parte do dia a dia, a comparação honesta é a de sempre: a métrica contra a própria história. Como pedir esse número (roteiro de reunião) Não é preciso calcular nada para usar isso amanhã. Bastam três perguntas: De volta à Aurora Na Aurora, o desempate não precisou de cara ou coroa; precisou do desvio. A novata, média 4,3 com espalhamento pequeno, era uma promessa que a clínica cumpria todo dia. O veterano, a mesma média com desvio grande, era loteria de agenda. A coordenação, cargo de constância, foi dela. E o veterano não virou problema: virou diagnóstico. Os dias de 3 se concentravam nas agendas dobradas de segunda; o espalhamento apontou o ajuste certo, e o desvio dele caiu no trimestre seguinte. No quadro de gestão, Wagner escreveu a regra nova da casa: média não sobe ao mural sem o desvio do lado. O resumo de uma frase (teste Feynman) "A média é a promessa; o desvio padrão é o tamanho típico da quebra da promessa: nunca aceite uma sem perguntar pelo outro."
Métricas de vaidade: o número que sobe e não significa nada
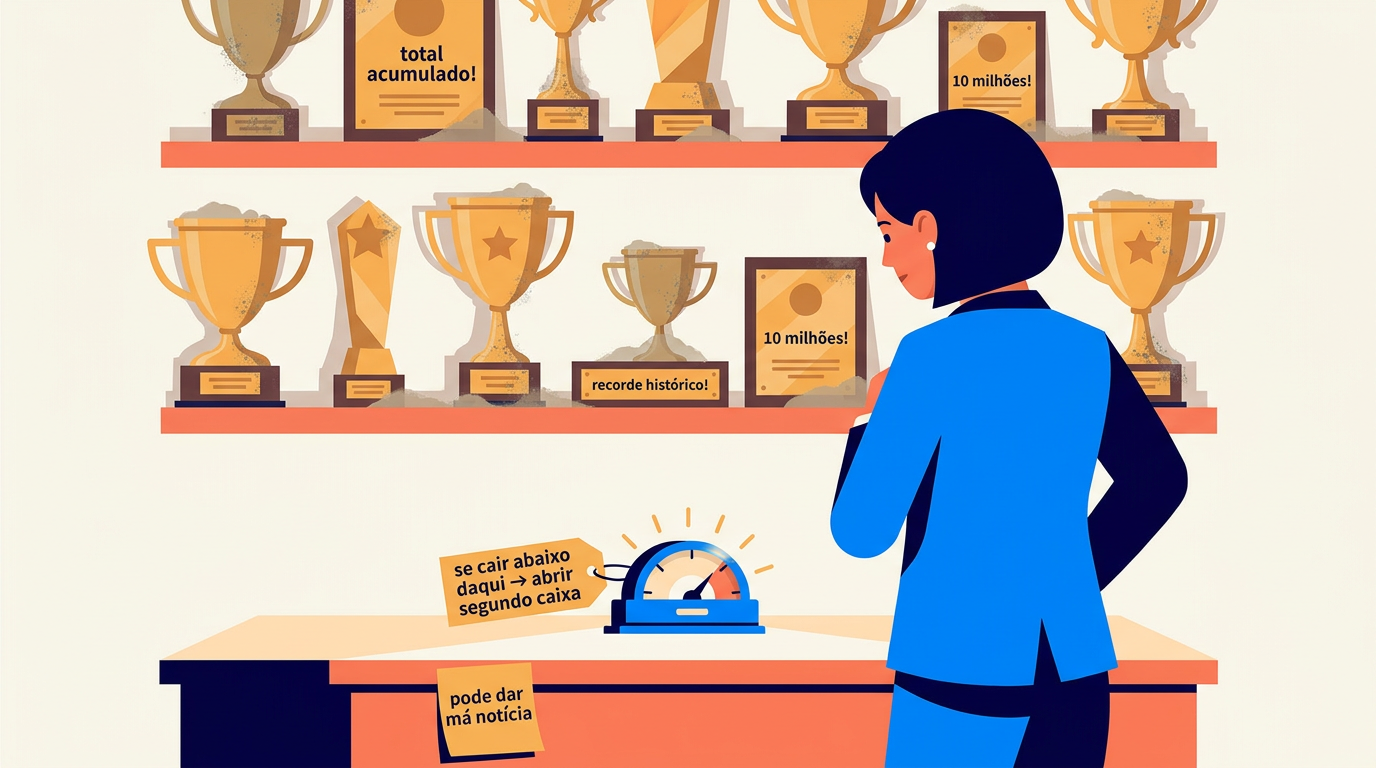
Se o número só serve para o slide ficar bonito, ele não é um indicador: é uma métrica de vaidade, decoração pura. No Supermercado Farol O slide de abertura da reunião mensal do Supermercado Farol, rede com cinco lojas, tinha confete: "14 mil respostas coletadas no trimestre, recorde histórico!". Palmas na sala. Caio, o gerente da loja principal, já emendava a projeção do próximo recorde quando Dona Ivone, a fundadora, fez a pergunta em voz baixa, do fundo da sala: — Se esse número dobrar no próximo trimestre… o que a gente vai fazer de diferente? A sala pensou. Alguém disse "comemorar mais". Ninguém achou uma decisão que mudasse: nenhuma escala, nenhum sortimento, nenhum investimento dependia de 14 mil virarem 28 mil. O recorde era verdadeiro, subia todo trimestre, rendia palmas… e não gerenciava nada. O silêncio foi ficando constrangedor na medida exata em que a ficha caía. O gráfico que só sobe Toda empresa tem um gráfico favorito: downloads acumulados, total de respostas coletadas desde o início, seguidores, visualizações, "impactos". Ele aparece em toda apresentação, sempre subindo, porque foi escolhido justamente por isso. Métricas acumuladas não descem nunca: cada dia soma algo, nem que seja pouco. O gráfico do total acumulado é uma escada rolante que só anda para cima, mesmo quando o negócio anda para trás. Eric Ries, no movimento Lean Startup, deu nome a essa família, as métricas de vaidade: números que fazem a equipe se sentir bem sem informar nenhuma decisão. O oposto, na definição dele, são as métricas acionáveis: as que demonstram causa e efeito e dizem o que fazer em seguida. Este artigo ensina a distinguir umas das outras, e a montar um painel que decide em vez de enfeitar. O teste das três perguntas Diante de qualquer métrica, aplique o filtro de Croll e Yoskovitz (Lean Analytics): 1. "Se este número dobrar (ou cair pela metade), o que faremos de diferente?"Se a resposta é "nada, mas fica ótimo no relatório", é vaidade. A métrica acionável tem uma decisão pendurada nela: escala o piloto, reverte a mudança, realoca a equipe. 2. "Este número pode piorar?"Métrica que estruturalmente não desce (acumulados, recordes históricos, "melhor mês de todos os tempos", que, aliás, a regressão à média fabrica de graça) diz mais sobre a passagem do tempo do que sobre desempenho. Indicador de verdade tem que poder dar má notícia. 3. "É taxa ou é total?"Quase toda vaidade vira métrica honesta quando dividida por algo: "total de respostas coletadas" (vaidade) vira taxa de resposta (acionável: mede engajamento e saúde da amostra); "número de detratores contatados" vira % de detratores contatados em 48h (acionável: mede o ciclo fechado de feedback). O denominador é o que transforma aplauso em informação. Um bestiário de métricas de vaidade A segunda doença: a métrica que virou alvo Há um segundo modo de um bom número apodrecer: a Lei de Goodhart: quando uma medida vira meta, deixa de ser uma boa medida. O mecanismo: no momento em que o bônus depende do número, a energia da equipe migra de melhorar a realidade para melhorar o número, e o número sempre tem caminhos mais curtos que a realidade. Caçar nota 10 no balcão em vez de melhorar o atendimento; desativar o totem no horário caótico; classificar reclamações como "sugestões". O indicador continua subindo enquanto aquilo que ele deveria medir apodrece por baixo: o pior cenário possível, porque desliga o alarme junto com o incêndio. Defesas conhecidas: Montando o painel que decide A síntese prática, em quatro princípios: De volta ao Farol No Farol, o recorde não foi banido: foi rebaixado com honras a indicador de saúde da coleta, guardião da amostra, acompanhado por quem cuida dos totens. O confete do slide de abertura passou a ser de outra estirpe: métricas com decisão pendurada ("nota da fila do fim de dia caiu 0,4: escala reforçada") e cada uma algemada à sua guardiã, para o alvo não apodrecer a régua. O teste da Dona Ivone virou porteiro do dashboard: "se dobrar, o que faremos de diferente?". Métrica sem resposta vai para a estante de troféus, junto com as outras lembranças. E a reunião mensal, sem os dez minutos de confete, ganhou dez minutos de decisão. O resumo de uma frase (teste Feynman) "Métrica boa é a que pode dar má notícia e tem uma decisão pendurada nela; se só sobe e só enfeita, é troféu; e troféu não gerencia loja." Fontes e leituras recomendadas RIES, Eric. A Startup Enxuta. Sextante, 2019. CROLL, Alistair; YOSKOVITZ, Benjamin. Lean Analytics. O’Reilly, 2013. STRATHERN, Marilyn. "’Improving Ratings’: Audit in the British University System". European Review, v. 5, 1997. MULLER, Jerry Z. The Tyranny of Metrics. Princeton University Press, 2018. GROVE, Andrew S. Gestão de Alta Performance. Benvirá, 2020 (original: High Output Management, 1983). DOERR, John. Avalie o Que Importa. Alta Books, 2019.
Pensamento bayesiano: como mudar de ideia na dose certa
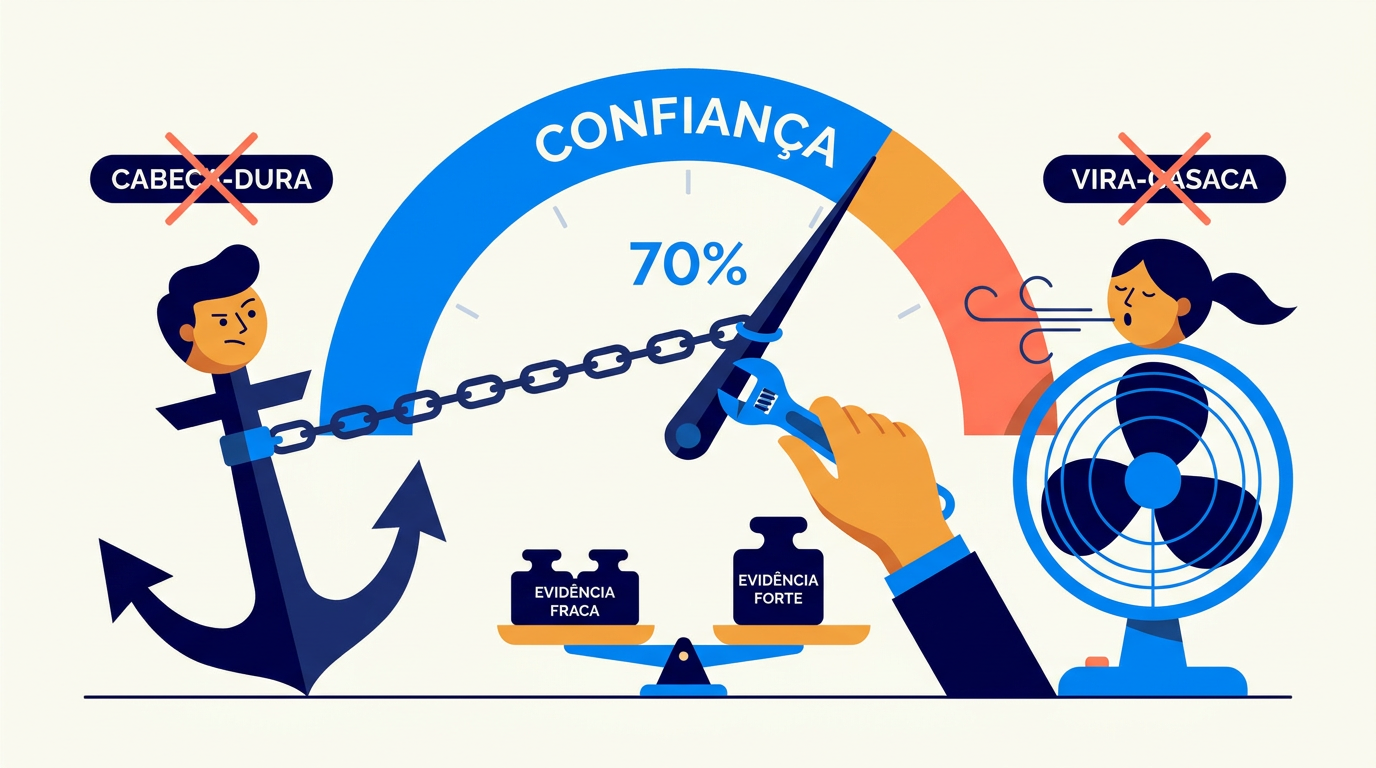
Nem cabeça-dura, nem vira-casaca: pensamento bayesiano é a matemática de atualizar crenças sem zerar o que você já sabia. Na Casa Camélia O concorrente abriu numa quinta, três portas abaixo da unidade Batel da Casa Camélia, rede de restaurantes de Curitiba. Na segunda, dois comentários do totem já o citavam ("fui conhecer o novo, voltei"), e a gerência se dividiu em dois times no grupo: o do êxodo ("vamos perder o almoço executivo, precisa de reação já") e o da modinha ("restaurante novo enche um mês e esvazia"). Marcos, o gerente da unidade, sacou o caderninho que carrega no bolso e escreveu um número, que mostrou a Helena, a fundadora: 30%. — É a minha aposta de que o vizinho leva parte do nosso almoço. Dois comentários não fazem êxodo, mas também não são zero. Cada semana de dado, eu mexo o número. O que eu não vou fazer é decidir hoje com a convicção que só vou poder ter daqui a um mês. Os dois colegas errados Todo escritório tem os dois: O cabeça-dura: nenhum dado o move. "Sempre fizemos assim." Vinte gráficos depois, a opinião é a mesma da primeira reunião. O vira-casaca: qualquer dado o arremessa. Um comentário negativo no totem e ele quer refazer o produto; um elogio no dia seguinte e está tudo ótimo de novo. Sua opinião é sempre a última informação que recebeu. Os dois erram na mesma pergunta: quanto uma evidência nova deveria mover o que eu já acreditava? Existe uma resposta matematicamente correta para isso (publicada postumamente em 1763, num teorema do reverendo inglês Thomas Bayes), e a boa notícia é que sua lógica cabe numa conversa de corredor. Pensamento bayesiano em três palavras: crença vira aposta O pensamento bayesiano pede uma mudança de postura: em vez de tratar opiniões como verdadeiras ou falsas, trate-as como apostas com graus de confiança. Não "o problema é a fila" mas "estou 70% confiante de que o problema é a fila". Feito isso, a regra de Bayes diz como a aposta deve mudar quando chega evidência: Confiança depois = confiança antes × força da evidência Dessa fórmula simples saem as lições que interessam: 1. A crença anterior conta (e deve contar). O que você sabia antes não evapora porque chegou um dado novo; ele é o ponto de partida da atualização. É a defesa matemática contra o vira-casaca: um comentário isolado não deveria demolir seis meses de dados consistentes; deveria movê-los um pouco. 2. A força da evidência é a pergunta-chave. Diante de qualquer dado novo, a pergunta bayesiana é: "esse dado seria muito mais provável se minha hipótese fosse verdadeira do que se fosse falsa?" Se sim, evidência forte: mova bastante. Se o dado é compatível com qualquer cenário ("um cliente reclamou" acontece em lojas boas e ruins), evidência fraca: mova quase nada, por mais vívido que o dado seja (viés de disponibilidade de novo). 3. Atualizar é obrigatório, nos dois sentidos. A régua vale para evidência contra E a favor. Quem só atualiza quando o dado confirma sua tese está apenas praticando o viés de confirmação com uma calculadora na mão. É a defesa matemática contra o cabeça-dura: se você declarou 70% de confiança e o teste veio contrário, o número tem que descer. A pegadinha clássica: esquecer a taxa de base O erro bayesiano mais documentado (Kahneman e Tversky o exploraram exaustivamente) é a negligência da taxa de base: deixar a evidência vívida atropelar a estatística de fundo. Um exemplo comum: uma empresa liga um alerta automático de "cliente prestes a abandonar a marca". Ele é bom: pega 9 em cada 10 clientes que realmente vão embora, e dispara à toa para apenas 1 em cada 10 dos que vão ficar. Hoje de manhã, o alerta apitou para o cliente X. Qual a chance de X estar mesmo de saída? A resposta que vem na hora é "90%". Está errada, e o erro não está na conta do alerta: está na pergunta que ninguém fez antes. Quantos clientes estão de saída, para começo de conversa? Digamos que sejam 2 em cada 100. Acompanhe 1.000 clientes: Ou seja: diante de um alerta qualquer, a chance de ser um cliente realmente de saída é de cerca de 16%, não de 90%. O detector não tem defeito nenhum. Ele foi jogado contra um evento raro, e evento raro com detector imperfeito produz mais alarme falso do que acerto, sempre. Repare que a lógica bayesiana está inteira aí dentro: a crença anterior era 2% (a taxa de base), chegou uma evidência de força conhecida (o alerta) e a aposta subiu para 16%. Isso é um salto de oito vezes, e não é pouco. O alerta funcionou; ele só não faz milagre de transformar 2% em certeza. Onde isso morde no dia a dia: qualquer sistema de alertas sobre eventos raros (fraude de resposta, risco de churn, loja "em crise") vai parecer "errado toda hora" para quem espera 90% de acerto por alerta. Não é defeito; é aritmética. A régua correta de avaliação considera a taxa de base, e o desenho correto do processo prevê a triagem dos falsos positivos. Bayesiano de corredor: o hábito em quatro frases Sem calcular nada, o espírito do teorema vira quatro hábitos de conversa: 1. Dê número à confiança. "Estou 80% confiante" em vez de "tenho certeza". O número expõe a aposta e permite cobrança honesta depois. 2. Pergunte o que a evidência distingue. "Esse dado diferencia nossas duas hipóteses, ou é compatível com as duas?" Dado que não distingue não decide nada, por mais dramático que seja. 3. Declare antes o que te moveria. "Se o teste nas 3 lojas der abaixo de X, desço minha confiança para menos da metade." É a ficha de experimento em linguagem de aposta, e elimina a renegociação da régua depois do resultado. 4. Mova-se em passos proporcionais. Evidência fraca, passo pequeno; evidência forte, passo grande; muitas evidências fracas e independentes na mesma direção, passo grande também: consistência acumulada é força. De
Sazonalidade e séries temporais: compare dezembro com dezembro
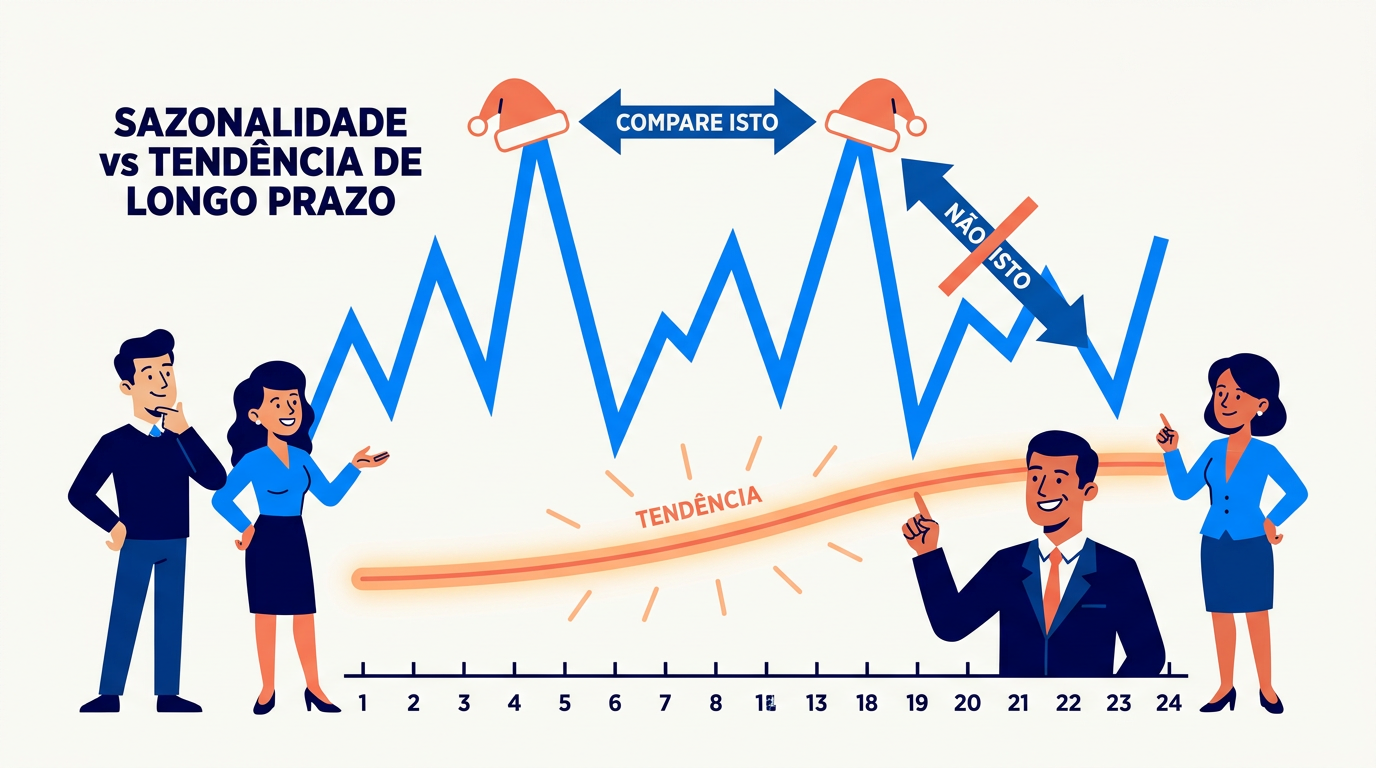
"Caímos 15% em relação ao mês passado" pode ser a notícia mais enganosa do seu dashboard — sem checar a sazonalidade. Na Academia Ritmo A gerente recém-chegada à unidade nova da Academia Ritmo, rede de academias, montou sozinha seu primeiro plano de emergência. O gatilho: julho vinha 14% abaixo de março na frequência, e as matrículas novas minguavam. O plano tinha promoção agressiva, panfletagem e corte da grade de aulas. Fábio, o dono, veterano de quinze invernos de academia, leu o plano, elogiou a iniciativa e fez uma única pergunta: Você comparou julho com março. Já comparou julho… com julho? No gráfico de 24 meses que abriram juntos, o vale estava lá, pontual como um aniversário: todo inverno, o mesmo degrau para baixo na frequência, seguido da mesma recuperação quando setembro esquenta. O "problema" da gerente nova completava aniversário. Situação muito parecida acontece todo mês de janeiro em outros negócios. Reunião de início de ano num cliente do varejo: "As avaliações despencaram em relação a dezembro! O volume de respostas caiu 40%! Precisamos agir!" Calma. Dezembro tinha Natal, loja lotada, público de "presente de última hora", equipe reforçada, decoração nova. Janeiro tem loja normal, público normal, equipe de férias. Comparar janeiro com dezembro não é medir a operação; é medir o calendário. Quase todo número de negócio vive dentro de ciclos: dia da semana, quinzena de pagamento, férias escolares, estações, datas comemorativas. Ler uma série temporal sem separar esses ciclos do resto é a fonte de muitos dos falsos alarmes (e das falsas vitórias) dos dashboards. Este artigo ensina a separação. Sazonalidade, tendência e ruído: três histórias somadas A análise clássica de séries temporais decompõe qualquer métrica ao longo do tempo em três camadas: 1. Tendência: o movimento de fundo, lento e persistente. A satisfação subindo gradualmente há um ano porque o treinamento da equipe vem funcionando. É a camada que interessa à estratégia. 2. Sazonalidade: o padrão que se repete em ciclo previsível. Sábado sempre mais movimentado (e mais mal avaliado) que terça; dezembro sempre atípico; inverno sempre diferente do verão. Não é notícia; é paisagem. A sazonalidade não se conserta; se conhece e se planeja (escalar mais gente no sábado, por exemplo). 3. Ruído: o resto. Flutuação irregular, sem padrão, a "textura da moeda". Não se explica ruído; convive-se com ele. O erro de leitura universal é atribuir à tendência (ou à gestão!) o que pertence à sazonalidade ou ao ruído. O pânico de janeiro é sazonalidade lida como tendência. A "melhora" da terça-feira é ruído lido como resultado da reunião de segunda. As quatro regras de leitura 1. Compare períodos comparáveis: dezembro com dezembro.A defesa mais simples contra a sazonalidade é a comparação ano contra ano (na sigla dos relatórios, YoY): dezembro deste ano contra dezembro do ano passado; o sábado médio deste mês contra o sábado médio do mês passado. Se a métrica de dezembro/2025 está acima de dezembro/2024, há provável melhora real, mesmo que esteja "abaixo de novembro". Corolário: mês contra mês anterior (MoM) só informa quando os meses são estruturalmente parecidos, e raramente são. 2. Dê contexto de calendário aos gráficos.O gráfico honesto marca os eventos: Black Friday, feriados, a obra na loja, a troca de gerente, a campanha de mídia. Metade das "anomalias" de uma série se explica com uma anotação de calendário. Anotar na hora evita a arqueologia dolorosa de reconstruir "o que houve em março?" seis meses depois (e protege do viés de memória). 3. Alise antes de ler: médias móveis.Para enxergar a tendência sob o serrote da sazonalidade semanal, os dashboards usam média móvel (cada ponto = média dos últimos 7 ou 28 dias). É um óculos de leitura: borra o ruído, revela o movimento de fundo. O preço: a média móvel atrasa a percepção de viradas. Quanto mais longa a janela, mais suave e mais atrasada. Use as duas visões: a série crua para detectar eventos, a alisada para julgar direção. 4. Antes de gritar "mudou!", pergunte se a variação sai do vaivém histórico.A ferramenta formal para isso vem do controle estatístico de qualidade de Walter Shewhart e W. Edwards Deming (os pais da qualidade industrial): a carta de controle, que desenha em volta da série uma faixa do vaivém normal daquele processo. A distinção deles é ouro puro para gestores: variação de causa comum (o vaivém intrínseco do processo; não reaja ponto a ponto) versus variação de causa especial (o ponto que fura a faixa, ou uma sequência longa do mesmo lado da média; aí sim, investigue). Deming era enfático: gerente que reage a cada oscilação de causa comum (o "tampering", o mexer sem causa) piora o processo em vez de melhorar, além de exaurir a equipe com alarmes falsos. É a versão industrial da lição da regressão à média. Regra de bolso sem software: um ponto isolado fora do padrão só justifica uma pergunta. Três pontos na mesma direção já valem investigação, e uma mudança que se sustenta por semanas provavelmente é real. Sazonalidade dentro do dia (a versão totem) No ponto de venda, os ciclos encolhem, mas não somem: hora do almoço vs. tarde morta, início vs. fim de turno, dia de promoção. Consequências práticas: De volta à Ritmo Na Ritmo, o plano de emergência virou planejamento de calendário, que era o que o inverno sempre tinha pedido: grade ajustada com antecedência (sem corte de pânico), a campanha certa para a estação ("o projeto verão começa no inverno") e a meta do mês comparada com julho passado, não com março. A gerente nova ganhou de Fábio um hábito de estimação: toda série da unidade com 24 meses no gráfico, "porque um ano só não deixa você ver o aniversário das coisas". E o painel ganhou uma linha fina cinza: o mesmo mês do ano anterior, sempre à vista, para o calendário nunca mais se fantasiar de crise. O resumo de uma frase (teste Feynman) "Todo número vive dentro de um calendário: separe o que é estação do ano, o que é vaivém normal e o
Diferença real ou ruído? Significância estatística sem fórmulas
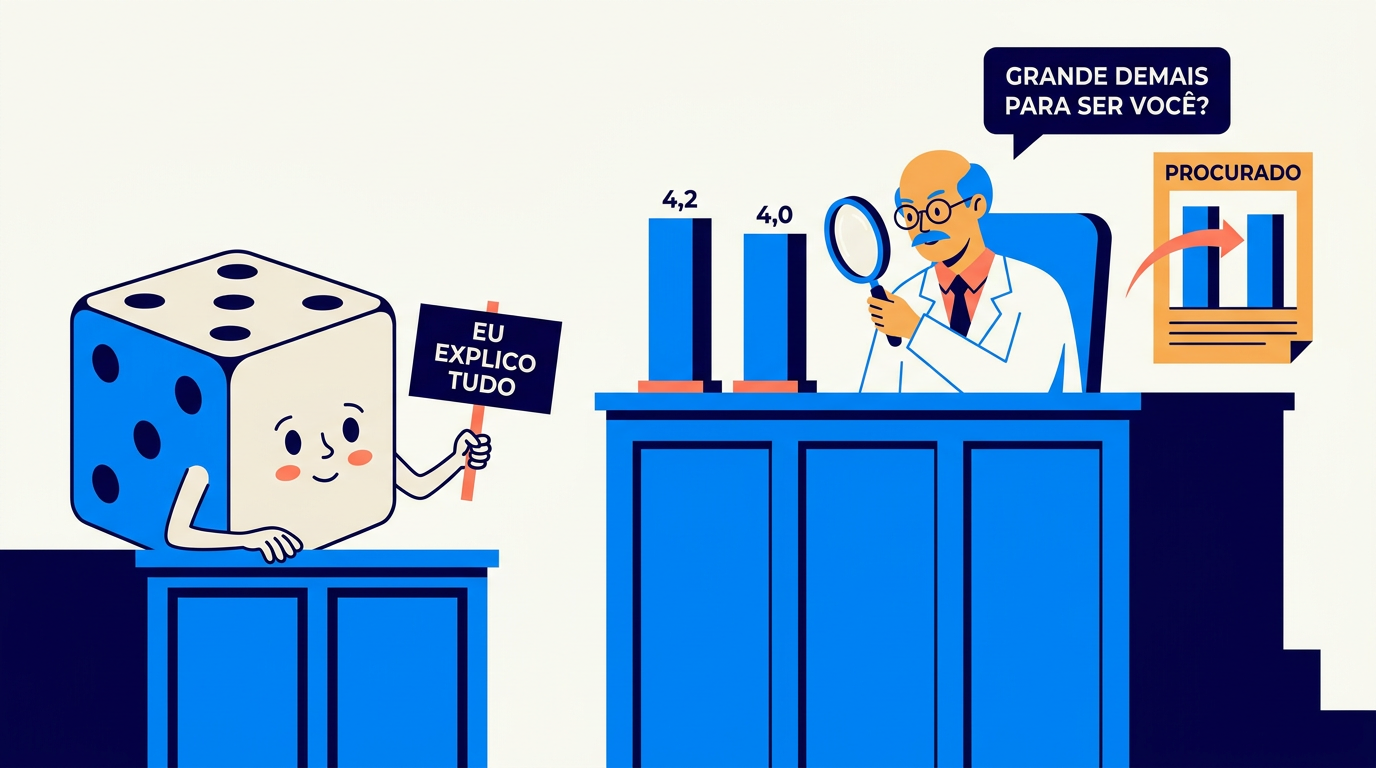
Loja A: 4,2. Loja B: 4,0. Antes de premiar a Loja A, teste a significância estatística: jogue uma moeda cem vezes. No Hotel Cambará Os dois e-mails saíram da mesma sala do Hotel Cambará, com trinta dias de diferença. O primeiro, em tom de festa: "Parabéns, equipe! Nota geral subiu de 4,3 para 4,5. O trabalho está aparecendo!". O segundo, em tom de crise: "Precisamos conversar. Caímos de 4,5 para 4,3. Reunião amanhã às 8h". Os dois assinados por Otávio, o gerente-geral. Luana, a chefe de recepção, releu os dois antes da reunião das 8h e fez a conta que ninguém tinha pedido: com o volume mensal de avaliações do hotel, a nota oscilava naturalmente uns dois décimos para cada lado, sem que nada de real mudasse. A festa e a crise tinham a mesma amplitude do vaivém de sempre. Ela levou os dois e-mails impressos para Otávio, lado a lado: — Antes da reunião das 8h, uma pergunta: e se os dois meses forem o mesmo mês? O experimento da moeda Pegue uma moeda honesta e lance 100 vezes. Você espera 50 caras, mas quase nunca sai exatamente 50. Sai 46, 53, 48. Lance de novo: 55. A moeda não mudou; o acaso produz variação sem nenhuma causa por trás. Agora troque a moeda por notas de satisfação. A Loja A fez 4,2 este mês; a Loja B, 4,0. A pergunta de um milhão de reais: essa diferença é como 53 caras contra 48 (flutuação de moeda honesta), ou as lojas são de fato diferentes? Toda a maquinaria da "significância estatística" existe para responder essa única pergunta. E dá para entendê-la inteira sem uma fórmula. Significância estatística: a lógica do advogado do diabo O raciocínio estatístico clássico funciona como um tribunal às avessas. Diante da diferença entre A e B, o estatístico banca o advogado do diabo e assume o tédio como hipótese: "suponha que as lojas são idênticas e tudo isso é acaso" (a chamada hipótese nula). Depois pergunta: "Se fosse só acaso, seria comum ver uma diferença deste tamanho?" O famoso valor-p é só o número que quantifica essa resposta: a probabilidade de o acaso sozinho gerar uma diferença pelo menos tão grande quanto a observada. O costume (herdado do estatístico Ronald Fisher, nos anos 1920) de usar 5% como linha de corte é convenção, não lei da natureza: um combinado social sobre quanto risco de falso alarme aceitamos. Intuição rápida: com poucas centenas de respostas por loja, uma diferença de 4,2 vs. 4,0 numa escala de 5 frequentemente cabe dentro do que o acaso produz — a mesma conclusão da margem de erro, vista por outro ângulo. Premiar a Loja A por isso é premiar o cara-ou-coroa. As cinco pegadinhas que até gente experiente comete 1. "Significativo" não significa "importante".Palavra traiçoeira. Com amostra gigante, uma diferença de 0,02 ponto pode ser "estatisticamente significativa": real, porém irrelevante para qualquer decisão. Significância diz "provavelmente não é acaso"; nunca diz "é grande" ou "vale dinheiro". Sempre pergunte pelas duas coisas: é real? E é relevante? 2. "Não significativo" não significa "igual".Ausência de evidência não é evidência de ausência. Com 30 respostas por loja, quase nenhuma diferença atinge significância: o teste está míope, não o mundo homogêneo. A conclusão honesta é "não dá para afirmar com esta amostra", nunca "provamos que é tudo igual". 3. "Quase significativo" não existe.Se o combinado era 5% e deu 6%, o resultado é não significativo. Ponto. A tentação de flexibilizar a régua depois de ver o resultado é o viés de confirmação vestindo jaleco. A régua se define antes, como o critério de sucesso de uma ficha de experimento. 4. Quem procura em 20 lugares, acha em 1 por puro acaso.Este é o mais traiçoeiro. Se você fatia o dashboard em 20 recortes (por loja, turno, dia, perfil…), espere que um deles pareça "significativo a 5%" por sorte pura: é o que 5% significa. O costume de fatiar até algo "dar positivo" tem nome (p-hacking) e é considerado má conduta científica. A defesa prática: recorte que apareceu na pescaria vira hipótese a confirmar com dados novos antes de virar manchete. 5. Significância não conserta amostra torta.O teste pressupõe que as respostas são uma "colherada de sopa mexida". Se a coleta foi enviesada, o p-valor sai bonito e errado. Nenhuma matemática posterior conserta coleta ruim. A comunidade estatística se preocupou tanto com esses maus usos que a American Statistical Association fez algo raríssimo em 2016: publicou um comunicado oficial sobre o que o p-valor é e não é, incluindo o alerta de que decisões não deveriam se apoiar apenas em "passou/não passou do 0,05". Dragagem de dados vs. mineração de dados Embora pareçam conceitos semelhantes (ambos buscam padrões em grandes volumes de dados), o objetivo e a metodologia são opostos: Como evitar a dragagem de dados Para garantir que uma descoberta é real e não apenas uma coincidência estatística, existem três estratégias principais: O kit prático para o dia a dia Sem rodar teste nenhum, quatro hábitos capturam 90% do valor: Um quinto hábito vale para quem já vasculha dados livremente, especialmente com apoio de IA: é muito fácil chegar a conclusões irreais quando se cruza tudo com tudo. Busque sempre encontrar hipóteses a partir dos dados, não encontrar respostas prontas. As hipóteses podem depois ser testadas, validadas e confrontadas com dados novos. Os dois inimigos desses hábitos têm nome na literatura, e vale conhecê-los: o viés de ação (a compulsão de "fazer algo" diante de qualquer variação, porque esperar parece omissão, mesmo quando esperar é a decisão estatisticamente certa) e o viés de autoatribuição (melhorou: mérito meu; piorou: azar do mercado, o que transforma todo plano de choque em sucesso retroativo). De volta ao Cambará No Cambará, a reunião das 8h mudou de pauta: em vez de investigar a queda, investigou-se a régua. A faixa de flutuação normal do hotel, calculada e desenhada no dashboard como uma zona sombreada, passou a separar notícia de ruído: dentro da faixa, ninguém comemora nem convoca crise;