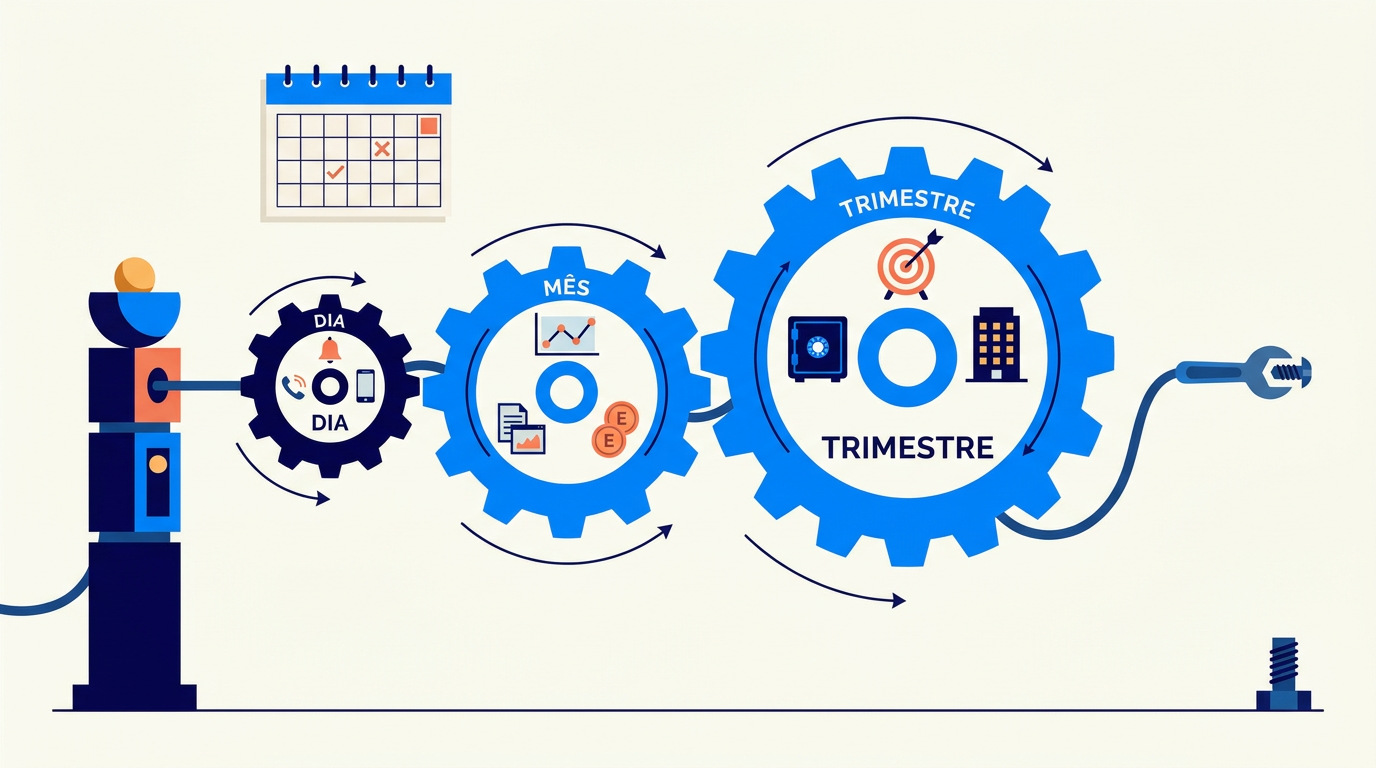
Dashboard não gerencia nada. Quem gerencia é a reunião que olha para ele, se ela existir, tiver dono e acabar em ação. São os rituais de gestão que fazem o dado virar ação. No Sabor Central O relatório que estragou o café da manhã de Nelson, diretor de contratos do Sabor Central, empresa de refeições coletivas, não falava de comensais: falava de acessos. O dashboard dos contratos, orgulho da empresa, bonito de doer, tinha sido aberto 7 vezes no mês inteiro. Quatro delas pela própria equipe que o mantém. Enquanto isso, as reclamações urgentes da semana eram discutidas na reunião mensal, mortas de velhas, e as tendências de fundo apareciam em conversas de corredor, vivas e sem dono. O dado existia, a ferramenta existia, a boa vontade existia. O que não existia era hora marcada: nenhuma reunião da empresa tinha o painel como pauta, então o painel não tinha plateia. — A gente construiu um sino ótimo — resumiu Paula, a nutricionista-chefe — e esqueceu de combinar quando ele toca. O elo perdido dos rituais de gestão Entre o dado coletado e a empresa transformada existe um elo que quase nunca aparece nos diagramas: a agenda. Literalmente: as reuniões, os horários, os nomes na sala. Informação só vira gestão quando tem um encontro marcado com uma decisão. A ciência da qualidade formalizou isso nos anos 1950: o ciclo PDCA de Deming (planejar → executar → verificar → agir) só roda se o “verificar” tiver hora marcada. Empresas com programas de escuta excelentes no papel fracassam neste elo: o dado chega, e não há rito que o consuma. Este artigo desenha a cadência mínima: três ritmos, cada um com sua alçada, todos governados pelo mesmo princípio. E vale enfrentar de frente o preconceito da moda: reunião não é o inimigo. Andy Grove, que comandou a Intel com mentalidade de engenheiro de produção, deu a essa tese sua formulação mais direta em High Output Management: a reunião é o meio pelo qual o trabalho de gestão acontece, e a pergunta certa nunca é “ter ou não ter reuniões”, e sim se cada uma tem formato, papel e cadência certos. A distinção dele organiza este artigo: reuniões de processo (regulares, que consomem informação em ritmo previsível) e reuniões de missão (pontuais, convocadas para produzir uma decisão específica). Os três rituais de gestão a seguir são reuniões de processo; a revisão de operações que Grove rodava na Intel é o ancestral direto do Ritual 2. O princípio: cada ritmo olha uma coisa diferente O erro universal das reuniões com dados é todas olharem o mesmo número do mesmo jeito: tipicamente, a diretoria discutindo o caso individual de terça-feira e o gerente tentando explicar a tendência trimestral. A divisão correta segue a estatística da série: Misturar as camadas produz os dois patológicos clássicos: a diretoria “tampering” em ruído diário (artigo Sazonalidade e séries temporais; Deming avisou) e a operação anestesiada para a tendência lenta que ninguém tem mandato de discutir. Ritual 1 — O semáforo diário (loja, 10 minutos) Quem: gerente da unidade com a equipe do turno. Olha: os alertas de ontem: detratores a contatar (com prazo, artigo O ciclo fechado), comentários abertos do dia, o número do dia contra o dia equivalente (terça com terça, artigo Sazonalidade e séries temporais). As três perguntas do rito: algum cliente precisa de resposta hoje? Algum comentário aponta algo consertável agora (o freezer, a fila das 12h)? Algo a escalar para cima? O placar do rito é o do jogador, não o do técnico. A observação é de As 4 Disciplinas da Execução (McChesney, Covey e Huling): equipe se engaja quando marca os próprios pontos num placar simples, visível e atualizado por ela mesma (os detratores de ontem, os contatos feitos, o número do dia contra a terça passada). O dashboard completo, com vinte recortes, é ferramenta da matriz; no turno, ele anestesia em vez de mobilizar. O que NÃO fazer: discutir tendência com dado de um dia (artigo Amostra: 8 respostas não são pesquisa) ou premiar/cobrar pelo número diário (artigo Regressão à média: o vaivém fabrica heróis e culpados por sorteio). Ritual 2 — A revisão de padrões (regional/processo, mensal, 1 hora) A reunião mais importante do sistema, e a mais malfeita do mundo corporativo. Quem: dono do processo com gerentes das unidades. Olha: séries com contexto sazonal (YoY, médias móveis; artigo Sazonalidade e séries temporais), distribuição além da média (artigos Média mente e O formato dos dados), categorias dos comentários (artigos As cinco dimensões da qualidade de serviço e Quali e quanti), o funil do ciclo fechado (% de detratores contatados em 48h; artigo O ciclo fechado). As regras de ouro desta reunião, destiladas da série inteira: Ritual 3 — A revisão estratégica (diretoria, trimestral) Olha: tendências longas contra metas (artigo Metas de satisfação bem desenhadas), o caso financeiro em atualização (artigo O caso financeiro da satisfação: casos fechados e valor capturado), decisões de investimento que a escuta está pedindo (a obra, o sistema, o quadro de pessoal), e a saúde do próprio programa (taxa de resposta, cobertura, integridade; os pares métrica + guardiã do artigo Métricas de vaidade). É aqui que a voz do cliente disputa orçamento de igual para igual, o estágio 3 de maturidade do artigo Voz do Cliente. Se o cliente só é citado nas reuniões “de CX”, o programa parou no estágio 2. A liturgia comum dos rituais de gestão (o que vale para os três ritos) Comece pelo cliente, literalmente. Um comentário verbatim (artigo Quali e quanti) ou uma ligação de recuperação da semana abre a reunião. Não é cerimônia: é o antídoto contra a abstração, porque número anestesia e história mobiliza (artigo Data storytelling). Proibido debate de achismo em assunto mensurável. A escada do artigo Achismo, opinião e evidência pendurada na parede: “em que degrau está essa afirmação?” é pergunta legítima de qualquer participante para qualquer participante, inclusive para o chefe. Ata de decisões, não de discussões. O registro que importa: o que decidimos, quem faz, até
O caso financeiro da satisfação: quanto vale um ponto de NPS?
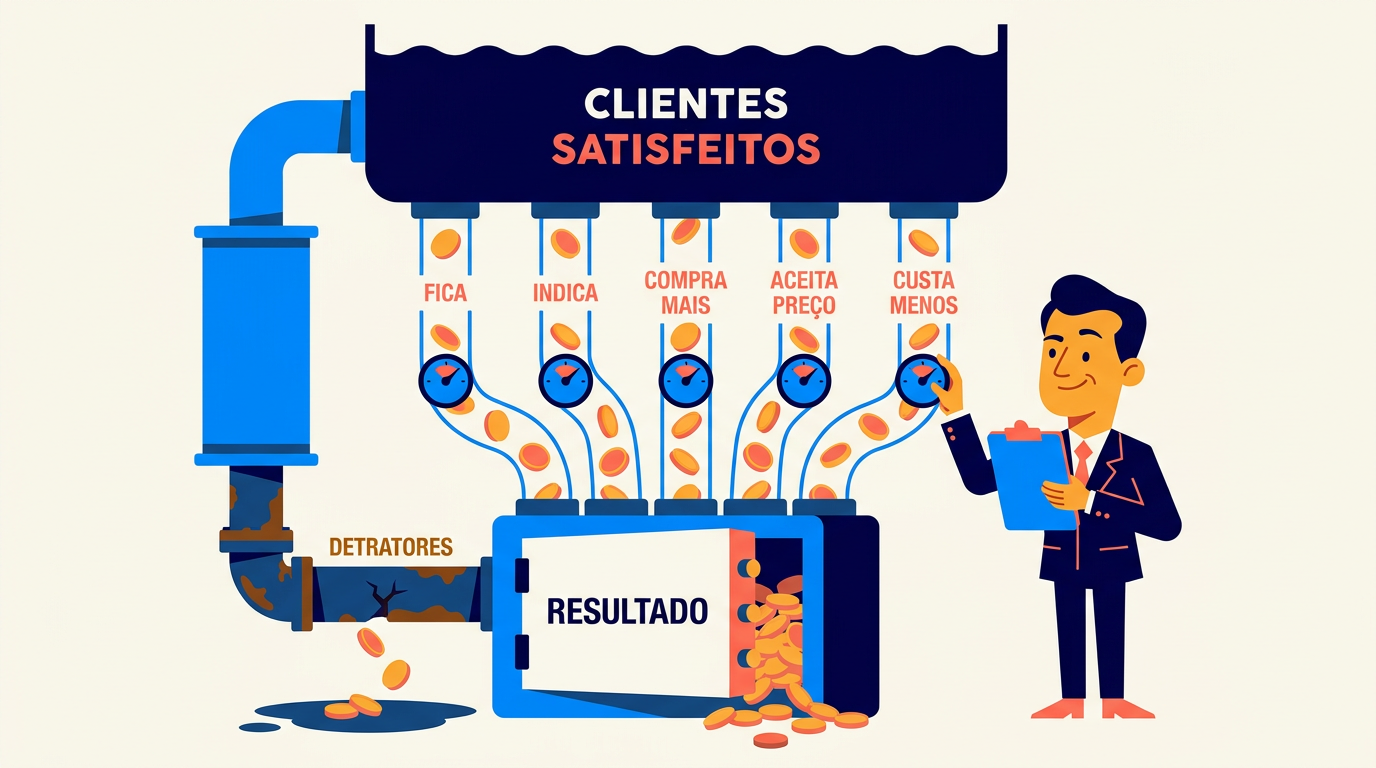
Experiência do cliente não é “coisa boa de se fazer”: é uma tese de investimento. E teses se defendem com números. Este é o caso financeiro da satisfação. Na Academia Ritmo Na reunião de orçamento da Academia Ritmo, rede de academias com três unidades, o contador chegou com a planilha anual e uma linha marcada em amarelo: “pesquisa de satisfação”. A proposta era educada e letal: cortar 60%. “É a linha mais fácil: não fecha unidade, não demite professor. E, com respeito, não consigo apontar o retorno.” Fábio, o dono, começou a responder com convicção e parou no meio da frase, com uma honestidade rara: a convicção era dele, mas a conta não existia. Em anos de pesquisa, a academia nunca tinha montado o caminho do dinheiro: quanto vale o aluno que fica mais um ano, o que traz o amigo, o que migra para o plano anual, o que custa menos atender. — Me dá noventa dias — disse ele. — Se a conta não fechar, o corte é seu. Se fechar, a linha amarela vira investimento no seu relatório. A pergunta do CFO: onde está o caso financeiro? Toda iniciativa de experiência do cliente eventualmente encontra a pergunta que a define: “e isso dá quanto de retorno?” Times de CX que respondem com adjetivos (“fideliza!”, “encanta!”) perdem o orçamento para quem responde com contas. A boa notícia: as contas existem, a evidência acumulada é farta, e o raciocínio cabe neste artigo. A má notícia (que é boa notícia para quem faz direito): o elo satisfação → dinheiro depende de mecanismos específicos e nada automáticos. Conhecer esses mecanismos é o que separa o caso financeiro sério do slide de motivação. A evidência de fundo: satisfação prevê resultado O elo agregado está bem documentado. O ACSI (The American Customer Satisfaction Index) permitiu testar a relação em escala: estudos liderados por Claes Fornell e colegas mostraram que empresas com satisfação consistentemente alta entregam retornos financeiros e de mercado superiores, e carteiras montadas com as líderes de satisfação bateram o mercado em horizontes longos (Fornell et al., Journal of Marketing, 2006; Anderson, Fornell e Mazvancheryl, 2004, documentaram a associação entre satisfação e valor ao acionista). Cautela metodológica de praxe (veja Diferença real ou ruído?): correlação em painel não é cheque em branco causal: empresas bem geridas tendem a ter clientes satisfeitos e bons resultados. Mas os mecanismos que ligam uma coisa à outra são observáveis, testáveis dentro de casa, e é neles que a gestão trabalha. Os cinco mecanismos (onde a satisfação vira dinheiro) 1. Retenção: o cliente que não foi embora.O mecanismo mais estudado. Reichheld e Sasser publicaram na HBR, em 1990, a análise clássica: pequenas melhorias na retenção têm efeitos desproporcionais no lucro, porque cliente retido dilui custo de aquisição, tende a comprar mais com o tempo e custa menos para servir. A conta local: qual o valor médio de um cliente/ano × quantos detratores viram ex-clientes × quantos a recuperação salva (artigo O ciclo fechado: o ciclo interno tem ROI direto por aqui). 2. Boca a boca: o marketing que a operação fabrica.Promotores indicam; detratores desindicam, com alcance assimétrico (a reclamação viaja mais). O custo de aquisição evitado por indicação é mensurável: pergunte “como nos conheceu?” (pergunta 41 do banco, artigo Banco de 50 perguntas de satisfação) e acompanhe a fração “indicação” ao longo do tempo contra a evolução do NPS. 3. Carteira: o cliente satisfeito compra mais.Frequência, tíquete, categorias adicionais. O teste interno é o cruzamento (com os cuidados que toda correlação exige): clientes promotores gastam mais depois de virarem promotores? A ordem temporal ajuda a separar causa de seleção. O quarto mecanismo é o preço, e ele funciona porque a satisfação compra tolerância. Clientes satisfeitos aceitam reajustes com menos evasão, ou seja, a elasticidade-preço cai com a lealdade. Em tempos de inflação de custos, isso vira o colchão que amortece o repasse. O quinto costuma ser esquecido: a operação que erra menos gasta menos. Insatisfação custa caro para dentro, em retrabalho, trocas, compensações, tempo de gestão apagando incêndio e rotatividade de equipe exausta (artigo O elo colaborador-cliente). Reduzir a causa-raiz dos detratores (ciclo externo, artigo O ciclo fechado) é projeto de redução de custo tanto quanto de receita. Montando o caso na prática: a árvore do ROI O caso financeiro de um programa (ou de uma melhoria específica) se monta em quatro passos, todos com ferramentas já apresentadas na série: E o teste contínuo do programa: decisões que mudaram por causa da escuta, com valor estimado. O portfólio de “casos fechados” vale mais que qualquer correlação de slide. As duas armadilhas do caso financeiro A promessa linear. “Cada ponto de NPS vale R$ X” é retórica perigosa: a relação não é linear (sair de 20 para 30 ≠ sair de 70 para 80), varia por setor e por mecanismo dominante, e vira meta goodhartizável na hora (artigos NPS sem mistério e Métricas de vaidade). Prefira sempre a versão por mecanismo: “reduzir detratores de fila em 30% vale ~R$ X em retenção”. O elo invertido no tempo. Resultado financeiro também melhora satisfação (empresa lucrativa investe mais em loja, gente e estoque), a flecha de mão dupla da causalidade. Por isso o caso sério se constrói com experimentos e casos fechados (mudança → movimento medido → resultado), não só com correlações de painel. De volta à Ritmo Na Ritmo, os noventa dias renderam a árvore que faltava: retenção (alunos em risco recuperados pelo ciclo fechado, multiplicados pela mensalidade anual), indicação (matrículas que chegavam com “vim porque me falaram”), carteira (migrações para o plano anual entre os satisfeitos), preço (o reajuste testado que não gerou êxodo) e custo (menos cancelamento, menos negociação de última hora na recepção). Premissas conservadoras, tudo auditável pelo contador, que ajudou a montar. A conta fechou com folga, e a linha amarela mudou de nome no orçamento seguinte, assinada por ele: de “pesquisa (despesa)” para “sistema de escuta (retenção de receita)”. Fábio guardou a lição: “o financeiro não compra fé; compra fluxo. E fluxo se
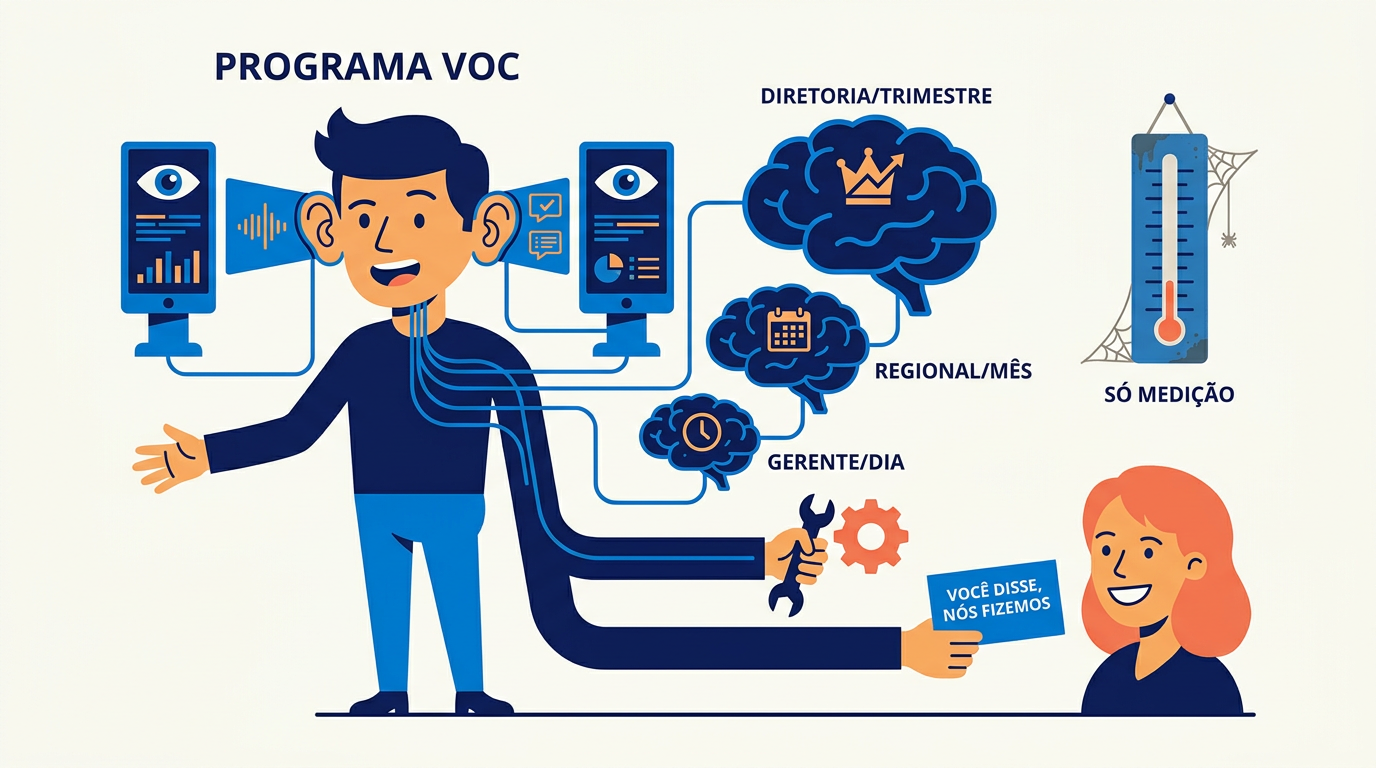
Voz do Cliente: como transformar pesquisa solta em programa de gestão
Um totem instalado não é um programa: é um começo. Programa é quando a empresa inteira sabe o que fazer com a resposta. É essa a diferença entre medir e ter um programa de Voz do Cliente. Nas Farmácias Horizonte O comentário chegou pelo totem de uma das lojas das Farmácias Horizonte, rede de farmácias que cresce por franquias, e doeu mais que uma nota baixa: “Terceira pesquisa da Horizonte que respondo esta semana. Mandaram WhatsApp depois da entrega, o programa de fidelidade mandou e-mail e agora este totem. Vocês pelo menos conversam entre si?”. Marina, que toca a expansão da rede ao lado do pai, o fundador, foi puxar o fio e encontrou o novelo: o marketing disparava NPS por e-mail para a base da fidelidade, o delivery mandava CSAT pelo WhatsApp a cada entrega, e as lojas tinham o totem no balcão. Três áreas, três instrumentos, nenhum sabendo dos outros, e no centro da roda o mesmo cliente: o do remédio de uso contínuo, que compra todo mês e é justamente quem a rede menos pode perder, respondendo tudo até cansar. Mari, consultora da Solvis que atende a rede, deu nome ao diagnóstico quando Marina lhe mostrou o mapa improvisado: a Horizonte não tinha um programa de escuta. Tinha três monólogos simultâneos, disputando o mesmo ouvido. A diferença entre medir e gerir Muitas empresas “fazem pesquisa” do mesmo jeito que muita gente “tem balança em casa”: o instrumento existe, o número aparece, e nada na rotina muda por causa dele. Um programa de Voz do Cliente (VoC, na sigla consagrada do mercado) é outra coisa: é o sistema de gestão que conecta a escuta contínua às decisões da empresa, com donos, ritos, metas e consequências. A pesquisa é o sensor; o programa é o organismo que reage ao sensor. Este artigo, o primeiro do bloco sobre gestão, desenha a anatomia completa desse organismo. Os próximos artigos do bloco detalham cada órgão. Os cinco componentes de um programa de Voz do Cliente que funciona 1. Escuta desenhada (não acumulada).Programas fracos nascem por acúmulo: cada área cria seu questionário, o cliente é metralhado, ninguém enxerga o todo. Programas fortes desenham a escuta de ponta a ponta: quais momentos da experiência do cliente merecem medição (a compra, o pós-atendimento, a relação; artigo CSAT, CES e NPS), qual instrumento em cada um (CSAT transacional no ponto, CES nos fluxos de resolução, NPS periódico), e quanto silêncio o cliente merece entre um contato e outro. O inventário de tudo que se pergunta, com dono e finalidade, é o primeiro entregável de qualquer programa, e frequentemente um exercício constrangedor. 2. Governança: cada número com dono.A pergunta que mata programas: “quem age quando este número se move?” Enquanto ela não tiver um nome próprio como resposta, o dashboard é só uma tela que as pessoas olham de passagem. A estrutura mínima tem três alçadas: o operador local (gerente da loja: age no caso individual, hoje; o ciclo interno do artigo O ciclo fechado), o dono do processo (regional/matriz: age no padrão, no mês; o ciclo externo), e o patrocinador executivo (diretoria: age na estrutura, no trimestre; orçamento, prioridade, gente). Nas empresas em que só o “time de CX” é dono da experiência, ninguém é. 3. Ritmo: a cadência de reuniões que consome os dados.Dado sem rito é arquivo. O programa define onde, quando e por quem cada número é olhado: do semáforo diário do gerente à revisão trimestral da diretoria. É assunto tão central que tem artigo próprio (artigo Rituais de gestão). O quarto componente é o fechamento de ciclo, e ele acontece nas duas pontas. Para o cliente, significa contato, resolução e o “você disse, nós fizemos” (artigo O ciclo fechado). Para dentro de casa, significa o aprendizado registrado virando mudança de processo, treinamento ou produto (artigo A empresa que aprende). Programas que só coletam e reportam são caros e frustrantes, e Reichheld e Markey são taxativos ao dizer que o valor do Net Promoter está no sistema de ação, não no placar. Fecha a lista a prova de valor, porque o programa também presta contas. Um programa de VoC consome dinheiro e atenção, e deve demonstrar retorno com a mesma régua que exige dos outros: detratores recuperados, problemas estruturais eliminados, decisões de investimento informadas (artigo O caso financeiro da satisfação monta esse caso). Métrica de vaidade do próprio programa (“coletamos 1 milhão de respostas!”) não vale (artigo Métricas de vaidade). Os três estágios de maturidade (para diagnosticar a própria empresa) Estágio 1 — Medição: coleta funciona, relatório circula, reação é episódica e depende de heroísmo individual. A maioria das empresas está aqui. Sintoma típico: o NPS é assunto da reunião sobre NPS, não das reuniões de negócio. Estágio 2 — Operação: alertas com dono, ciclo interno rodando, padrões revisados com cadência. A pesquisa entrou na rotina operacional. Sintoma de progresso: gerentes pedem os dados antes de a matriz cobrar. Estágio 3 — Estratégia: a voz do cliente entra nas decisões de investimento, produto e expansão; metas de experiência têm o mesmo status das financeiras; o programa demonstra ROI. Sintoma: o cliente é citado em reuniões onde ele “não deveria” estar (orçamento, obra, contratação). O diagnóstico honesto de estágio vale mais que qualquer benchmark de nota. O trabalho de verdade é mover a empresa do estágio 1 para o 3, e isso é muito mais do que coletar respostas. Os erros que matam programas (vistos de perto) De volta à Horizonte Na Horizonte, os três monólogos viraram um sistema nervoso com desenho: um mapa único de escuta por momento da jornada (balcão, entrega, relação com a rede), donos nomeados para cada sensor (o franqueado no balcão da própria loja, a matriz nos padrões de entrega e fidelidade, Marina como patrocinadora), cadência combinada pelo cadastro da fidelidade para o mesmo cliente não receber duas pesquisas da rede na mesma quinzena, e um rito mensal em que marketing, delivery e operação leem juntos o que o cliente disse, por onde quer que tenha dito. O
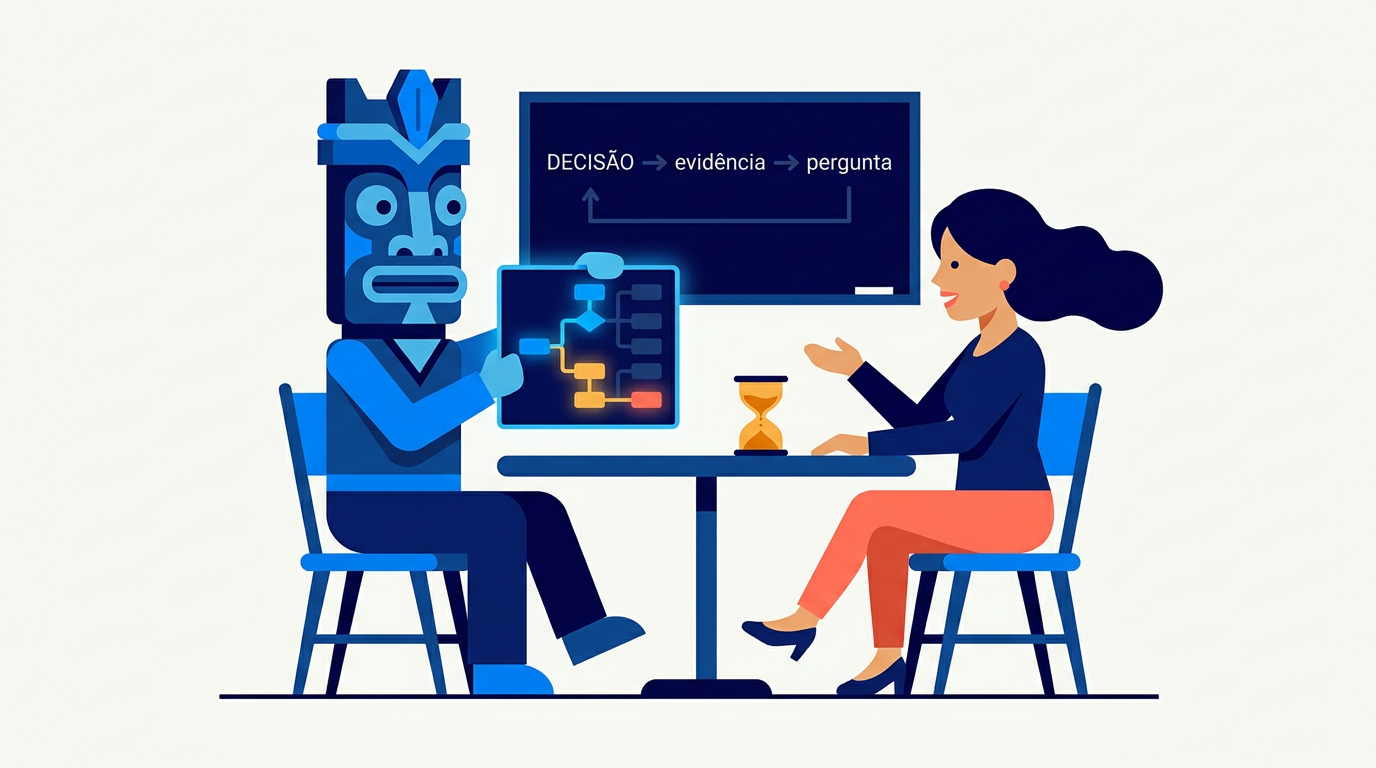
O questionário como conversa: design reverso, fluxo e o respeito pelo tempo do outro
Ninguém desenha uma conversa começando pelas frases. Começa-se pelo que se quer descobrir. Veja como desenhar o questionário como conversa. No Sabor Central O questionário novo dos refeitórios do Sabor Central, empresa de refeições coletivas, foi montado por comitê, e a planilha compartilhada contava a história: uma aba por área, cada uma empurrando “só mais uma perguntinha”. A nutrição queria aceitação prato a prato; o RH da fábrica contratante queria clima; o comercial queria NPS; a segurança de alimentos queria três itens próprios. O resultado final tinha 17 perguntas e boas intenções em todas elas. No piloto, o comensal votou com a bandeja na mão: desistência em massa na pergunta 6, e os que chegavam ao fim respondiam as últimas no piloto automático, tudo 4, tudo igual. Paula levou os números ao comitê e propôs inverter a lógica de construção: — A gente perguntou “o que cada área quer saber?”. A pergunta certa é outra: “que decisão cada área vai tomar com isso?”. Quem não tiver decisão, não tem pergunta. O artefato mais subestimado: o questionário como conversa O artigo Anatomia de uma boa pergunta ensinou a redigir uma boa pergunta; o artigo O cardápio de perguntas, a escolher o tipo certo. Este artigo trata do que fica entre elas e acima delas: o questionário como um todo (a ordem, o fluxo, as ramificações, o que é obrigatório, o tom). É o artefato mais subestimado da pesquisa: todo mundo revisa as perguntas, quase ninguém desenha a conversa. Porque é isso que um questionário é: uma conversa com roteiro, em que só um dos lados fala de improviso. E conversas boas seguem regras que todo mundo conhece intuitivamente: não repetir o que já foi dito, não perguntar o que não interessa, não prender o interlocutor pelo braço. Regra 1: comece pelo fim (design reverso) O erro de origem de 90% dos questionários ruins: começar listando perguntas (“seria bom saber se…”). O método profissional inverte: Repare no subproduto do passo 3: muita coisa não precisa virar pergunta. Horário, loja, dia da semana, histórico: o sistema sabe. Perguntar o que já se sabe é pagar duas vezes. Este é o teste de bancada do artigo Anatomia de uma boa pergunta (“o que faremos com essa resposta?”) promovido a método de projeto: em vez de filtro aplicado no final, vira o ponto de partida. Se uma pergunta não se conecta a nenhuma decisão da etapa 1, ela não entra. A lista de decisões vem primeiro; o questionário é a sombra dela. Regra 2: a conversa se adapta (lógica condicional) Numa conversa real, ninguém pergunta “o que deu errado?” a quem acabou de dizer que estava tudo ótimo. O questionário que faz isso (e a maioria faz) avisa ao respondente que ninguém está ouvindo. A ferramenta é a lógica condicional (skip logic, ramificação): a resposta anterior decide a próxima tela. Três efeitos, todos medidos na literatura de questionários web: o fluxo médio encurta (cada um responde só o seu caminho), a informação por resposta aumenta (as perguntas de diagnóstico chegam a quem tem diagnóstico a dar) e o respondente sente que a conversa faz sentido, o que sustenta a atenção até o fim. A disciplina necessária: ramificação se desenha em fluxograma antes de configurar, e cada caminho se percorre no piloto. Ramo esquecido é pergunta que ninguém nunca vê, e ninguém percebe que ninguém vê. Regra 3: o tempo que importa é o percebido Fadiga de resposta não é lenda: a pesquisa metodológica mostra que, conforme o questionário avança, crescem o abandono, as respostas em linha reta (straightlining, artigo Anatomia de uma boa pergunta) e as não-respostas em itens abertos. Galesic e Bosnjak demonstraram inclusive que a mesma pergunta rende respostas mais pobres quando aparece no final do que no início. Mas o gatilho da fadiga tem menos a ver com o relógio do que com a percepção de esforço. E percepção se gerencia: E a regra de ouro continua absoluta: no ponto de venda, fluxo completo em menos de 30 segundos para o caminho mais comum (artigo O cardápio de perguntas). A estrutura pode adiar a fadiga; não pode revogá-la. Regra 4: obrigatoriedade é exceção, não padrão O botão “resposta obrigatória” parece garantia de dados completos. Na prática, fabrica o contrário: quem não tem a resposta, inventa; quem não quer dar, abandona. Nos dois casos, o dado piora: no primeiro, silenciosamente, que é o pior jeito. Critério profissional: Taxa de pulo, aliás, é informação: se metade dos respondentes pula uma pergunta opcional, ela está cara demais ou irrelevante, candidata a corte na próxima iteração. Regra 5: fale a língua de quem responde A empresa é quem se adapta à língua do cliente, nunca o contrário. “Colaborador do PDV” é vocabulário de crachá; o cliente diz “o moço do caixa”. “Omnicanalidade” não existe fora de slide (artigo Anatomia de uma boa pergunta). A melhor fonte de vocabulário do cliente são os próprios comentários abertos (artigo Quali e quanti): é de lá que se aprende como ele chama as coisas. O tom também conversa: perguntas em linguagem natural (“Deu tudo certo hoje?”) rendem mais engajamento que formulários burocráticos (“Avalie o grau de conformidade do atendimento”), sem perder rigor, desde que a escala continue simétrica e rotulada (artigo Escala Likert). E uma pergunta bem-feita pode ir além de coletar: pode abrir raciocínio. “O que quase fez você desistir da compra de hoje?” desbloqueia uma reflexão que “Avalie sua experiência” jamais alcança: o respondente conta uma coisa que nem ele tinha formulado ainda. Use com parcimônia (é pergunta cara, artigo O cardápio de perguntas), mas use: é onde moram as descobertas. De volta ao Sabor Central No Sabor Central, o critério da decisão desidratou o questionário sem briga: das 17 perguntas, seis sobreviveram ao teste “que decisão muda com esta resposta?”, cada uma com dono e destino anotados na própria planilha. O clima da fábrica saiu (o RH contratante admitiu que decidiria pela pesquisa interna dele, que já existia); a aceitação por prato ficou, amarrada à revisão
Medindo gente: pesquisa para avaliar ações de RH e treinamentos
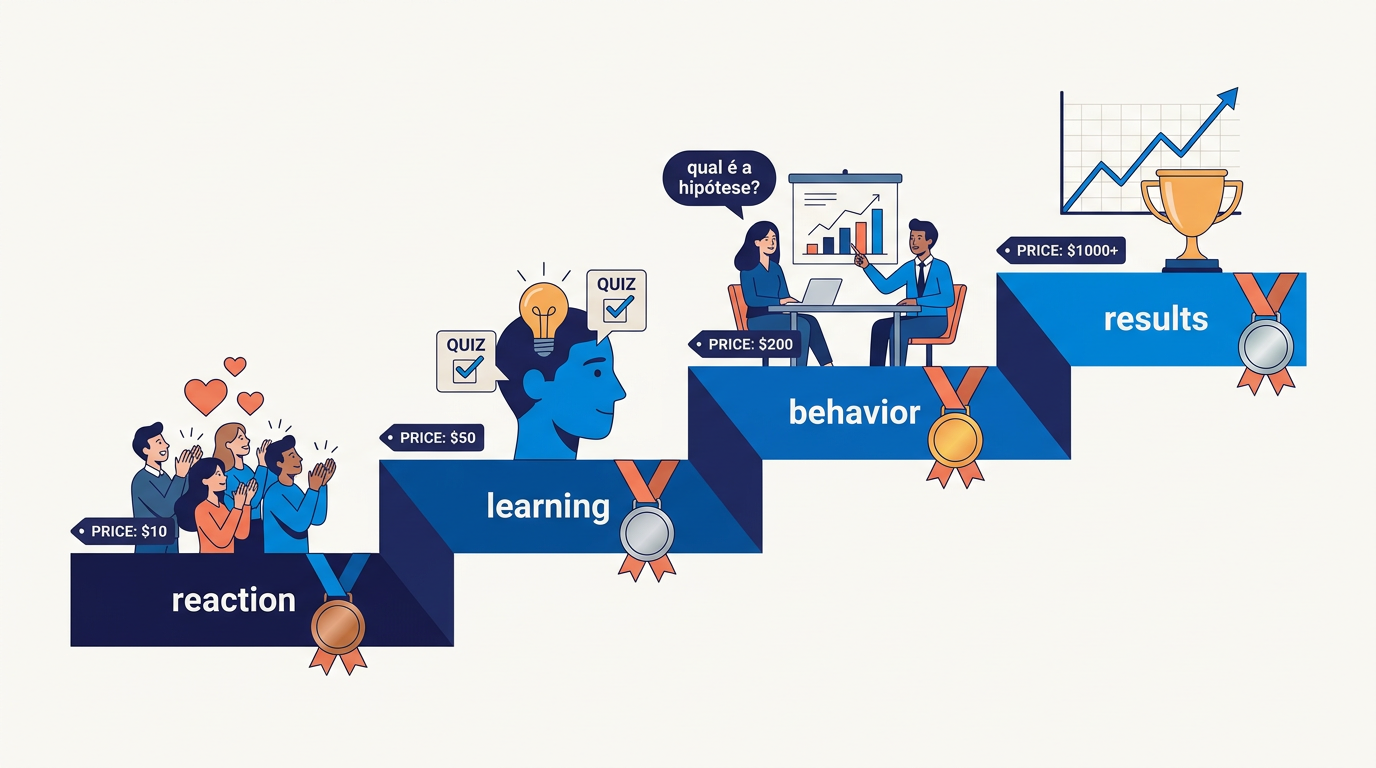
Aplausos no fim do curso não são evidência de que a avaliação de treinamento funcionou; são educação. E o RH que só colhe aplausos está dirigindo sem painel. No Sabor Central O treinamento de atendimento das equipes de balcão do Sabor Central, empresa de refeições coletivas, terminou em aplausos sinceros. O instrutor contratado era ótimo de palco, o formulário de saída deu 9,4 e o RH arquivou o projeto na pasta dos sucessos. Três meses depois, Paula, a nutricionista-chefe, cruzou o formulário com o painel dos refeitórios e trouxe o incômodo para a reunião: as notas de atendimento dadas pelos comensais não tinham se movido um milímetro. Nem as reclamações de má vontade no balcão, nem os elogios nominais. Nada. — "A gente mediu se as equipes gostaram do show. Em nenhum momento medimos se alguém passou a atender diferente. O 9,4 é nota do quê, exatamente?" O silêncio na sala respondeu antes do RH: era nota do instrutor. Do treinamento, ninguém sabia. O problema que vai além do treinamento Todo treinamento corporativo termina com a mesma pergunta implícita: como saber se funcionou? "O pessoal gostou" não basta. Isso é apenas o primeiro degrau da escada de evidência, colhido com viés de gentileza, de quem acabou de viver a experiência e ainda não teve chance de aplicar nada. Mas o problema vai além de qualquer treinamento isolado. Avaliar treinamento é um problema de pesquisa como outro qualquer. E treinamento é só o caso mais visível de uma família inteira: o onboarding que o RH redesenhou, o benefício que mudou, a nova escala de trabalho, o programa de liderança. Toda ação de RH é uma aposta de que algo vai melhorar. E aposta, se testa, não paga pra ver. A boa notícia é que o instrumental para testar já existe: questionário bem desenhado, coleta no momento certo, leitura honesta — o mesmo método usado para medir a experiência do cliente, aplicado agora para dentro. Os quatro níveis de Kirkpatrick Em 1959, Donald Kirkpatrick, então professor da Universidade de Wisconsin, propôs avaliar treinamentos em quatro níveis sucessivos, um modelo tão duradouro que segue sendo o padrão da indústria de T&D: Nível 1 (Reação): eles gostaram?A pesquisa de satisfação do treinamento: relevância percebida, clareza, formato. É o nível mais fácil de medir e o mais fraco como evidência: a literatura de T&D mostra correlação baixa entre "gostar do curso" e "aprender com o curso". Um treinamento pode ser divertidíssimo e vazio; outro, árido e transformador. Serve para: melhorar o material e o formato. Não serve para: declarar vitória. Nível 2 (Aprendizado): eles saíram sabendo?Conhecimento, habilidade ou atitude adquiridos, medidos, idealmente, com comparação antes/depois. É aqui que entra o bom e velho teste, o quiz, o exercício prático. Sem medir o "antes", cuidado: o "depois" sozinho não separa o que o treinamento ensinou do que as pessoas já sabiam. Nível 3 (Comportamento): eles usam no trabalho?A pergunta que separa treinamento de entretenimento corporativo: semanas ou meses depois, o comportamento no trabalho mudou? É o nível mais negligenciado, e o mais importante. Aprender e não aplicar é o desfecho mais comum: a curva do esquecimento de Ebbinghaus corrói rápido o que não é usado, e o ambiente de trabalho (tempo, incentivos, chefia) decide se o novo comportamento sobrevive. Nível 4 (Resultados): o negócio mudou?O efeito final nos indicadores: qualidade, retenção, vendas, erros. É o nível mais difícil, porque aqui entram todos os fantasmas metodológicos de sempre: correlação vs. causa, variáveis de fundo, séries temporais. Raramente se consegue atribuição limpa; consegue-se evidência convergente. Repare no padrão: cada nível acima custa mais para medir e vale mais como evidência. É a mesma economia do cardápio de perguntas, em outra escala. O instrumental de pesquisa, nível por nível Kirkpatrick não é uma teoria de RH, é um plano de coleta. Cada nível tem uma pesquisa certa, um momento certo e uma armadilha conhecida. Nível 1 pede uma pesquisa transacional: a foto, colhida na saída, com a memória fresca. Três perguntas em escala de 5 pontos rotulada, sobre clareza, utilidade percebida e ritmo, mais uma aberta opcional. A regra de ouro: logo após, pergunte sobre percepção, não sobre eficácia. "O conteúdo foi claro?" é respondível na hora. "Você aplicará isso?" colhe intenção educada, que a literatura mostra ser péssimo preditor de comportamento. E resista à tentação do questionário longo: o formulário de reação disputa a atenção de quem quer ir embora, com o mesmo orçamento de 30 segundos do ponto de venda. Nível 2 pede linha de base. O quiz aplicado depois mede uma mistura de treinamento com bagagem prévia; o mesmo quiz aplicado antes, numa turma-piloto, separa as duas coisas. É o "antes e depois" na sua forma mais barata. Prefira situações práticas a definições; decoreba mede memória; cenário mede julgamento. Nível 3 pede pesquisa de acompanhamento 30 a 60 dias depois, com mais de uma fonte. O pacote completo: Nível 4 pede as ferramentas estatísticas de sempre. Ligar treinamento a indicador de negócio é a travessia mais minada da avaliação: a equipe treinada no pior mês melhora sozinha (regressão à média); a variação pode ser ruído ou estação. As defesas para isso são as de sempre: treinar em ondas e comparar quem já passou com quem ainda não passou, buscar dose-resposta, exigir o mecanismo plausível para o acontecimento. Todo cronograma escalonado traz de brinde um grupo de controle gratuito — os que ainda não passaram pelo treinamento podem balizar a comparação. Honestidade metodológica: aqui é aceitável evidência convergente em vez de prova. Aplicando os quatro níveis a um programa de treinamento Um exemplo de como isso se organiza na prática, nível por nível: Além do treinamento: a jornada do colaborador tem momentos da verdade Agora amplie o zoom. A experiência do cliente se mede no momento em que acontece. A jornada do colaborador é feita da mesma matéria: uma sequência de episódios (chegada, aprendizado, mudanças, saída), e cada um tem sua pesquisa certa. O RH que só faz a pesquisa de clima anual está na posição
Quali e quanti: o que os comentários dizem que os números não dizem
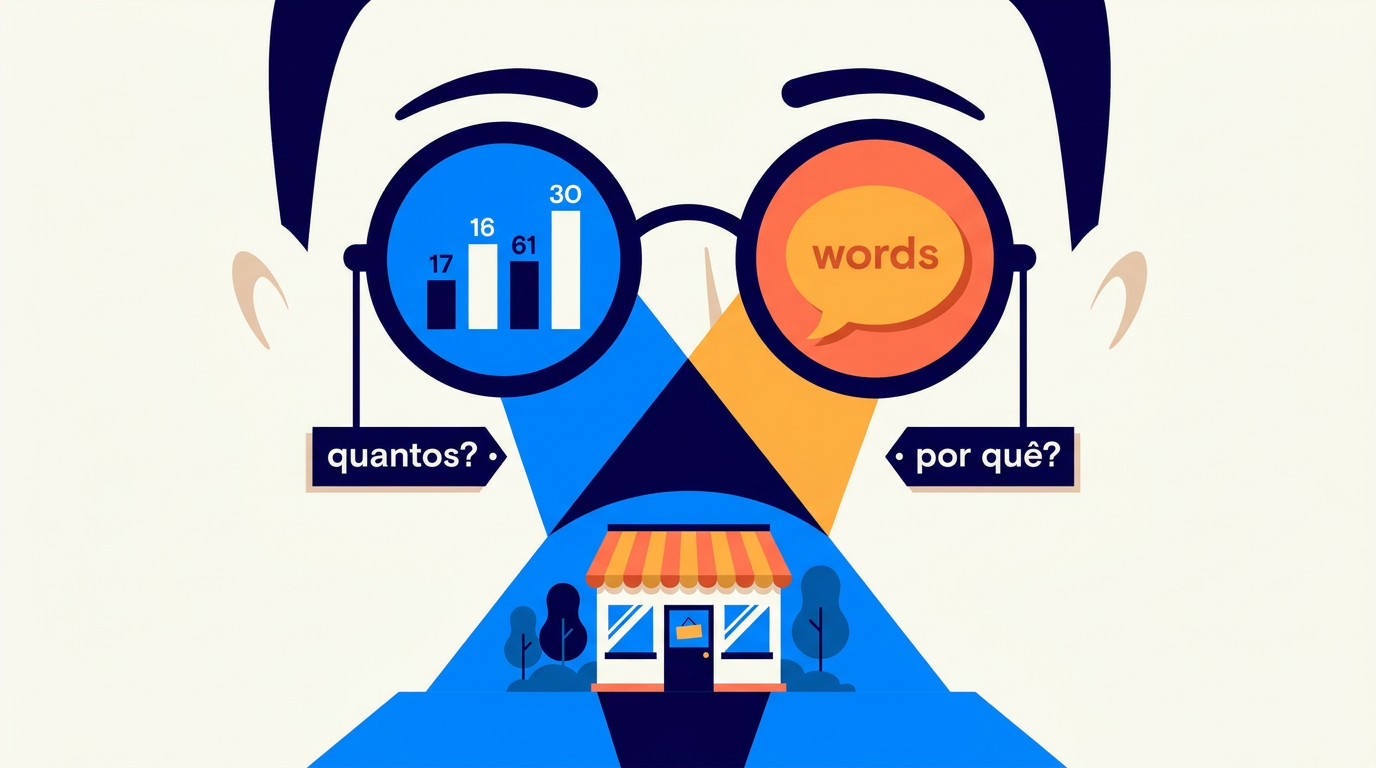
O número conta quantos; o comentário conta por quê. Análise qualitativa e quantitativa juntas evitam dirigir com um olho fechado. No Supermercado Farol A nota da loja principal do Supermercado Farol, rede com cinco lojas, caiu 0,3 num mês. O número era claro, consistente e mudo: dizia que caiu, não dizia por quê. A reunião virou campeonato de palpite: o encarte fraco? o açougue? o calor? Cada palpite com um torcedor, nenhum com evidência. Dona Ivone, a fundadora, encerrou o campeonato com uma caixa de marca-textos. Ela e Caio, o gerente, imprimiram os 200 comentários do mês e leram um por um: verde para elogio, laranja para reclamação, uma palavra de categoria na margem. Na metade da pilha, o padrão já gritava: "padaria vazia à noite" e "só dois caixas abertos" apareciam em uma a cada quatro reclamações. Ninguém na sala tinha palpitado nem de longe naquilo. Análise qualitativa e quantitativa: dois modos de conhecer Toda pesquisa responde a duas famílias de pergunta: Quantitativa (quanti): quantos? quanto? com que frequência? Respostas em números, coletadas de muitos casos, comparáveis e agregáveis. É o território das notas, escalas e porcentagens. Qualitativa (quali): por quê? como? o que significa? Respostas em palavras, histórias e observações, coletadas em profundidade. No mundo do ponto de venda, sua forma mais comum é humilde: o campo de comentário livre do totem. O erro clássico do mercado é tratá-las como rivais: "dados duros" contra "opinião solta". A metodologia científica moderna as trata como fases complementares do mesmo ciclo: a quali gera hipóteses e explica mecanismos; a quanti testa hipóteses e mede magnitudes. Uma sem a outra fica cega de um jeito diferente. O que só o número faz Vale reafirmar a força da quanti antes de defender a quali: Por isso a espinha dorsal de qualquer programa contínuo de escuta é quantitativa. Mas ela tem três pontos cegos estruturais, e são exatamente os pontos fortes da quali. Ponto cego 1: o número não contém o porquê "A satisfação com o atendimento caiu de 4,3 para 3,8." Certo. E agora? Contratar mais gente? Treinar? Trocar a escala? O número aponta o incêndio, mas não diz o que está queimando. Um comentário diz: "a moça do caixa foi super atenciosa, mas fiquei 20 minutos na fila porque só havia um caixa aberto no horário do almoço." Uma frase, e o diagnóstico saltou de "atendimento ruim" (vago, injusto com a equipe) para "dimensionamento de caixas no pico" (específico, acionável, com dono). É a diferença entre saber que e saber por quê. Prática recomendada: nota sem comentário é semáforo sem mapa. A dupla fechada + aberta condicional existe para colher o porquê no momento em que ele está fresco. Ponto cego 2: o número só responde o que foi perguntado Um questionário quantitativo é um menu fechado: mede limpeza, espera, cordialidade… e é cego para tudo que não previu. Se o problema novo é "o QR code do cardápio não funciona", nenhuma das suas escalas vai captá-lo — ele não tem pergunta. O comentário aberto é o radar do inesperado: a única antena apontada para o desconhecido. Na literatura de desenvolvimento de produto isso tem tradição formal: o método "voz do cliente" (Voice of the Customer – VoC) de Griffin e Hauser mostrou que entrevistas e relatos em profundidade com clientes revelam necessidades que os instrumentos fechados não capturam, e que um número relativamente pequeno de conversas já revela a maioria das necessidades de um segmento. Prática recomendada: monitore os comentários procurando categorias que ainda não têm pergunta. Quando um tema novo se repete, ele se formou: merece virar pergunta fechada no fluxo (e aí a quanti assume a medição). Esse é o ciclo virtuoso: a quali descobre, a quanti dimensiona. Ponto cego 3: o número não carrega emoção nem linguagem "Insatisfeito: 23%" é informação. "Levei minha mãe de 80 anos para almoçar no aniversário dela e não havia uma única mesa acessível" é informação com temperatura, e temperatura move decisão (sem emoção, decisão trava). Além da emoção, o comentário entrega a linguagem do cliente: as palavras que ele usa para descrever o problema. Isso vale ouro duas vezes: para escrever perguntas melhores (é dos comentários que se aprende a língua do respondente) e para o storytelling com dados (uma citação verbatim bem escolhida vale um slide inteiro). Como analisar comentários sem virar refém deles A quali tem seus próprios rigores; sem eles, vira coleção de anedotas: 1. Codifique, não folheie. Análise séria de comentários é categorização sistemática: ler e etiquetar cada comentário em temas (as cinco dimensões da qualidade de serviço são um esquema inicial pronto), depois contar as etiquetas. A técnica formal se chama análise de conteúdo, e seu produto final é quantitativo: "31% dos comentários negativos citam espera". Quali e quanti se encontram aqui. 2. Cuidado com quem comenta. Comentário é opcional e custa esforço: quem comenta é amostra auto selecionada, tipicamente os extremos. Comentários dizem quais problemas existem, com riqueza; a proporção de cada problema se confirma na quanti. "Os comentários estão cheios de reclamação de fila" + "a nota de espera caiu" = evidência forte. Só a primeira metade = hipótese. 3. O verbatim ilustra, a contagem sustenta. No relatório, a citação individual dá rosto ao padrão, mas nunca o substitui. A história se ajusta aos dados, nunca o contrário. 4. Volume não se lê no braço, mas a curadoria continua humana. Ferramentas de análise de texto (hoje turbinadas por IA) classificam milhares de comentários em minutos. Úteis, desde que alguém audite as categorias por amostragem: classificador que ninguém confere é caixa-preta gerando confiança injustificada. De volta ao Farol No Farol, o número e o texto fecharam o caso juntos, cada um no seu ofício: a quanti dizia quantos (queda de 0,3, concentrada depois das 18h) e a quali dizia por quê (a última fornada da padaria saía às 17h, e a escala dos caixas não acompanhava o pico da saída do trabalho). Fornada extra às 19h, caixa reforçado no fim de dia, e a nota
Banco de 50 perguntas de satisfação: material de referência
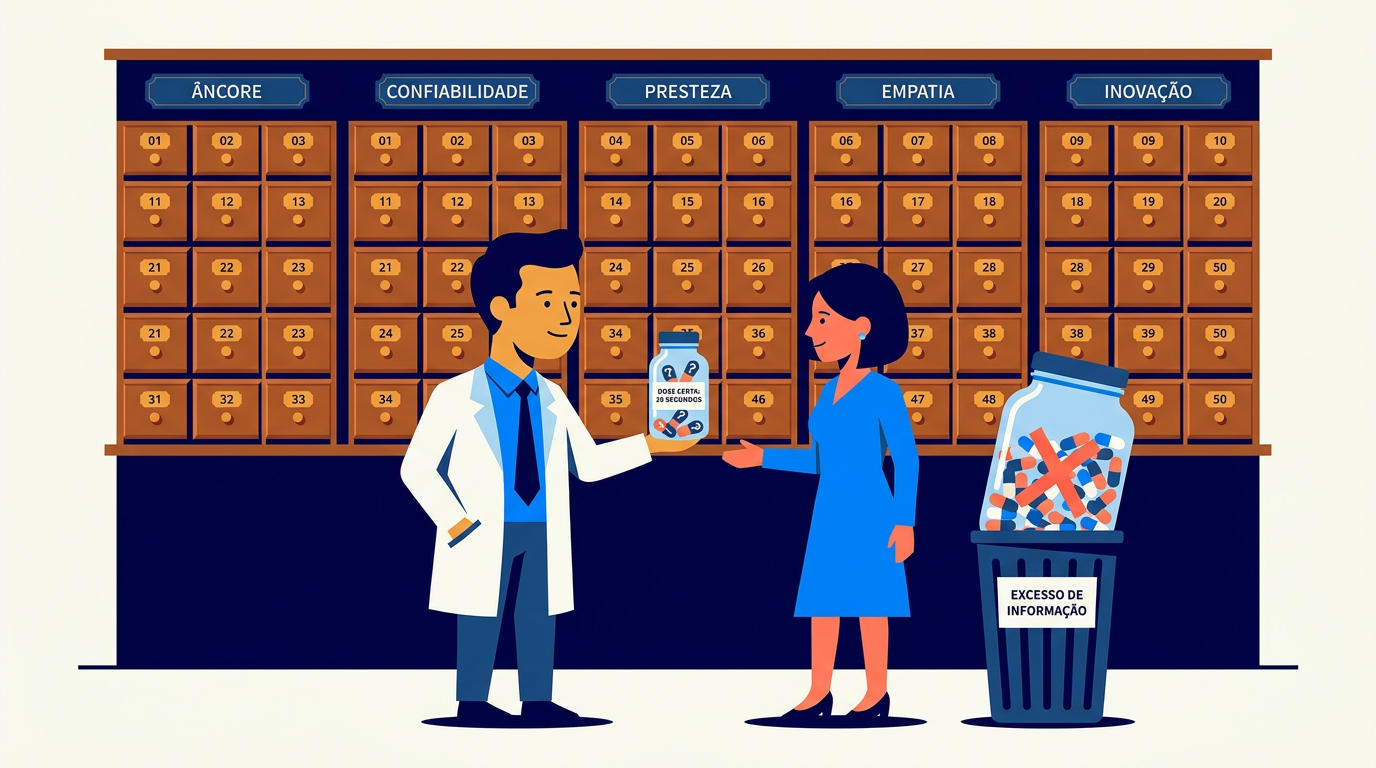
Um banco de perguntas de satisfação é um catálogo curado, não um questionário. Escolha poucas, escolha bem. Na Academia Ritmo Às 23h11, Fábio, dono da Academia Ritmo, rede de academias com três unidades, mandou para Mari, a consultora que atende a conta, o anexo de que estava visivelmente orgulhoso: "Pesquisa nova da unidade do bairro Alto. Fiz do zero, ficou enxuta!". Nove perguntas, criadas naquela noite, na inspiração. Mari leu na manhã seguinte com o café e o catálogo aberto do lado. Das nove, sete tropeçavam em defeitos já catalogados com nome e sobrenome: uma dupla ("estrutura e atendimento"), duas induzidas ("você concorda que…"), uma escala assimétrica, duas genéricas demais para gerar conserto, e uma pedindo CPF sem finalidade. As duas restantes eram boas… e já existiam, melhor redigidas e testadas por meses, no banco de perguntas. A resposta dela coube numa linha: "Você reinventou a roda, e ela saiu quadrada em sete lugares. Vem cá que eu te mostro a prateleira." Como usar este banco de perguntas de satisfação (leia antes de copiar) Este artigo é diferente dos demais da série: é um catálogo de consulta para apoiar quem está montando ou revisando um questionário de satisfação. Use as perguntas como referência, não como um manual imutável e inegociável. A ideia é cobrir a maioria dos casos, mas nenhuma listagem simples trata a totalidade deles. Três avisos inegociáveis: Formato sugerido entre colchetes: [E] escala de satisfação/concordância · [0-10] NPS · [S/N] binária · [M] múltipla escolha/caixas · [A] aberta. A. As três âncoras (métricas centrais) B. Confiabilidade: o prometido foi cumprido C. Presteza: agilidade e disposição D. Segurança: competência e confiança E. Empatia: atenção individual F. Tangíveis: ambiente e estrutura G. Produto (varejo e alimentação) H. Esforço: fluxos de resolução (CES) I. Contexto e segmentação (usar com parcimônia; atenção à LGPD) J. Intenção e relação K. Abertas: as que descobrem o que não sabemos perguntar Três montagens de exemplo (para roubar) Fluxo varejo, 20 segundos: 1 → 3 (condicional se nota baixa, em formato M com as dimensões B–F como opções) → 24 → 47 (opcional). Fluxo alimentação, 25 segundos: 1 → 32 → 9 → 3 (M condicional) → 49 (opcional). Fluxo pós-resolução de problema, 15 segundos: 34 → 36 → 47 (opcional). Repare no padrão: uma âncora, uma ou duas específicas da decisão do momento, um diagnóstico condicional, uma aberta opcional. É o funil de perguntas em ação: do geral ao específico, do barato ao caro. De volta à Ritmo Na Ritmo, a pesquisa do bairro Alto foi remontada em vinte minutos: não escrita, escolhida. Três âncoras do catálogo, duas perguntas da dimensão que a unidade precisava vigiar (limpeza do vestiário, a dor clássica de academia), uma aberta no fim. Cada pergunta com histórico, redação testada e, de brinde, comparabilidade com as outras unidades. Fábio, convertido, virou o maior fiscal da prateleira: "pergunta nova só quando o banco não tem, e aí ela entra no banco depois de testada". A energia das 23h dele continuou existindo; só mudou de alvo: em vez de redigir perguntas na inspiração, passou a caçar decisões que estavam sem pergunta para alimentá-las. O resumo de uma frase (teste Feynman) "Um banco de perguntas é como uma farmácia: o valor não está em tomar tudo, está em saber exatamente qual remédio o caso pede." Fontes e leituras recomendadas As perguntas foram formuladas segundo as diretrizes metodológicas já referenciadas na série: BRADBURN, Norman; SUDMAN, Seymour; WANSINK, Brian. Asking Questions: The Definitive Guide to Questionnaire Design. Jossey-Bass, 2004. PARASURAMAN, A.; ZEITHAML, Valarie A.; BERRY, Leonard L. "SERVQUAL". Journal of Retailing, v. 64, 1988. (Estrutura dimensional das seções B–F.) DIXON, Matthew; FREEMAN, Karen; TOMAN, Nicholas. "Stop Trying to Delight Your Customers". Harvard Business Review, jul.–ago. 2010. (Seção H.) REICHHELD, Frederick F. "The One Number You Need to Grow". Harvard Business Review, dez. 2003. (Pergunta 2.) ICC/ESOMAR. Código Internacional (voluntariedade e minimização de dados — seção I).
As cinco dimensões da qualidade de serviço: o mapa de onde a experiência nasce
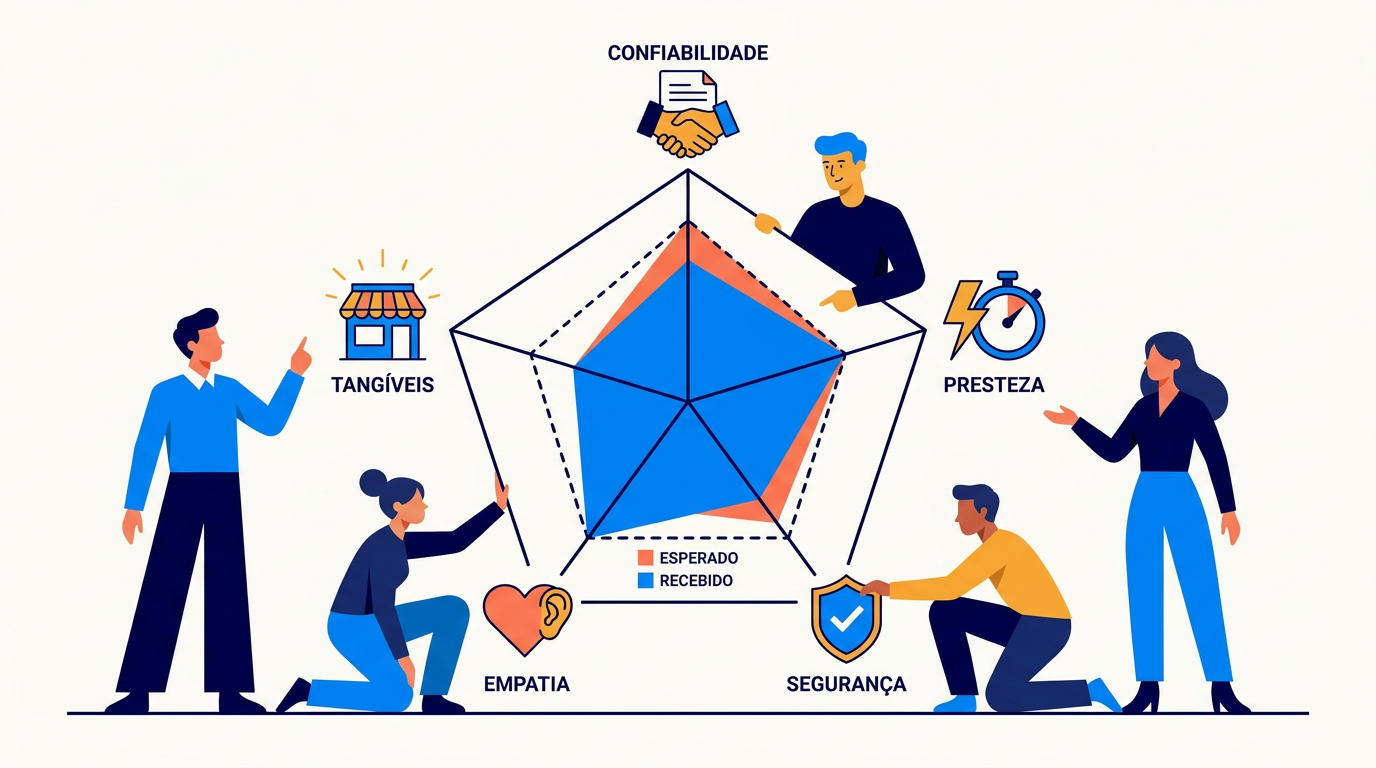
"Atendimento bom" não existe: existem cinco dimensões da qualidade de serviço que os clientes julgam ao mesmo tempo. Na Casa Camélia O comentário chegou pelo totem da Casa Camélia, rede de restaurantes de Curitiba, seco como um SMS: "atendimento ruim". Nota 3. Marcos, o gerente, levou o caso para a reunião rápida da equipe, e a defesa foi imediata e unânime, cada um defendendo uma coisa diferente. "Fomos rápidos o dia inteiro", disse a líder de salão. "Fui atencioso com todas as mesas", disse o garçom veterano. "Ninguém errou pedido", disse o caixa. Todos tinham razão, e a régua de cada um media um atendimento diferente: velocidade, simpatia, precisão. "Atendimento", sozinho, era um guarda-chuva grande demais para caber num diagnóstico. Sobrou para Marcos a pergunta que ele levou para a regional: — Quando o cliente diz "atendimento ruim"… ele está falando de quê, exatamente? O problema de medir o invisível Medir a qualidade de um produto é relativamente fácil: o parafuso tem a rosca certa ou não tem. Mas e a qualidade de um serviço? Um almoço, uma consulta, uma compra no varejo não podem ser postos numa bancada de testes: o serviço é produzido e consumido no mesmo instante, e a "peça" avaliada é uma experiência. Nos anos 1980, três pesquisadores de marketing (A. Parasuraman, Valarie Zeithaml e Leonard Berry) atacaram esse problema com método científico de manual: entrevistaram consumidores e executivos de vários setores de serviço, perguntando o que, exatamente, as pessoas julgam quando julgam um serviço. Do material qualitativo emergiu um modelo; o modelo virou um instrumento de medição (o SERVQUAL, publicado em 1988 no Journal of Retailing); e o instrumento foi refinado até restarem cinco dimensões que se repetem em praticamente qualquer serviço, de banco a restaurante. Quase quarenta anos depois, é um dos frameworks mais citados de toda a literatura de marketing. E é extraordinariamente útil, porque transforma o "atendimento bom" genérico num mapa de cinco territórios mensuráveis. As cinco dimensões (com o teste do restaurante) Para memorizar, o acrônimo em inglês é RATER. Vamos a elas, testando cada uma no mesmo restaurante: 1. Confiabilidade (Reliability): cumprir o prometidoEntregar o que foi prometido, certo, na primeira vez. O prato que veio como descrito no cardápio, a reserva que estava valendo, a conta sem erro. Nas pesquisas dos autores, é consistentemente a dimensão mais importante para os clientes. Ninguém perdoa a promessa quebrada, e nenhuma simpatia compensa o pedido errado duas vezes. 2. Segurança (Assurance): competência que inspira confiançaO cliente sente que está em boas mãos: conhecimento, cortesia, credibilidade. O sommelier que sabe o que recomenda, o caixa que resolve sem chamar três supervisores. Em serviços de risco percebido (saúde, financeiro), esta dimensão explode de importância. Vale um parêntese: aqui, segurança está no sentido de garantia, de estar em boas mãos. 3. Tangíveis (Tangibles): o que os olhos avaliamInstalações, limpeza, equipamento, aparência da equipe. O banheiro do restaurante como "amostra grátis" da cozinha. É a dimensão mais visível, e por isso a proxy que o cliente usa para julgar o que não consegue ver. 4. Empatia (Empathy): atenção individualSer tratado como pessoa, não como senha. Lembrarem da sua mesa preferida, adaptarem o prato à alergia, o atendente que olha nos olhos. É a dimensão que transforma serviço correto em relação. 5. Presteza (Responsiveness): vontade de ajudar, sem demoraRapidez e disposição visível. O garçom que percebe o copo vazio, a fila que anda, o problema resolvido sem "vou ver o que posso fazer" eterno. Note a nuance: não é só velocidade; é a vontade percebida de servir. A ideia mais poderosa do modelo: qualidade é uma subtração O achado conceitual central de Parasuraman, Zeithaml e Berry não são as dimensões, e sim a fórmula por trás delas: Qualidade percebida = desempenho percebido − expectativa O cliente não avalia o serviço em absoluto; avalia contra o que esperava. O mesmo tempo de espera de 10 minutos é ótimo na churrascaria lotada de domingo e inaceitável no fast-food vazio de terça. Duas consequências práticas enormes: O modelo completo dos autores mapeia as "lacunas" (gaps) onde a qualidade se perde: entre o que o cliente espera e o que a gestão acha que ele espera (gap 1), entre o que a gestão entende e o que se especifica (gap 2), entre o que se especifica e o que se entrega (gap 3), e entre o que se entrega e o que se promete na comunicação (gap 4); a soma de todas aparece na diferença entre o esperado e o percebido pelo cliente (gap 5). Vale conhecer: muita nota baixa nasce menos na operação do que na distância entre o que o gestor acha que o cliente valoriza e o que o cliente valoriza de fato. É exatamente a distância que pesquisa bem feita fecha. Do modelo para o ponto de venda: como aplicar isso O SERVQUAL original é um questionário longo (22 itens, dois blocos), inviável no ponto de venda. E o modelo, apesar de citadíssimo, não passou ileso pelos quarenta anos seguintes. Duas críticas resistiram: medir qualidade por escore de diferença (desempenho menos expectativa) é estatisticamente frágil, porque a subtração herda o erro das duas medidas e sai menos confiável do que qualquer uma delas sozinha; e as cinco dimensões, tão limpas no artigo original, raramente se reproduzem intactas quando outros pesquisadores refazem a análise em outros setores, às vezes colapsando em três, às vezes em duas. Foi dessa crítica que nasceu o SERVPERF (Cronin e Taylor, 1992), que mede só desempenho, dispensa o bloco de expectativas e, na evidência dos autores, explica a qualidade percebida tão bem ou melhor. Nada disso derruba o modelo; situa o que ele é. Como mapa do que perguntar, o SERVQUAL é excelente e envelheceu bem; como régua de quanto medir, é um instrumento entre outros, com limites conhecidos (a diferença entre a régua apontar para o alvo certo e a régua ser firme é assunto de validade e confiabilidade de instrumentos de medição — um tema à parte). Na prática, o
O cardápio de perguntas: os tipos que existem e quando usar cada um
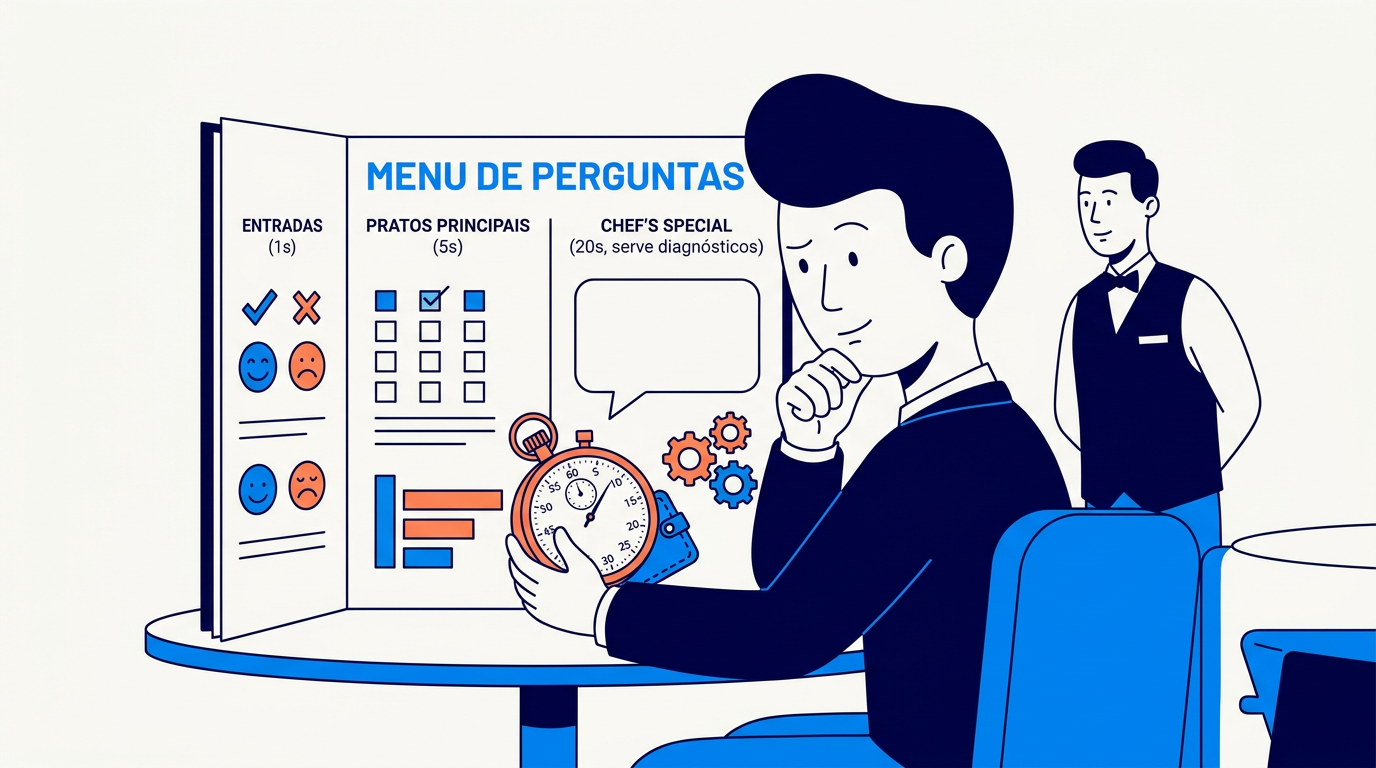
Todo um dos tipos de pergunta de pesquisa cobra um preço em atenção: saiba o que você está comprando com ele. No Restaurante Farol O totem novo na saída do Restaurante Farol, rede com cinco lojas, estreou ambicioso: logo depois da nota, três perguntas abertas em sequência: "o que mais gostou?", "o que podemos melhorar?", "deixe sua sugestão". Caio, o gerente da loja principal, queria riqueza; o desenho prometia. O painel da primeira quinzena contou outra história: seis em cada dez clientes abandonavam na segunda pergunta aberta. Bolsa numa mão, filho na outra, fila atrás: as respostas que sobravam eram "tudo ótimo", "nada", "ok". Teclado de pressa, polegar cansado. Mari, consultora de pesquisa de satisfação, resumiu o diagnóstico diante do funil de abandono: — Cada pergunta custa segundos da atenção de quem responde, e o orçamento na saída de um mercado é de meio minuto, com sorte. Você montou um cardápio só de prato caro. Antes do cardápio, a conta Um bom questionário depende de saber redigir uma boa pergunta, mas depende tanto quanto de escolher o tipo certo, porque cada formato de pergunta é uma ferramenta com custo e benefício próprios. O custo se paga sempre do mesmo jeito: com a atenção do respondente. E no mundo do ponto de venda (cliente em pé, no caminho da saída, celular no bolso vibrando), o orçamento é de segundos. A regra que organiza tudo: quanto mais rica a resposta que o formato promete, mais atenção ele cobra. O ofício está em montar o cardápio que extrai o máximo de informação dentro do orçamento. Vale parar um parágrafo nesse custo, porque ele é fácil de subestimar. A atenção do respondente se parece com dinheiro em três pontos e difere em um quarto ponto. Como dinheiro, é finita: o que uma pergunta gasta falta para a seguinte. Como dinheiro, é cobrada na hora, use você a resposta ou não: a pergunta cujo relatório ninguém abre custa o mesmo que a pergunta que muda uma decisão, só que sem devolver nada. E, como dinheiro, tem dono: o orçamento é do cliente, que empresta por cortesia, sem dever nada e sem prometer a próxima parcela. A diferença é que esse orçamento não se repõe sozinho; ele encolhe com o mau uso. Quem abandonou um questionário comprido hoje aprende a não começar o de amanhã. A literatura chama isso de fadiga de pesquisa; na prática, é queima de base: o questionário ganancioso não encarece só a coleta desta semana, encarece todas as próximas. É com essa conta na cabeça que se lê o cardápio a seguir, do mais barato ao mais caro. Tipos de pergunta de pesquisa econômicos (1 toque, 1 segundo) 1. Escolha binária (sim/não)"Você encontrou o que procurava?" A pergunta mais barata que existe, e subestimada. Perfeita para fatos objetivos e triagem: um "não" pode disparar uma pergunta seguinte ("o que faltou?"). Limite óbvio: zero nuance. 2. Escala visual (carinhas, estrelas, corações)A avaliação de 3 ou 5 pontos em linguagem universal: atravessa idioma, idade e escolaridade, por isso é a rainha do ponto de venda. Pelo mesmo preço da binária (um toque), compra um degrau de nuance. Toda a ciência da escala Likert se aplica: simetria, ordem consistente, um item por tela. 3. Avaliação numérica (0–10, 1–5)A base do NPS e do CSAT. Barata, mas com pegadinha cultural: sem rótulos, cada pessoa inventa sua régua (para muita gente, "7 está ótimo"; para o NPS, 7 é neutro). Rotule as âncoras no mínimo. 4. Escala Likert (concordância)"O ambiente estava limpo: concordo/discordo." Mede atitudes e percepções específicas com custo baixo. Os intermediários (alguns segundos, mais riqueza) 5. Múltipla escolha (uma resposta)"Como você conheceu a loja?" Rápida e tabulável, mas repare onde está o preço: não no toque, e sim na lista. O cliente paga uma leitura por opção antes de escolher, então cada alternativa a mais é um item a mais na conta. Dois cuidados: opções mutuamente exclusivas e completas (com "outro" como válvula), e atenção ao viés de ordem: em telas, as pessoas tendem a favorecer as primeiras opções da lista (efeito de primazia, documentado por Krosnick). Quando a ordem não tem lógica natural, rotacione. 6. Caixas de seleção (múltiplas respostas)"O que motivou sua nota? (marque todos)" É o formato ideal para a pergunta-diagnóstico logo após uma avaliação negativa. Mais rica que a escolha única, um pouco mais cara em atenção. Limite prático no totem: até 6 opções visíveis sem rolagem. 7. Ranking (ordenar preferências)"Ordene do mais ao menos importante: preço, atendimento, variedade…" Informação valiosa (força trade-off, coisa que escala não faz: na escala, tudo pode ser "muito importante"). Mas é dos formatos mais caros cognitivamente: ordenar 6 itens exige 15 comparações mentais. Em autoatendimento rápido, use raramente e com poucos itens; em pesquisas mais profundas de mercado, é onde formatos avançados (como MaxDiff) entram. 8. Matriz (grade de itens × escala)Várias afirmações avaliadas na mesma escala, em tabela. É o formato que mais engana na etiqueta: parece uma pergunta só, mas cobra por linha. Eficiente no papel e no desktop; no celular e no totem é armadilha: favorece straightlining (marcar tudo igual para acabar) e abandono. Prática recomendada: desmembrar a matriz em telas de um item. Mesmo conteúdo, custo por gole. Os premium (custam caro, pagam diferente) 9. Pergunta aberta (texto livre)"O que podemos melhorar?" O formato mais rico que existe: captura o que você não sabia perguntar, a categoria de problema que nenhuma múltipla escolha previu. E o mais caro: digitar exige tempo e disposição, então a taxa de resposta despenca e quem responde é um recorte enviesado (os mais motivados). Uso profissional: sempre opcional, sempre depois das fechadas, e uma só. A dupla de ouro do diagnóstico é fechada + aberta: a nota diz quanto, o comentário diz por quê. 10. Campos de dado (e-mail, telefone, idade)Tecnicamente perguntas, na prática um contrato: o cliente entrega identificação. Custo altíssimo em confiança: cada campo desses reduz respostas e aciona deveres legais (LGPD: minimização e finalidade). Só peça o que tem uso definido, sempre
CSAT, CES e NPS: qual métrica usar quando
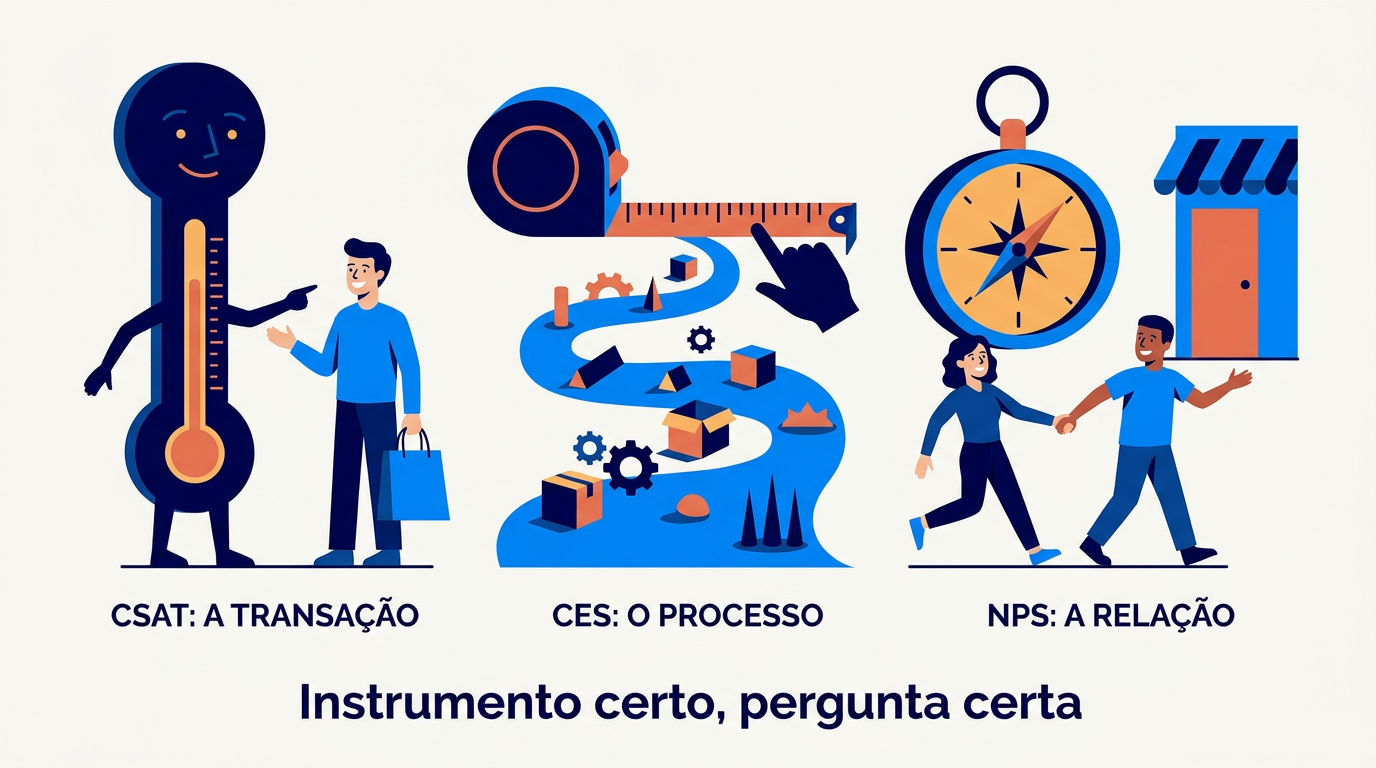
CSAT CES NPS: três siglas, três perguntas diferentes, e a mania de pedir que uma só faça o trabalho das três. Na Vetor Sistemas A reunião de métricas da Vetor Sistemas, empresa de software de gestão B2B, tinha três números na TV e uma discussão emperrada. Rodrigo, diretor comercial, defendia a nota de recomendação: "o que importa é o cliente nos indicar". Camila, de customer success, queria a satisfação com a implantação: "é ali que o cliente decide se confia". E o coordenador de suporte pedia misericórdia: "escolham uma nota só, não dá para acompanhar três". Mari Ferreira, consultora de pesquisa de satisfação, deixou a disputa correr um pouco antes de entrar: — Vocês estão escolhendo entre termômetro, fita métrica e bússola. São três instrumentos. Qual é a pergunta que vocês querem responder? Porque cada um responde uma diferente, e nenhum responde as três. Termômetro, balança e fita métrica Um médico não escolhe entre termômetro e balança: usa cada um para medir o que mede. As três grandes métricas de experiência do cliente funcionam igual: CSAT, CES e NPS não competem; respondem perguntas diferentes. A confusão entre elas (comum até em gente experiente do mercado) produz metas erradas, comparações sem sentido e discussões infinitas. Este artigo é o guia de bolso: o que cada uma mede, de onde veio, quando usar e onde escorrega. CSAT: "Você saiu satisfeito daqui?" A pergunta: "Qual seu nível de satisfação com [esta compra / este atendimento / esta visita]?", tipicamente numa escala de 1 a 5 (muito insatisfeito → muito satisfeito). O que mede: a avaliação de uma transação específica, logo depois dela. É a métrica do "aqui e agora". A conta usual: % de respostas nos dois pontos do topo (4 e 5, os "satisfeitos"). Um CSAT de 87% significa: 87 em cada 100 avaliações ficaram no topo da escala. Por que contar respostas em vez de tirar a média das notas? Primeiro, porque contar pessoas comunica melhor do que somar pontos: "87 em cada 100 saíram satisfeitos" dispensa tradução; "média 4,2" não. Segundo, porque a média esconde os extremos e trata degraus de rótulo como números equidistantes, o que a escala não garante. E o corte no topo é proposital: o 3 do "mais ou menos" não conta a favor; só entra na conta quem disse com clareza que saiu satisfeito. Linhagem: a satisfação é o construto mais antigo e estudado da área. É a base do ACSI (American Customer Satisfaction Index), o índice nacional americano criado por Claes Fornell na década de 1990, com décadas de estudos ligando satisfação a recompra e tolerância a preço. Onde brilha: diagnóstico operacional. Por ser transacional e específica ("satisfação com a fila", "com a limpeza", "com o atendimento"), aponta o que consertar e onde. É a métrica natural do totem no ponto de venda: experiência fresca, pergunta concreta, resposta em um toque. Onde escorrega: satisfação é só o ingresso: cliente satisfeito ainda troca de marca por preço ou conveniência. CSAT alto e estável pode esconder indiferença confortável. CES: "Deu trabalho resolver?" A pergunta do CES, na versão atual (CES 2.0), é uma afirmação com que o cliente concorda ou discorda: "a empresa facilitou a resolução do meu problema". O que ela mede é o esforço que o cliente gastou para conseguir o que queria, ou seja, quantas ligações, quantas repetições da mesma história, quantos obstáculos. A conta: o cliente responde numa escala de 1 a 7, de "discordo totalmente" a "concordo totalmente", e o placar sai como média das respostas (o padrão do Gartner) ou como % de concordância (respostas de 5 a 7), leitura mais segura pelo mesmo motivo do CSAT: distribuição engana menos que média. O formato de afirmação também tem um porquê: a versão original de 2010 perguntava "quanto esforço você gastou?" numa escala em que nota alta era notícia ruim, e essa polaridade invertida confundia o respondente e o leitor do relatório. O CES 2.0 refez a pergunta para que concordar aponte sempre na mesma direção: quanto maior, melhor. A métrica nasceu de um estudo do CEB (hoje parte do Gartner) publicado na Harvard Business Review em 2010 com um título provocador: "Stop Trying to Delight Your Customers" (pare de tentar encantar seus clientes). A descoberta, baseada em dezenas de milhares de atendimentos, foi que reduzir esforço prevê lealdade melhor do que encantar. Clientes não abandonam empresas por falta de "uau"; abandonam por excesso de atrito. A deslealdade nasce do retrabalho: repetir o problema, ser transferido, ter que insistir. O CES brilha em pós-atendimento, suporte, trocas, resolução de problemas e processos como cadastro, retirada e devolução. Se o processo tem um funil onde clientes "empacam", o CES encontra. Onde ele escorrega é fora desse contexto: não faz sentido perguntar esforço depois de um almoço agradável. E como mede apenas a fricção, uma experiência pode ser fácil e ainda assim medíocre. NPS: "Você apostaria sua reputação em nós?" O que mede lealdade e entusiasmo com a marca como um todo já tem artigo próprio nesta série, então só o essencial comparativo: O que mede: lealdade e entusiasmo com a marca como um todo, mais do que com a transação de hoje. Recomendação envolve colocar a própria reputação em jogo, por isso é régua mais dura que satisfação. A conta: % de promotores (notas 9 e 10) menos % de detratores (0 a 6), com os neutros (7 e 8) fora da subtração; o placar vai de −100 a +100. A subtração existe para endurecer a régua: a nota educada não conta a favor, e cada insatisfeito desconta um entusiasta em vez de se diluir numa média. Onde brilha: visão estratégica, acompanhamento de longo prazo, comparação entre unidades e benchmark com concorrentes (medidos do mesmo jeito). Onde escorrega: é termômetro, não diagnóstico: diz que a marca esfriou, mas não diz qual torneira vazou. E balança muito em amostras pequenas (a conta de % menos % dobra a sensibilidade ao ruído). CSAT CES NPS lado a lado: a tabela de bolso CSAT CES