
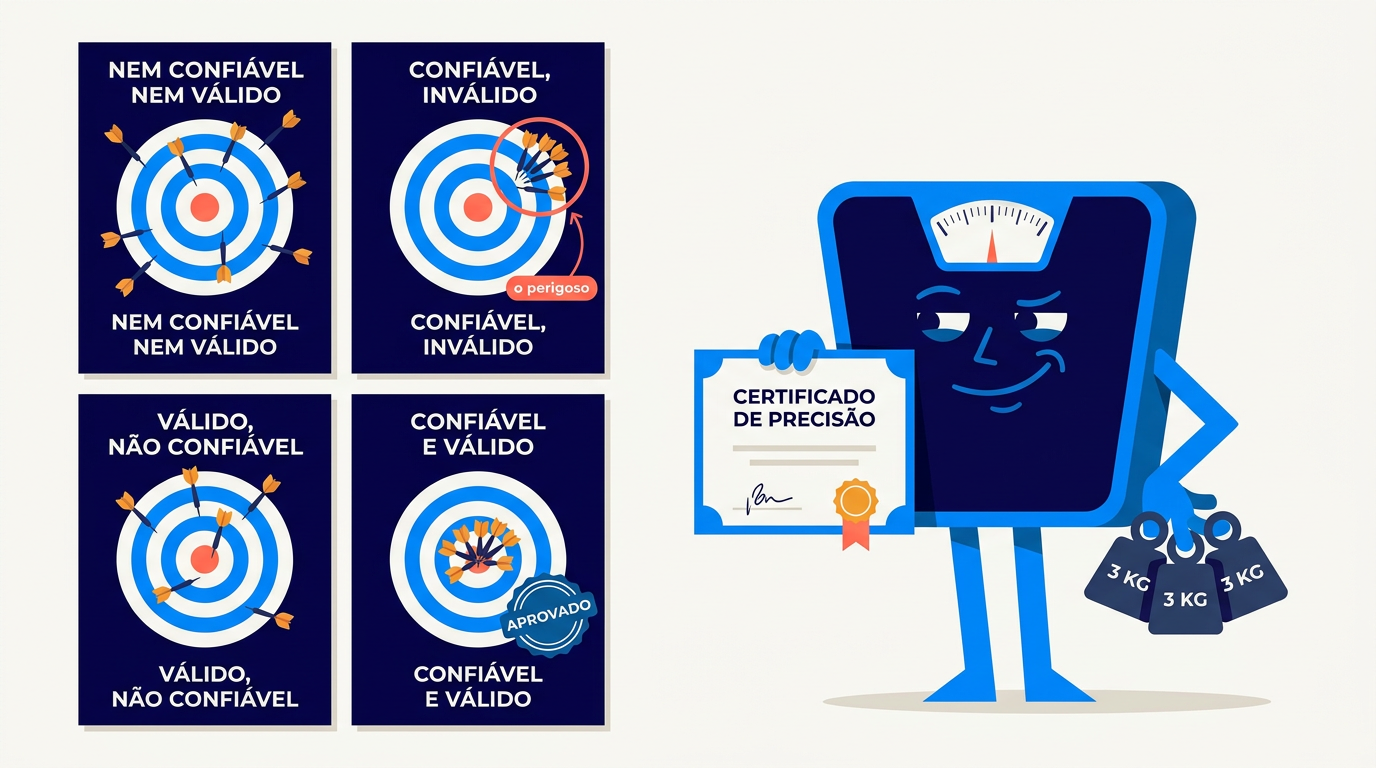
Uma balança que marca sempre 3 quilos a menos é confiável, e mente todos os dias. Validade e confiabilidade são as duas perguntas que todo instrumento de medição precisa responder. Na Clínica Aurora Na auditoria anual do questionário da Clínica Aurora, rede de clínicas médicas, Wagner, o administrador, parou numa pergunta veterana: “Você se sentiu bem na clínica?”. Criada dois anos antes, ela tinha um propósito original de que quase ninguém lembrava: monitorar a limpeza das unidades. A série histórica denunciava o problema: a nota oscilava com o tempo de espera, despencava nas semanas de calor (ar-condicionado no limite), subia em dezembro com a decoração de fim de ano, e permanecia serenamente indiferente aos dois episódios reais de falha de limpeza que a clínica tinha registrado no período. O instrumento era estável, até consistente no seu jeito: media alguma coisa, sempre do mesmo modo. Só não media limpeza. Media um humor geral de “estar bem”, temperado de espera e temperatura. — A régua não treme — resumiu Wagner para Mari, a consultora da Solvis. — Ela aponta para o alvo errado, com firmeza admirável. Validade e confiabilidade: as duas perguntas que ninguém faz ao instrumento Antes de confiar em qualquer medição (de temperatura, de peso ou de satisfação), a metrologia faz duas perguntas distintas: São independentes, e a combinação delas define quatro destinos possíveis para uma pesquisa. A imagem clássica é o alvo de dardos: O mercado de pesquisa vive cheio de balanças do segundo tipo: séries históricas lindas, estáveis, comparáveis, medindo consistentemente a coisa errada. Confiabilidade: o instrumento não pode tremer Três formas práticas de tremor, e como detectá-las: Tremor no tempo (estabilidade). Se nada mudou na operação, a medição deveria dar parecido esta semana e na próxima. Oscilação grande sem causa é sinal de instrumento ruim, ou de amostra pequena demais (artigo Amostra: antes de culpar o instrumento, confira a margem de erro; artigo Diferença real ou ruído?: diferença real ou ruído?). Tremor entre itens (consistência interna). Se cinco perguntas pretendem medir a mesma dimensão (digamos, “presteza”; artigo As cinco dimensões da qualidade de serviço), as respostas delas deveriam andar juntas. Quando uma destoa sistematicamente das irmãs, ela provavelmente mede outra coisa. A psicometria tem um índice clássico para isso, o alfa de Cronbach, que resume o quanto os itens de um grupo variam juntos. Não é preciso calculá-lo à mão; é preciso saber que a pergunta “esses itens medem mesmo a mesma coisa?” tem resposta verificável. Tremor entre leitores (concordância). Vale para a análise qualitativa: dois analistas categorizando os mesmos comentários (artigo Quali e quanti) deveriam chegar a etiquetas parecidas. Se cada um classifica de um jeito, o “31% citam espera” muda conforme quem conta. O instrumento aqui é o esquema de categorias, e ele está trêmulo. O que mais destrói confiabilidade na prática: perguntas ambíguas (cada um entende uma coisa; artigo Anatomia de uma boa pergunta), escalas sem rótulos (cada um inventa a régua; artigo Escala Likert) e mudanças de redação no meio da série histórica (mudou a pergunta, nasceu outro instrumento e a série quebrou; artigo Escala Likert, pecado 3). Validade: o instrumento não pode apontar para o lugar errado Quatro testes, do mais barato ao mais forte: 1. Validade de face: o teste do cheiro. A pergunta parece medir o que promete, para quem lê? “Você recomendaria?” tem cara de lealdade; “quantas estrelas?” tem cara de… alguma coisa. É o teste mais fraco, mas filtra os absurdos. O pré-teste cognitivo é onde ele acontece de verdade: descobrir o que o respondente entendeu pode ser bem diferente do que se perguntou. 2. Validade de conteúdo: o mapa cobre o território? “Satisfação com a loja” tem dimensões (artigo As cinco dimensões da qualidade de serviço: confiabilidade, presteza, segurança, empatia, tangíveis). Um questionário que só pergunta sobre limpeza mede um pedaço e assina pelo todo. Teste prático: liste as dimensões da experiência real do cliente (os comentários abertos são o mapa; artigo Quali e quanti) e confira o que o questionário cobre. 3. Validade de construto: o número se comporta como o conceito? Se sua métrica mede mesmo satisfação, ela deveria se relacionar com as coisas que a teoria manda: subir quando o serviço melhora, andar junto com recompra, cair após incidentes. Métrica que não reage a nada que deveria movê-la está medindo outra coisa (ou nada; artigo Métricas de vaidade). 4. Validade preditiva: o teste supremo. A nota de hoje prevê o comportamento de amanhã? Detratores abandonam mais? Notas de espera baixas antecedem queda de fluxo no horário? É o teste mais caro, porque exige cruzar pesquisa com comportamento real ao longo do tempo (artigo Tipos de pesquisa, pesquisa preditiva), e o único que fecha a questão. A literatura que ligou satisfação a resultado financeiro (artigo O caso financeiro da satisfação) é exatamente isso: validação preditiva em escala acadêmica. O checklist do instrumento honesto Antes de confiar numa série de dados, sua ou de terceiros: Cinco perguntas que separam medição de ritual. Por que isso importa Quando alguém pergunta “essa pesquisa funciona mesmo?”, está perguntando, sem o vocabulário, sobre validade e confiabilidade. Quem domina esses conceitos responde com critérios, não com convicção: mostra a consistência da série, o vínculo entre nota e comportamento, a cobertura das dimensões. É a diferença entre pedir confiança e demonstrá-la. De volta à Aurora Na Aurora, a pergunta simpática e inválida foi aposentada com honras e substituída por duas específicas, cada uma mirando o que a decisão precisava: limpeza (“recepção, consultório e banheiro estavam limpos?”) e conforto (“espera, temperatura e acomodação estavam bem?”). Na primeira falha de limpeza seguinte, a pergunta nova acusou o golpe em dois dias: exatamente o que a antiga nunca tinha feito. A auditoria anual ganhou o ritual dos alvos de dardos: para cada pergunta do questionário, “ela acerta sempre o mesmo lugar?” (confiabilidade) e “o lugar que ela acerta é o que queremos medir?” (validade). Pergunta que treme, conserta-se; pergunta que aponta para o alvo errado, por mais firme que seja, troca-se. O resumo de
Vieses do respondente: o que distorce a resposta antes de ela chegar ao dado
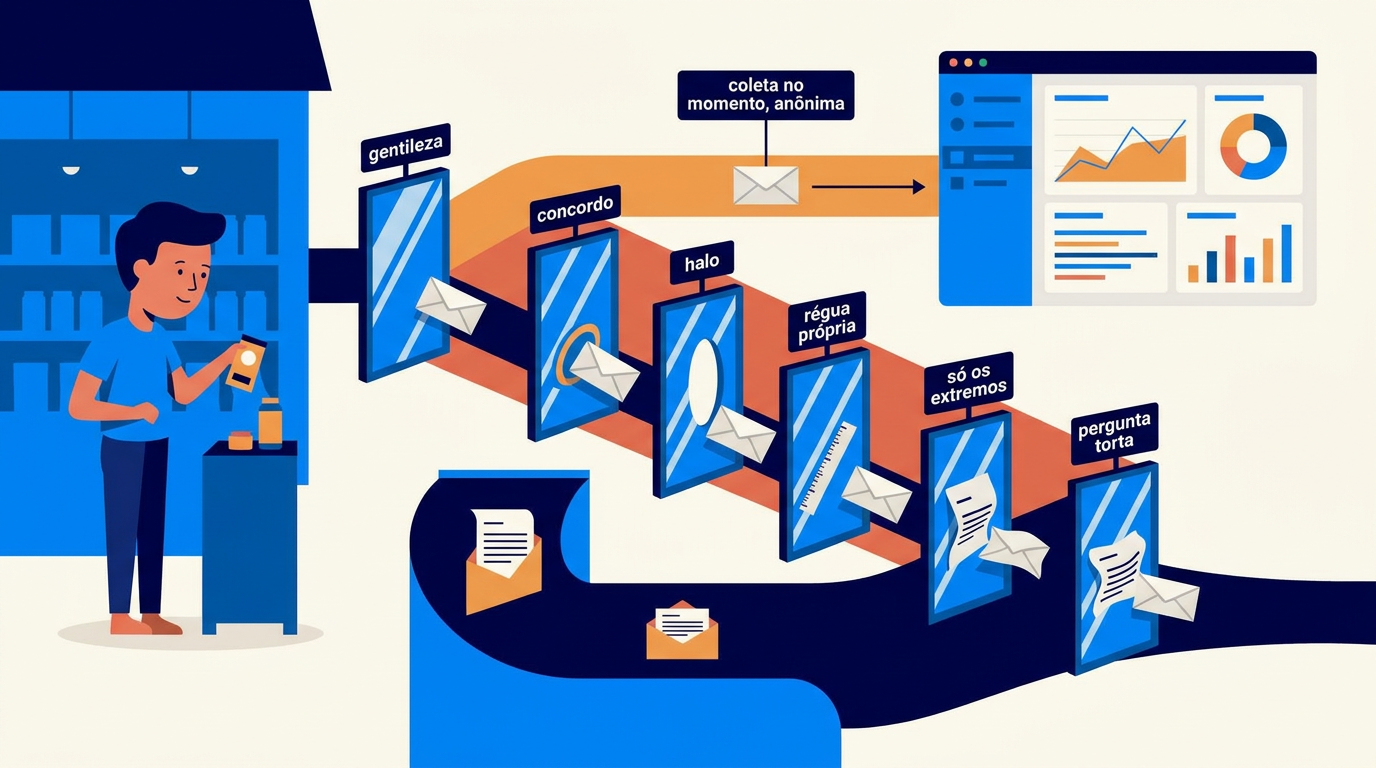
Os vieses de quem lê os dados são bem conhecidos. Os vieses do respondente, os de quem produz o dado, agem antes: nenhuma estatística posterior conserta o que já chegou torto. Na Clínica Aurora O coordenador mais novo da Clínica Aurora, rede de clínicas médicas, queria mostrar serviço e resolveu reforçar a medição por conta própria: passou uma semana na saída dos consultórios com uma prancheta, colhendo avaliações paciente a paciente, com sorriso e caneta em punho. Resultado: média 4,9. Mandou no grupo de coordenadores com três foguetes. Mari Ferreira, consultora da Solvis que acompanha a conta da Aurora, abriu na mesma tela o número do totem da mesma unidade, na mesma semana: 4,1. — Alguém aí está mentindo — disse o coordenador, meio rindo, meio ofendido. — Ninguém está mentindo — respondeu Mari, com a sobrancelha erguida de quem já tinha visto esse gráfico antes. — Mas pense no que é dizer “achei ruim”, olhando nos olhos, dentro da clínica que cuida da sua saúde. Uma dessas duas pesquisas está medindo outra coisa. Quer descobrir qual? O outro lado da balança: os vieses do respondente Os atalhos mentais de quem analisa (confirmação, ancoragem, sobrevivência) são só metade do problema. Há uma segunda família de vieses, que age antes, dentro da cabeça de quem responde. Eles distorcem o dado na origem, e nenhuma estatística posterior conserta o que já chegou torto (artigo Anatomia de uma boa pergunta: viés na entrada, lixo na saída). A boa notícia: são conhecidos, catalogados há décadas pela metodologia de pesquisa, e quase todos têm antídoto de projeto. Eis os sete que mais atacam pesquisas de satisfação. 1. Desejabilidade social: a resposta que fica bem As pessoas ajustam respostas para parecer (e se sentir) bem: mais generosas, mais saudáveis, menos reclamonas do que são. Em satisfação, o efeito clássico é a nota-gentileza: o cliente que não quer “prejudicar a moça do caixa” e dá 5 para uma experiência 3. O efeito cresce com a presença humana: pesquisa respondida na frente de um entrevistador (ou do próprio atendente) infla sistematicamente as notas, fenômeno medido em décadas de comparações entre modos de coleta. Antídoto de projeto: anonimato real e autoatendimento. O respondente sozinho diante da tela diz mais verdade do que diante de uma pessoa. É um argumento científico direto a favor do totem contra a prancheta do promotor. E nunca peça a avaliação através de quem está sendo avaliado (“dá uma notinha pra mim?”). 2. Aquiescência: a tendência a concordar Já apresentada nos artigos Anatomia de uma boa pergunta e Escala Likert: diante de uma afirmação, parte das pessoas concorda por padrão, qualquer que seja o conteúdo. Quando dá, prefira escalas de avaliação às de concordância e formule afirmações neutras. Em questionários longos, vale alternar o sentido das afirmações para flagrar quem concorda com tudo. 3. Halo na resposta: uma impressão pinta todas as notas O mesmo efeito halo que distorce quem analisa, agora do lado de lá: uma impressão dominante (o atendente simpático, a fila revoltante) contamina a avaliação de todos os itens. O cliente encantado com a vendedora dá 5 até para a limpeza do banheiro em que não entrou. Sinal de alerta na análise: notas idênticas em todos os itens, sem variação. Antídotos: perguntas específicas e concretas em vez de genéricas (“a fila andou rápido?” sofre menos halo que “avalie o atendimento”), o “não sei/não usei” como saída honesta (artigo Anatomia de uma boa pergunta), e a leitura por distribuição, que revela o bloco de respostas em linha reta. 4. Recência e pico: a memória edita a experiência A memória não guarda a média da experiência; guarda o pico e o final (a regra do pico-fim, documentada por Kahneman e Redelmeier). Uma hora de jantar impecável com dez minutos finais de espera pela maquininha vira, na lembrança, “demorou”. E quanto mais tempo passa, mais a edição avança (artigo O momento da verdade: Ebbinghaus). Antídotos: coletar no momento (a resposta de agora é menos editada) e saber o que se está medindo: a pesquisa transacional colhe a experiência; a relacional, semanas depois, colhe a memória da experiência (artigo Tipos de pesquisa). As duas são informação, mas não a mesma informação. 5. Estilos de resposta: cada pessoa tem uma régua Há quem nunca dê nota máxima (“10 é só pra Deus”) e quem dê 10 para tudo que não ofende. Há inclusive padrões culturais documentados: populações inteiras mais propensas aos extremos ou ao centro da escala. Entre lojas de perfis demográficos muito diferentes, parte da diferença de nota diz mais sobre a régua de cada público do que sobre a experiência. Antídotos: rótulos verbais em todos os pontos (artigo Escala Likert, que encurtam a variação de interpretação), comparar cada unidade com ela mesma no tempo antes de compará-la com as outras, e ligas de comparáveis (artigo Comparações justas). 6. Auto-seleção: o viés de quem aparece O mais estatístico dos vieses de respondente, já dissecado no artigo Amostra (Literary Digest): quem escolhe responder não representa quem não escolheu. Os extremos (encantados e furiosos) respondem mais; o meio silencioso, que é a maioria, some. A defesa está na coleta no fluxo natural da experiência, por onde todo perfil passa, e na fricção mínima, porque cada segundo de esforço a mais filtra mais gente do meio. Monitorar a taxa de resposta, e não só as notas, é o que revela a saúde da coleta. 7. Vieses embutidos no enunciado: quando o autor sabota Os três sabotadores que a redação instala dentro da pergunta: A tabela de bolso Viés O que faz Antídoto principal Desejabilidade social Nota-gentileza Anonimato, autoatendimento Aquiescência “Concordo” com tudo Avaliação em vez de concordância Halo Uma impressão pinta tudo Perguntas concretas + “não usei” Recência/pico Memória editada Coletar no momento Estilos de resposta Cada um com sua régua Rótulos verbais; comparar no tempo Auto-seleção Só os extremos aparecem Coleta no fluxo, fricção mínima Enunciado viciado A pergunta sopra a resposta Redação neutra, positiva, sem âncora Por que isso importa Metade desses vieses é atenuada por
Tipos de pesquisa: transacional, relacional e preditiva
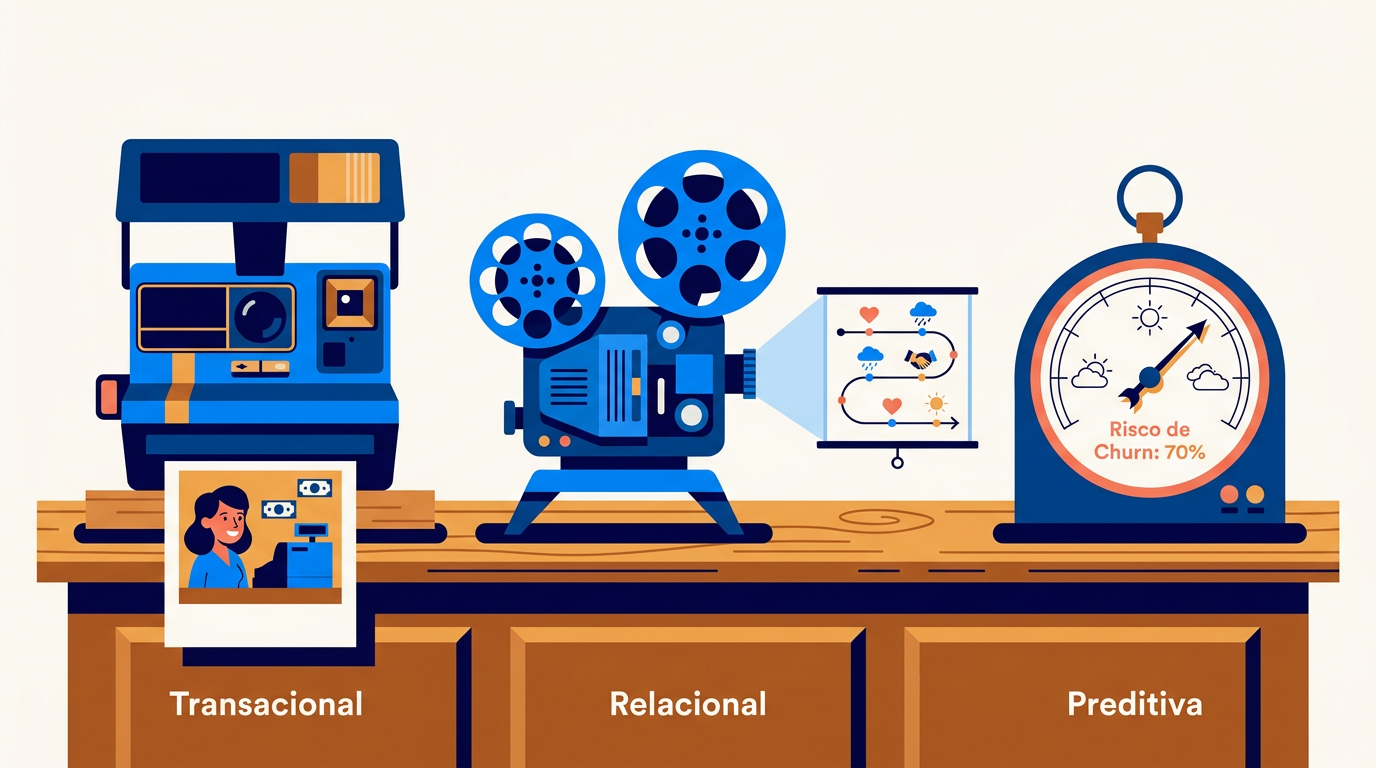
A foto, o filme e a previsão do tempo: três pesquisas diferentes que o mercado insiste em chamar pelo mesmo nome. Conhecer os tipos de pesquisa evita comparar números que medem coisas diferentes. Nas Farmácias Horizonte O e-mail chegou para Mari Ferreira, consultora da Solvis que atende as Farmácias Horizonte, com dois prints e um desabafo de um franqueado: “Me ajuda a entender. O NPS do totem deu 72. A pesquisa anual que a franqueadora mandou por e-mail deu 45. MESMA FARMÁCIA. Um dos dois só pode estar errado, e eu preciso saber qual antes da reunião de sexta, porque com 72 eu ganho selo e com 45 eu ganho advertência.” Mari leu os dois prints e reconheceu o par na hora: a mesma pergunta, feita em dois momentos completamente diferentes, medindo duas coisas completamente diferentes. E percebeu, pelo tom do desabafo, que o problema maior nem era estatístico: era que selo e advertência estavam pendurados em dois números que a rede tratava como sinônimos. “Vamos fazer uma pesquisa” não diz nada Quando um cliente diz “quero medir a satisfação”, a primeira pergunta profissional não é “com quantas perguntas?” nem “com qual escala?”. É: que tipo de pesquisa você precisa? Porque existem três, e confundi-las produz alguns dos erros mais caros da área: metas compostas de números que não se comparam, questionários que perguntam a coisa certa na hora errada e dashboards que misturam foto com filme. Pesquisa transacional: a foto A pergunta implícita: “Como foi esta experiência?” Dispara logo após um evento específico: a compra, o atendimento, a visita, a entrega. Mede a experiência ainda fresca na memória (artigo O momento da verdade: o momento da verdade), com perguntas concretas sobre aquele episódio: satisfação com a fila, com a limpeza, com quem atendeu. CSAT e CES são suas métricas naturais (artigo CSAT, CES e NPS). Características técnicas: Onde escorrega: a transacional enxerga árvores, não a floresta. Um cliente pode dar nota alta em dez visitas seguidas e ainda assim estar a um reajuste de preço de trocar de marca. Satisfação com episódios não é a mesma coisa que força da relação. Pesquisa relacional: o filme A pergunta implícita: “Como está a nossa relação, somando tudo?” Não dispara por evento: acontece em ciclos (trimestral, semestral, anual), com uma amostra da base de clientes, inclusive os que não visitaram recentemente, e principalmente eles. Pergunta sobre o acumulado: recomendação (NPS é a métrica clássica aqui), intenção de continuar, percepção da marca, comparação com alternativas. Características técnicas: Onde escorrega: memória. A relacional pergunta em março sobre experiências de janeiro, e a resposta vem editada pela memória (artigo O momento da verdade), mais influenciada pelo pico e pelo fim das experiências do que pela média delas. E o convite por e-mail ou telefone sofre auto-seleção crônica: respondem os extremos. O erro clássico do mercado: perguntar NPS (pergunta relacional: “recomendaria a empresa?”) no contexto transacional (dois minutos depois de uma compra) e tratar o resultado como se fosse a saúde da relação. O que se mede aí é um híbrido: a relação vista sob o efeito da experiência de agora. Útil? Sim, como série temporal. Comparável com o NPS relacional da pesquisa anual? Não: são filmes de câmeras diferentes. Pesquisa preditiva: a previsão do tempo A pergunta implícita: “O que este cliente vai fazer, antes que ele faça?” A fronteira mais recente. Não é um terceiro questionário: é o uso combinado dos dados de pesquisa com dados de comportamento (frequência de visita, ticket, recência, reclamações) para antecipar: risco de abandono, propensão a recomprar, probabilidade de reagir mal a uma mudança. Exemplos práticos: Os cuidados obrigatórios: tudo o que a série ensinou sobre estatística e vieses se aplica em dose dupla. Correlação não é causa, modelos herdam os vieses dos dados que os alimentam (artigo IA na análise de dados), e previsão sobre indivíduos exige base legal e transparência (artigo A ética de quem pergunta, LGPD: finalidade e não-surpresa). Previsão é hipótese com probabilidade, não veredito. A tabela de bolso dos tipos de pesquisa Transacional Relacional Preditiva Pergunta Como foi esta experiência? Como está a relação? O que vai acontecer? Gatilho O evento O calendário O modelo Quem responde Quem viveu o evento Amostra da base Ninguém (dados combinados) Métricas típicas CSAT, CES NPS, intenção Risco, propensão Alimenta Operação (inner loop) Estratégia (outer loop) Ação antecipada Risco típico Ver árvore, perder floresta Memória e auto-seleção Correlação travestida de causa Por que isso importa A maior parte dos programas de escuta nasce transacional, e é por aí que se começa. Mas a empresa madura (Voz do Cliente, estágio 3) precisa dos três tipos operando como sistema: a transacional detecta, a relacional contextualiza, a preditiva antecipa. Saber explicar essa arquitetura é o que separa instalar um totem de desenhar um programa de escuta. De volta à Horizonte Na Horizonte, a resposta da Mari virou aula na reunião de sexta: o 72 era a foto (o cliente na saída do balcão, o atendimento ainda fresco: a experiência transacional); o 45 era o filme (a relação inteira, lembrada semanas depois, com o preço, o app do concorrente e a farmácia da esquina na conta). Nenhum estava errado; eram instrumentos diferentes, e a diferença entre eles era, em si, informação: a loja encantava no balcão e desbotava na memória, sintoma clássico de relação sem vínculo. A rede reformou o uso: selo e advertência saíram do número solto e passaram para o par lido em conjunto, cada pesquisa com papel, dono e régua próprios. O franqueado guardou a síntese: “a foto elogia meu balcão; o filme está me pedindo um programa de fidelidade”. O resumo de uma frase (teste Feynman) “Transacional é a foto de cada visita, relacional é o filme da relação, preditiva é a previsão do tempo: quem mistura os três mede tudo e não entende nada.” Fontes e leituras recomendadas
Pesquisa em redes e franquias: gerir a experiência quando a marca é uma e as lojas são cem
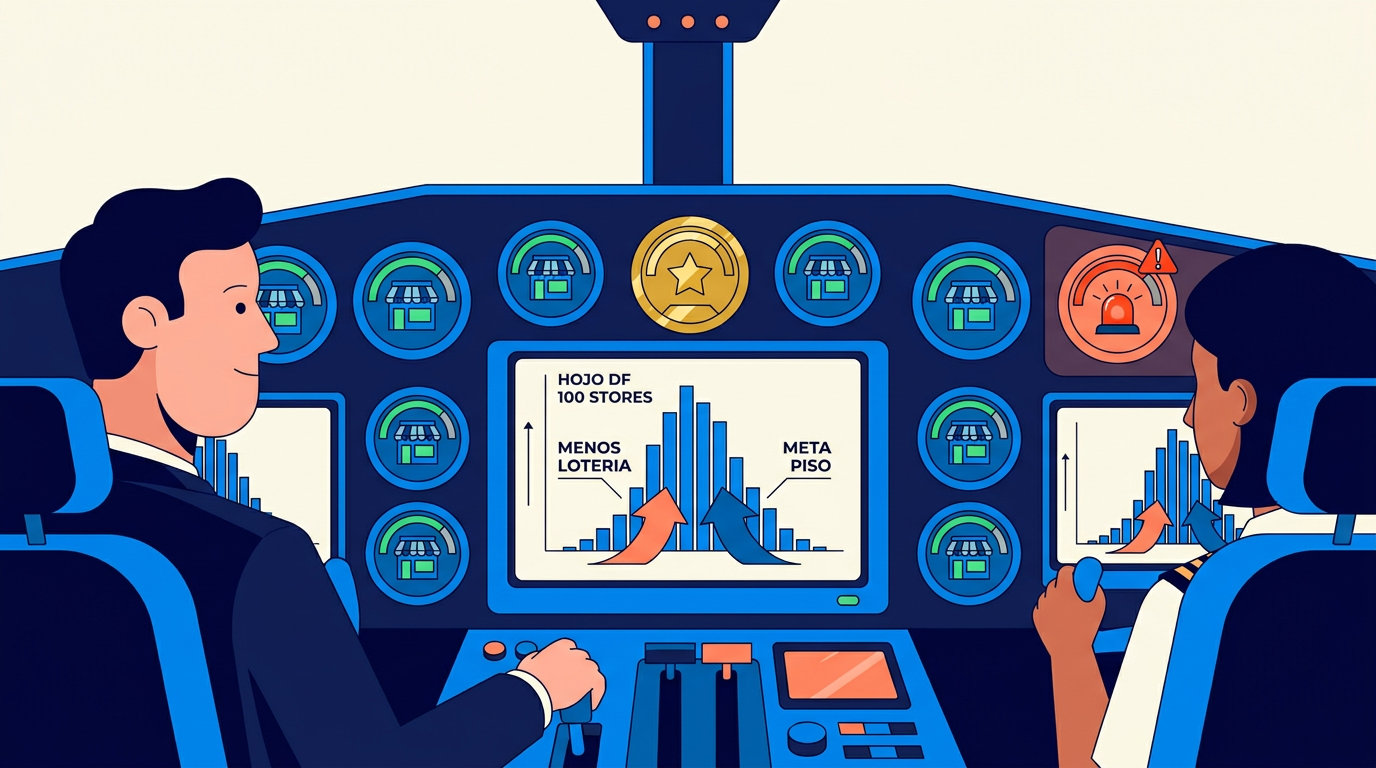
O cliente não visita “a rede”: visita uma loja. Mas julga a marca inteira pela pior visita que teve. Em redes e franquias, a pesquisa só funciona com uma régua comum. Nas Farmácias Horizonte Na visita à primeira leva de franquias das Farmácias Horizonte, rede que cresce por franqueados, Marina, da direção, notou algo estranho no totem de uma das lojas: a pergunta estava diferente. O franqueado tinha “melhorado” por conta própria: trocara a pergunta padrão por “Você saiu feliz da nossa farmácia?”, com uma escala de carinhas que ele mesmo escolhera. “Ficou mais simpática”, explicou, orgulhoso. “E a nota subiu!” Subiu: 4,7 contra 4,3 da rede. No relatório consolidado, a farmácia dele brilhava no topo, e duas outras, sabendo da mudança, já perguntavam se também podiam “personalizar”. Marina olhou o ranking que administrava toda semana e percebeu o que estava prestes a acontecer com ele: oitenta farmácias, cada uma com a sua régua, e um relatório central comparando… o quê, exatamente? O problema particular da multiunidade em redes e franquias Gerir uma loja é gerir uma operação. Gerir cem é outro ofício: a matriz não vê o balcão, o franqueado tem incentivos próprios, e a experiência “da marca” é, na prática, a distribuição das experiências de cem operações semiautônomas, com tudo que a série já disse sobre distribuições (artigos Média mente, Desvio padrão sem dor e O formato dos dados) valendo em escala organizacional. A pesquisa contínua e padronizada é, para a gestão multiunidade, o que a instrumentação é para um avião: o único jeito de “estar” em cem lugares ao mesmo tempo. Este artigo trata das regras específicas desse jogo, que é onde as redes e franquias vivem e onde os erros de leitura custam mais caro. Regra 1: o ativo é a comparabilidade; proteja-a com unhas e dentes A vantagem estrutural da rede sobre a loja isolada: cem operações medindo a mesma coisa do mesmo jeito formam um laboratório natural permanente. Cada loja é um experimento; a rede inteira é o grupo de comparação (o grupo de comparação que o artigo Regressão à média pedia). Esse ativo se destrói fácil: perguntas “adaptadas” por unidade, escalas mudadas por regional criativo, totem posicionado no fundo numa loja e na saída noutra, períodos de coleta diferentes. Cada “pequena flexibilização” quebra a régua comum (artigo Escala Likert: mudou a escala, quebrou a série; versão rede: mudou numa loja, quebrou o benchmark). A disciplina: instrumento idêntico, posicionamento padronizado, mudanças versionadas e sincronizadas para a rede inteira, com data anotada (artigo Sazonalidade e séries temporais). Flexibilidade fica no conteúdo local acionável (perguntas extras específicas), nunca no núcleo comparável. Regra 2: a distribuição da rede vale mais que a média da rede “NPS da rede: 62” é a métrica menos interessante do painel multiunidade (média de coisas diferentes; artigos Média mente e Comparações justas). As leituras que geram gestão: Meta de rede madura, portanto: subir o piso e apertar o espalhamento, mais do que empurrar a média. Regra 3: o franqueado é cliente da pesquisa, não réu dela Na franquia, o dado de experiência carrega tensão contratual: pode embasar cobrança, multa, até descredenciamento. Isso cria o risco de o programa ser percebido como auditoria disfarçada. E aí o franqueado, racionalmente, joga contra: desliga totem, caça nota (artigo Metas de satisfação bem desenhadas), contesta metodologia. O desenho que funciona inverte a percepção, e cada peça já tem artigo na série: Regra 4: separe o que é da loja, o que é do modelo e o que é da marca O erro de atribuição clássico da rede: cobrar da loja o que é estrutural. A nota baixa de fila pode ser gestão local (escala mal feita), modelo (dimensionamento de caixas do projeto-padrão insuficiente para o fluxo real) ou marca (promessa de propaganda que a operação não tem como cumprir: gap 4 do SERVQUAL, artigo As cinco dimensões da qualidade de serviço). O teste diagnóstico usa a própria rede: problema presente em 70% das lojas não é problema de loja; é do modelo ou da promessa, e pertence à matriz (ciclo externo, artigo O ciclo fechado, na alçada certa). O Pareto por categoria × % de lojas afetadas (artigo Priorização de melhorias) faz essa separação numa tela. De volta à Horizonte Na Horizonte, a conversa com o franqueado não foi sobre culpa: foi sobre o ativo que ele estava, sem saber, derretendo. A comparabilidade é o que faz o dado da rede valer alguma coisa para ele: sem régua idêntica, o 4,7 não se compara ao 4,3, o benchmark interno morre, e o franqueado perde exatamente o serviço pelo qual paga royalties. A régua voltou ao padrão em toda a rede, com a válvula certa: perguntas locais adicionais podem; mexer nas âncoras, não. E o relatório do franqueado mudou de cara: em vez de só devolver ranking, passou a devolver análise: onde a loja dele destoa da liga, o que os melhores comparáveis fazem diferente. Franqueado tratado como cliente do dado cuida da régua; tratado como réu, mexe nela. O resumo de uma frase (teste Feynman) “Em rede, a pesquisa é o cockpit de cem lojas ao mesmo tempo: régua idêntica para todos, leitura pela distribuição e não pela média, franqueado como cliente do dado; e problema de todo mundo é problema do modelo, não das lojas.” Fontes e leituras recomendadas
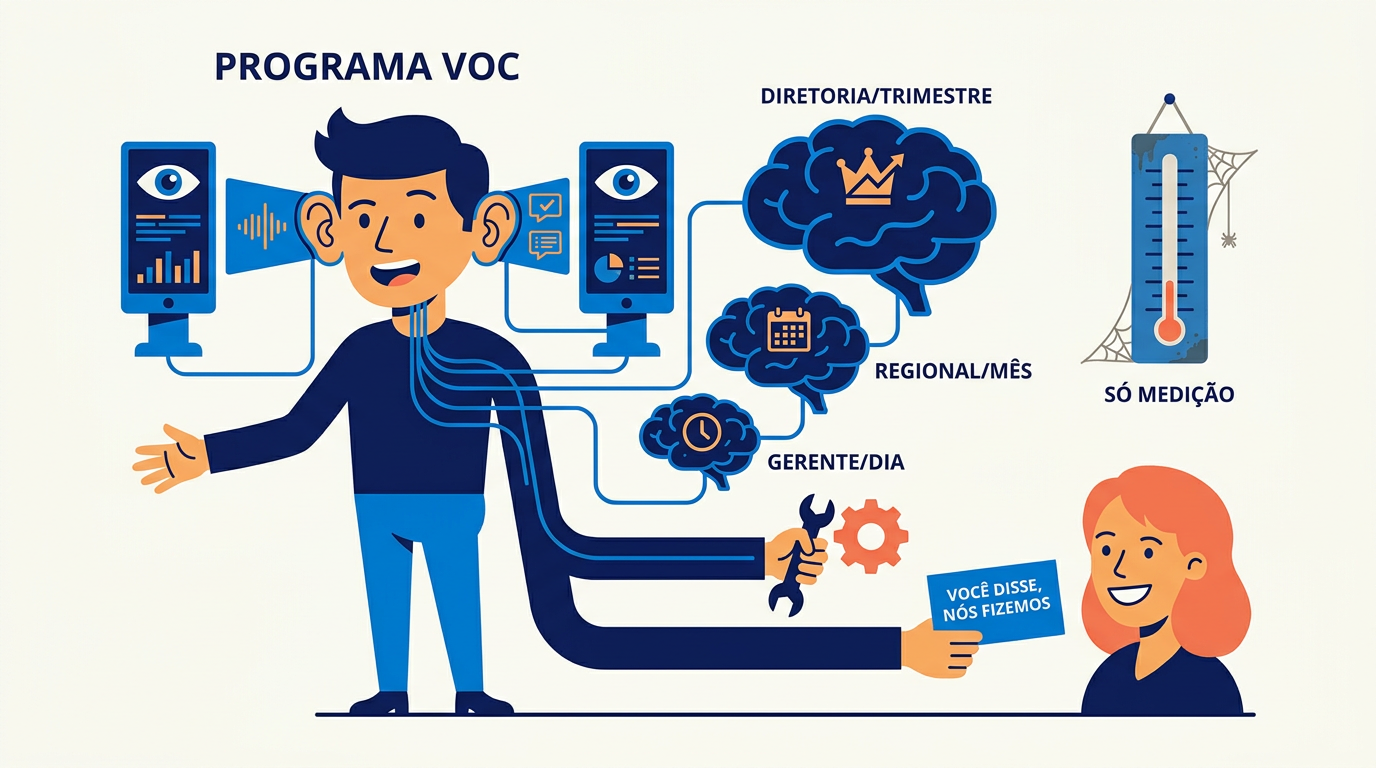
Voz do Cliente: como transformar pesquisa solta em programa de gestão
Um totem instalado não é um programa: é um começo. Programa é quando a empresa inteira sabe o que fazer com a resposta. É essa a diferença entre medir e ter um programa de Voz do Cliente. Nas Farmácias Horizonte O comentário chegou pelo totem de uma das lojas das Farmácias Horizonte, rede de farmácias que cresce por franquias, e doeu mais que uma nota baixa: “Terceira pesquisa da Horizonte que respondo esta semana. Mandaram WhatsApp depois da entrega, o programa de fidelidade mandou e-mail e agora este totem. Vocês pelo menos conversam entre si?”. Marina, que toca a expansão da rede ao lado do pai, o fundador, foi puxar o fio e encontrou o novelo: o marketing disparava NPS por e-mail para a base da fidelidade, o delivery mandava CSAT pelo WhatsApp a cada entrega, e as lojas tinham o totem no balcão. Três áreas, três instrumentos, nenhum sabendo dos outros, e no centro da roda o mesmo cliente: o do remédio de uso contínuo, que compra todo mês e é justamente quem a rede menos pode perder, respondendo tudo até cansar. Mari, consultora da Solvis que atende a rede, deu nome ao diagnóstico quando Marina lhe mostrou o mapa improvisado: a Horizonte não tinha um programa de escuta. Tinha três monólogos simultâneos, disputando o mesmo ouvido. A diferença entre medir e gerir Muitas empresas “fazem pesquisa” do mesmo jeito que muita gente “tem balança em casa”: o instrumento existe, o número aparece, e nada na rotina muda por causa dele. Um programa de Voz do Cliente (VoC, na sigla consagrada do mercado) é outra coisa: é o sistema de gestão que conecta a escuta contínua às decisões da empresa, com donos, ritos, metas e consequências. A pesquisa é o sensor; o programa é o organismo que reage ao sensor. Este artigo, o primeiro do bloco sobre gestão, desenha a anatomia completa desse organismo. Os próximos artigos do bloco detalham cada órgão. Os cinco componentes de um programa de Voz do Cliente que funciona 1. Escuta desenhada (não acumulada).Programas fracos nascem por acúmulo: cada área cria seu questionário, o cliente é metralhado, ninguém enxerga o todo. Programas fortes desenham a escuta de ponta a ponta: quais momentos da experiência do cliente merecem medição (a compra, o pós-atendimento, a relação; artigo CSAT, CES e NPS), qual instrumento em cada um (CSAT transacional no ponto, CES nos fluxos de resolução, NPS periódico), e quanto silêncio o cliente merece entre um contato e outro. O inventário de tudo que se pergunta, com dono e finalidade, é o primeiro entregável de qualquer programa, e frequentemente um exercício constrangedor. 2. Governança: cada número com dono.A pergunta que mata programas: “quem age quando este número se move?” Enquanto ela não tiver um nome próprio como resposta, o dashboard é só uma tela que as pessoas olham de passagem. A estrutura mínima tem três alçadas: o operador local (gerente da loja: age no caso individual, hoje; o ciclo interno do artigo O ciclo fechado), o dono do processo (regional/matriz: age no padrão, no mês; o ciclo externo), e o patrocinador executivo (diretoria: age na estrutura, no trimestre; orçamento, prioridade, gente). Nas empresas em que só o “time de CX” é dono da experiência, ninguém é. 3. Ritmo: a cadência de reuniões que consome os dados.Dado sem rito é arquivo. O programa define onde, quando e por quem cada número é olhado: do semáforo diário do gerente à revisão trimestral da diretoria. É assunto tão central que tem artigo próprio (artigo Rituais de gestão). O quarto componente é o fechamento de ciclo, e ele acontece nas duas pontas. Para o cliente, significa contato, resolução e o “você disse, nós fizemos” (artigo O ciclo fechado). Para dentro de casa, significa o aprendizado registrado virando mudança de processo, treinamento ou produto (artigo A empresa que aprende). Programas que só coletam e reportam são caros e frustrantes, e Reichheld e Markey são taxativos ao dizer que o valor do Net Promoter está no sistema de ação, não no placar. Fecha a lista a prova de valor, porque o programa também presta contas. Um programa de VoC consome dinheiro e atenção, e deve demonstrar retorno com a mesma régua que exige dos outros: detratores recuperados, problemas estruturais eliminados, decisões de investimento informadas (artigo O caso financeiro da satisfação monta esse caso). Métrica de vaidade do próprio programa (“coletamos 1 milhão de respostas!”) não vale (artigo Métricas de vaidade). Os três estágios de maturidade (para diagnosticar a própria empresa) Estágio 1 — Medição: coleta funciona, relatório circula, reação é episódica e depende de heroísmo individual. A maioria das empresas está aqui. Sintoma típico: o NPS é assunto da reunião sobre NPS, não das reuniões de negócio. Estágio 2 — Operação: alertas com dono, ciclo interno rodando, padrões revisados com cadência. A pesquisa entrou na rotina operacional. Sintoma de progresso: gerentes pedem os dados antes de a matriz cobrar. Estágio 3 — Estratégia: a voz do cliente entra nas decisões de investimento, produto e expansão; metas de experiência têm o mesmo status das financeiras; o programa demonstra ROI. Sintoma: o cliente é citado em reuniões onde ele “não deveria” estar (orçamento, obra, contratação). O diagnóstico honesto de estágio vale mais que qualquer benchmark de nota. O trabalho de verdade é mover a empresa do estágio 1 para o 3, e isso é muito mais do que coletar respostas. Os erros que matam programas (vistos de perto) De volta à Horizonte Na Horizonte, os três monólogos viraram um sistema nervoso com desenho: um mapa único de escuta por momento da jornada (balcão, entrega, relação com a rede), donos nomeados para cada sensor (o franqueado no balcão da própria loja, a matriz nos padrões de entrega e fidelidade, Marina como patrocinadora), cadência combinada pelo cadastro da fidelidade para o mesmo cliente não receber duas pesquisas da rede na mesma quinzena, e um rito mensal em que marketing, delivery e operação leem juntos o que o cliente disse, por onde quer que tenha dito. O
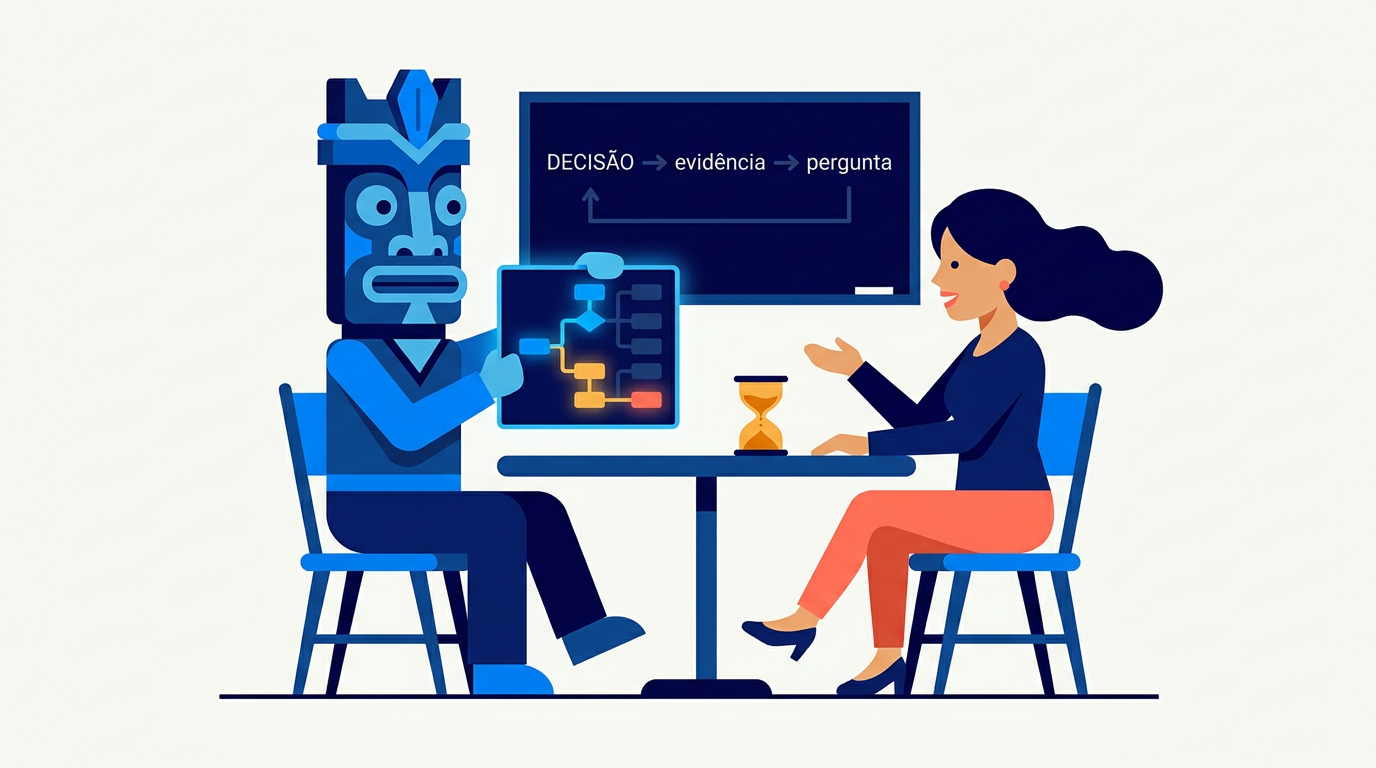
O questionário como conversa: design reverso, fluxo e o respeito pelo tempo do outro
Ninguém desenha uma conversa começando pelas frases. Começa-se pelo que se quer descobrir. Veja como desenhar o questionário como conversa. No Sabor Central O questionário novo dos refeitórios do Sabor Central, empresa de refeições coletivas, foi montado por comitê, e a planilha compartilhada contava a história: uma aba por área, cada uma empurrando “só mais uma perguntinha”. A nutrição queria aceitação prato a prato; o RH da fábrica contratante queria clima; o comercial queria NPS; a segurança de alimentos queria três itens próprios. O resultado final tinha 17 perguntas e boas intenções em todas elas. No piloto, o comensal votou com a bandeja na mão: desistência em massa na pergunta 6, e os que chegavam ao fim respondiam as últimas no piloto automático, tudo 4, tudo igual. Paula levou os números ao comitê e propôs inverter a lógica de construção: — A gente perguntou “o que cada área quer saber?”. A pergunta certa é outra: “que decisão cada área vai tomar com isso?”. Quem não tiver decisão, não tem pergunta. O artefato mais subestimado: o questionário como conversa O artigo Anatomia de uma boa pergunta ensinou a redigir uma boa pergunta; o artigo O cardápio de perguntas, a escolher o tipo certo. Este artigo trata do que fica entre elas e acima delas: o questionário como um todo (a ordem, o fluxo, as ramificações, o que é obrigatório, o tom). É o artefato mais subestimado da pesquisa: todo mundo revisa as perguntas, quase ninguém desenha a conversa. Porque é isso que um questionário é: uma conversa com roteiro, em que só um dos lados fala de improviso. E conversas boas seguem regras que todo mundo conhece intuitivamente: não repetir o que já foi dito, não perguntar o que não interessa, não prender o interlocutor pelo braço. Regra 1: comece pelo fim (design reverso) O erro de origem de 90% dos questionários ruins: começar listando perguntas (“seria bom saber se…”). O método profissional inverte: Repare no subproduto do passo 3: muita coisa não precisa virar pergunta. Horário, loja, dia da semana, histórico: o sistema sabe. Perguntar o que já se sabe é pagar duas vezes. Este é o teste de bancada do artigo Anatomia de uma boa pergunta (“o que faremos com essa resposta?”) promovido a método de projeto: em vez de filtro aplicado no final, vira o ponto de partida. Se uma pergunta não se conecta a nenhuma decisão da etapa 1, ela não entra. A lista de decisões vem primeiro; o questionário é a sombra dela. Regra 2: a conversa se adapta (lógica condicional) Numa conversa real, ninguém pergunta “o que deu errado?” a quem acabou de dizer que estava tudo ótimo. O questionário que faz isso (e a maioria faz) avisa ao respondente que ninguém está ouvindo. A ferramenta é a lógica condicional (skip logic, ramificação): a resposta anterior decide a próxima tela. Três efeitos, todos medidos na literatura de questionários web: o fluxo médio encurta (cada um responde só o seu caminho), a informação por resposta aumenta (as perguntas de diagnóstico chegam a quem tem diagnóstico a dar) e o respondente sente que a conversa faz sentido, o que sustenta a atenção até o fim. A disciplina necessária: ramificação se desenha em fluxograma antes de configurar, e cada caminho se percorre no piloto. Ramo esquecido é pergunta que ninguém nunca vê, e ninguém percebe que ninguém vê. Regra 3: o tempo que importa é o percebido Fadiga de resposta não é lenda: a pesquisa metodológica mostra que, conforme o questionário avança, crescem o abandono, as respostas em linha reta (straightlining, artigo Anatomia de uma boa pergunta) e as não-respostas em itens abertos. Galesic e Bosnjak demonstraram inclusive que a mesma pergunta rende respostas mais pobres quando aparece no final do que no início. Mas o gatilho da fadiga tem menos a ver com o relógio do que com a percepção de esforço. E percepção se gerencia: E a regra de ouro continua absoluta: no ponto de venda, fluxo completo em menos de 30 segundos para o caminho mais comum (artigo O cardápio de perguntas). A estrutura pode adiar a fadiga; não pode revogá-la. Regra 4: obrigatoriedade é exceção, não padrão O botão “resposta obrigatória” parece garantia de dados completos. Na prática, fabrica o contrário: quem não tem a resposta, inventa; quem não quer dar, abandona. Nos dois casos, o dado piora: no primeiro, silenciosamente, que é o pior jeito. Critério profissional: Taxa de pulo, aliás, é informação: se metade dos respondentes pula uma pergunta opcional, ela está cara demais ou irrelevante, candidata a corte na próxima iteração. Regra 5: fale a língua de quem responde A empresa é quem se adapta à língua do cliente, nunca o contrário. “Colaborador do PDV” é vocabulário de crachá; o cliente diz “o moço do caixa”. “Omnicanalidade” não existe fora de slide (artigo Anatomia de uma boa pergunta). A melhor fonte de vocabulário do cliente são os próprios comentários abertos (artigo Quali e quanti): é de lá que se aprende como ele chama as coisas. O tom também conversa: perguntas em linguagem natural (“Deu tudo certo hoje?”) rendem mais engajamento que formulários burocráticos (“Avalie o grau de conformidade do atendimento”), sem perder rigor, desde que a escala continue simétrica e rotulada (artigo Escala Likert). E uma pergunta bem-feita pode ir além de coletar: pode abrir raciocínio. “O que quase fez você desistir da compra de hoje?” desbloqueia uma reflexão que “Avalie sua experiência” jamais alcança: o respondente conta uma coisa que nem ele tinha formulado ainda. Use com parcimônia (é pergunta cara, artigo O cardápio de perguntas), mas use: é onde moram as descobertas. De volta ao Sabor Central No Sabor Central, o critério da decisão desidratou o questionário sem briga: das 17 perguntas, seis sobreviveram ao teste “que decisão muda com esta resposta?”, cada uma com dono e destino anotados na própria planilha. O clima da fábrica saiu (o RH contratante admitiu que decidiria pela pesquisa interna dele, que já existia); a aceitação por prato ficou, amarrada à revisão
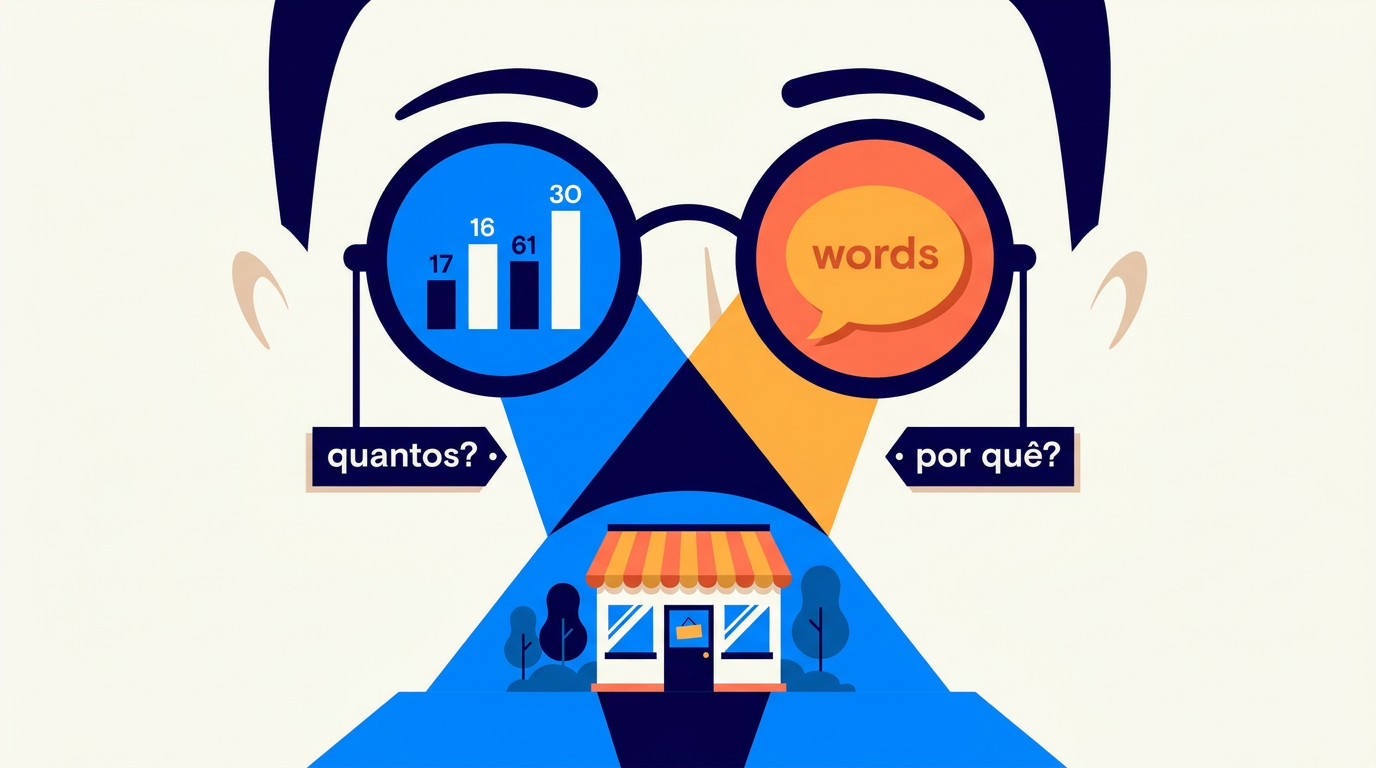
Quali e quanti: o que os comentários dizem que os números não dizem
O número conta quantos; o comentário conta por quê. Análise qualitativa e quantitativa juntas evitam dirigir com um olho fechado. No Supermercado Farol A nota da loja principal do Supermercado Farol, rede com cinco lojas, caiu 0,3 num mês. O número era claro, consistente e mudo: dizia que caiu, não dizia por quê. A reunião virou campeonato de palpite: o encarte fraco? o açougue? o calor? Cada palpite com um torcedor, nenhum com evidência. Dona Ivone, a fundadora, encerrou o campeonato com uma caixa de marca-textos. Ela e Caio, o gerente, imprimiram os 200 comentários do mês e leram um por um: verde para elogio, laranja para reclamação, uma palavra de categoria na margem. Na metade da pilha, o padrão já gritava: "padaria vazia à noite" e "só dois caixas abertos" apareciam em uma a cada quatro reclamações. Ninguém na sala tinha palpitado nem de longe naquilo. Análise qualitativa e quantitativa: dois modos de conhecer Toda pesquisa responde a duas famílias de pergunta: Quantitativa (quanti): quantos? quanto? com que frequência? Respostas em números, coletadas de muitos casos, comparáveis e agregáveis. É o território das notas, escalas e porcentagens. Qualitativa (quali): por quê? como? o que significa? Respostas em palavras, histórias e observações, coletadas em profundidade. No mundo do ponto de venda, sua forma mais comum é humilde: o campo de comentário livre do totem. O erro clássico do mercado é tratá-las como rivais: "dados duros" contra "opinião solta". A metodologia científica moderna as trata como fases complementares do mesmo ciclo: a quali gera hipóteses e explica mecanismos; a quanti testa hipóteses e mede magnitudes. Uma sem a outra fica cega de um jeito diferente. O que só o número faz Vale reafirmar a força da quanti antes de defender a quali: Por isso a espinha dorsal de qualquer programa contínuo de escuta é quantitativa. Mas ela tem três pontos cegos estruturais, e são exatamente os pontos fortes da quali. Ponto cego 1: o número não contém o porquê "A satisfação com o atendimento caiu de 4,3 para 3,8." Certo. E agora? Contratar mais gente? Treinar? Trocar a escala? O número aponta o incêndio, mas não diz o que está queimando. Um comentário diz: "a moça do caixa foi super atenciosa, mas fiquei 20 minutos na fila porque só havia um caixa aberto no horário do almoço." Uma frase, e o diagnóstico saltou de "atendimento ruim" (vago, injusto com a equipe) para "dimensionamento de caixas no pico" (específico, acionável, com dono). É a diferença entre saber que e saber por quê. Prática recomendada: nota sem comentário é semáforo sem mapa. A dupla fechada + aberta condicional existe para colher o porquê no momento em que ele está fresco. Ponto cego 2: o número só responde o que foi perguntado Um questionário quantitativo é um menu fechado: mede limpeza, espera, cordialidade… e é cego para tudo que não previu. Se o problema novo é "o QR code do cardápio não funciona", nenhuma das suas escalas vai captá-lo — ele não tem pergunta. O comentário aberto é o radar do inesperado: a única antena apontada para o desconhecido. Na literatura de desenvolvimento de produto isso tem tradição formal: o método "voz do cliente" (Voice of the Customer – VoC) de Griffin e Hauser mostrou que entrevistas e relatos em profundidade com clientes revelam necessidades que os instrumentos fechados não capturam, e que um número relativamente pequeno de conversas já revela a maioria das necessidades de um segmento. Prática recomendada: monitore os comentários procurando categorias que ainda não têm pergunta. Quando um tema novo se repete, ele se formou: merece virar pergunta fechada no fluxo (e aí a quanti assume a medição). Esse é o ciclo virtuoso: a quali descobre, a quanti dimensiona. Ponto cego 3: o número não carrega emoção nem linguagem "Insatisfeito: 23%" é informação. "Levei minha mãe de 80 anos para almoçar no aniversário dela e não havia uma única mesa acessível" é informação com temperatura, e temperatura move decisão (sem emoção, decisão trava). Além da emoção, o comentário entrega a linguagem do cliente: as palavras que ele usa para descrever o problema. Isso vale ouro duas vezes: para escrever perguntas melhores (é dos comentários que se aprende a língua do respondente) e para o storytelling com dados (uma citação verbatim bem escolhida vale um slide inteiro). Como analisar comentários sem virar refém deles A quali tem seus próprios rigores; sem eles, vira coleção de anedotas: 1. Codifique, não folheie. Análise séria de comentários é categorização sistemática: ler e etiquetar cada comentário em temas (as cinco dimensões da qualidade de serviço são um esquema inicial pronto), depois contar as etiquetas. A técnica formal se chama análise de conteúdo, e seu produto final é quantitativo: "31% dos comentários negativos citam espera". Quali e quanti se encontram aqui. 2. Cuidado com quem comenta. Comentário é opcional e custa esforço: quem comenta é amostra auto selecionada, tipicamente os extremos. Comentários dizem quais problemas existem, com riqueza; a proporção de cada problema se confirma na quanti. "Os comentários estão cheios de reclamação de fila" + "a nota de espera caiu" = evidência forte. Só a primeira metade = hipótese. 3. O verbatim ilustra, a contagem sustenta. No relatório, a citação individual dá rosto ao padrão, mas nunca o substitui. A história se ajusta aos dados, nunca o contrário. 4. Volume não se lê no braço, mas a curadoria continua humana. Ferramentas de análise de texto (hoje turbinadas por IA) classificam milhares de comentários em minutos. Úteis, desde que alguém audite as categorias por amostragem: classificador que ninguém confere é caixa-preta gerando confiança injustificada. De volta ao Farol No Farol, o número e o texto fecharam o caso juntos, cada um no seu ofício: a quanti dizia quantos (queda de 0,3, concentrada depois das 18h) e a quali dizia por quê (a última fornada da padaria saía às 17h, e a escala dos caixas não acompanhava o pico da saída do trabalho). Fornada extra às 19h, caixa reforçado no fim de dia, e a nota
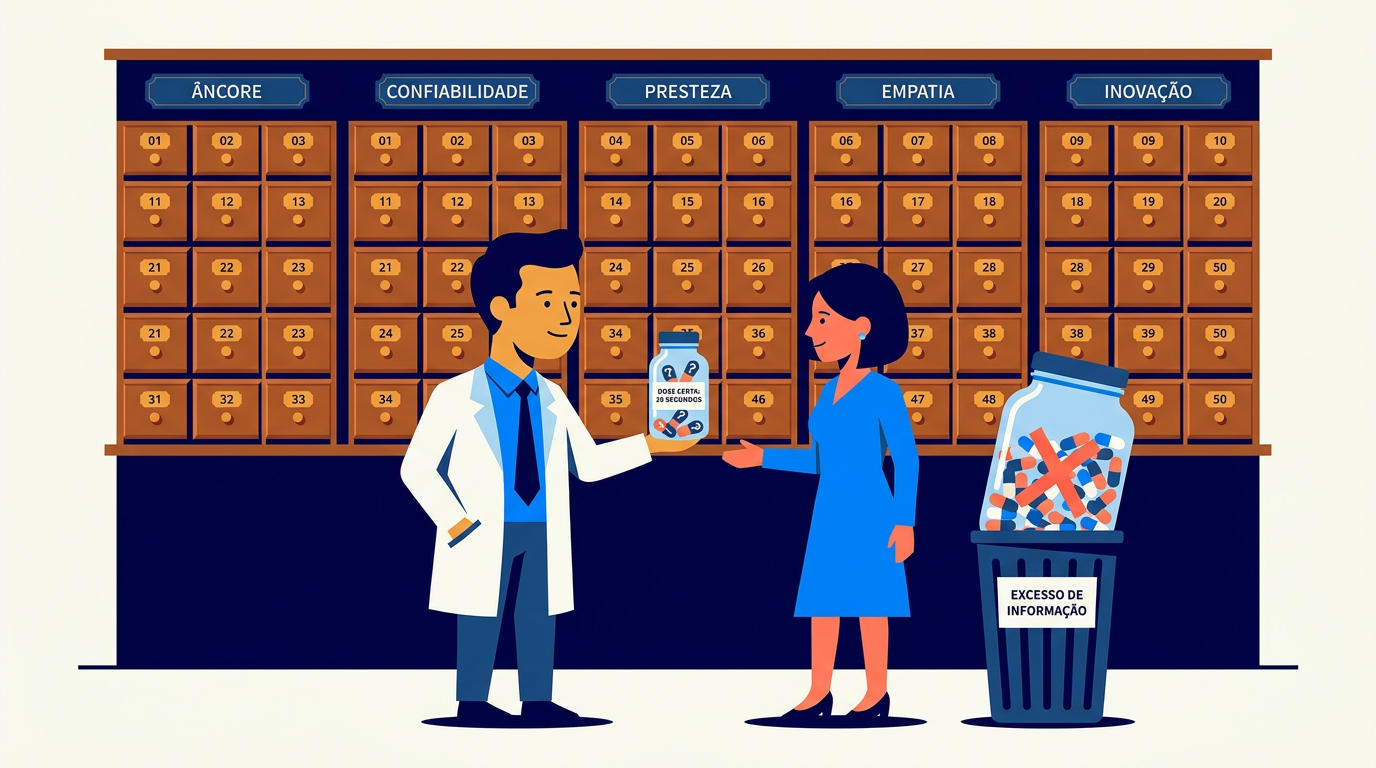
Banco de 50 perguntas de satisfação: material de referência
Um banco de perguntas de satisfação é um catálogo curado, não um questionário. Escolha poucas, escolha bem. Na Academia Ritmo Às 23h11, Fábio, dono da Academia Ritmo, rede de academias com três unidades, mandou para Mari, a consultora que atende a conta, o anexo de que estava visivelmente orgulhoso: "Pesquisa nova da unidade do bairro Alto. Fiz do zero, ficou enxuta!". Nove perguntas, criadas naquela noite, na inspiração. Mari leu na manhã seguinte com o café e o catálogo aberto do lado. Das nove, sete tropeçavam em defeitos já catalogados com nome e sobrenome: uma dupla ("estrutura e atendimento"), duas induzidas ("você concorda que…"), uma escala assimétrica, duas genéricas demais para gerar conserto, e uma pedindo CPF sem finalidade. As duas restantes eram boas… e já existiam, melhor redigidas e testadas por meses, no banco de perguntas. A resposta dela coube numa linha: "Você reinventou a roda, e ela saiu quadrada em sete lugares. Vem cá que eu te mostro a prateleira." Como usar este banco de perguntas de satisfação (leia antes de copiar) Este artigo é diferente dos demais da série: é um catálogo de consulta para apoiar quem está montando ou revisando um questionário de satisfação. Use as perguntas como referência, não como um manual imutável e inegociável. A ideia é cobrir a maioria dos casos, mas nenhuma listagem simples trata a totalidade deles. Três avisos inegociáveis: Formato sugerido entre colchetes: [E] escala de satisfação/concordância · [0-10] NPS · [S/N] binária · [M] múltipla escolha/caixas · [A] aberta. A. As três âncoras (métricas centrais) B. Confiabilidade: o prometido foi cumprido C. Presteza: agilidade e disposição D. Segurança: competência e confiança E. Empatia: atenção individual F. Tangíveis: ambiente e estrutura G. Produto (varejo e alimentação) H. Esforço: fluxos de resolução (CES) I. Contexto e segmentação (usar com parcimônia; atenção à LGPD) J. Intenção e relação K. Abertas: as que descobrem o que não sabemos perguntar Três montagens de exemplo (para roubar) Fluxo varejo, 20 segundos: 1 → 3 (condicional se nota baixa, em formato M com as dimensões B–F como opções) → 24 → 47 (opcional). Fluxo alimentação, 25 segundos: 1 → 32 → 9 → 3 (M condicional) → 49 (opcional). Fluxo pós-resolução de problema, 15 segundos: 34 → 36 → 47 (opcional). Repare no padrão: uma âncora, uma ou duas específicas da decisão do momento, um diagnóstico condicional, uma aberta opcional. É o funil de perguntas em ação: do geral ao específico, do barato ao caro. De volta à Ritmo Na Ritmo, a pesquisa do bairro Alto foi remontada em vinte minutos: não escrita, escolhida. Três âncoras do catálogo, duas perguntas da dimensão que a unidade precisava vigiar (limpeza do vestiário, a dor clássica de academia), uma aberta no fim. Cada pergunta com histórico, redação testada e, de brinde, comparabilidade com as outras unidades. Fábio, convertido, virou o maior fiscal da prateleira: "pergunta nova só quando o banco não tem, e aí ela entra no banco depois de testada". A energia das 23h dele continuou existindo; só mudou de alvo: em vez de redigir perguntas na inspiração, passou a caçar decisões que estavam sem pergunta para alimentá-las. O resumo de uma frase (teste Feynman) "Um banco de perguntas é como uma farmácia: o valor não está em tomar tudo, está em saber exatamente qual remédio o caso pede." Fontes e leituras recomendadas As perguntas foram formuladas segundo as diretrizes metodológicas já referenciadas na série: BRADBURN, Norman; SUDMAN, Seymour; WANSINK, Brian. Asking Questions: The Definitive Guide to Questionnaire Design. Jossey-Bass, 2004. PARASURAMAN, A.; ZEITHAML, Valarie A.; BERRY, Leonard L. "SERVQUAL". Journal of Retailing, v. 64, 1988. (Estrutura dimensional das seções B–F.) DIXON, Matthew; FREEMAN, Karen; TOMAN, Nicholas. "Stop Trying to Delight Your Customers". Harvard Business Review, jul.–ago. 2010. (Seção H.) REICHHELD, Frederick F. "The One Number You Need to Grow". Harvard Business Review, dez. 2003. (Pergunta 2.) ICC/ESOMAR. Código Internacional (voluntariedade e minimização de dados — seção I).
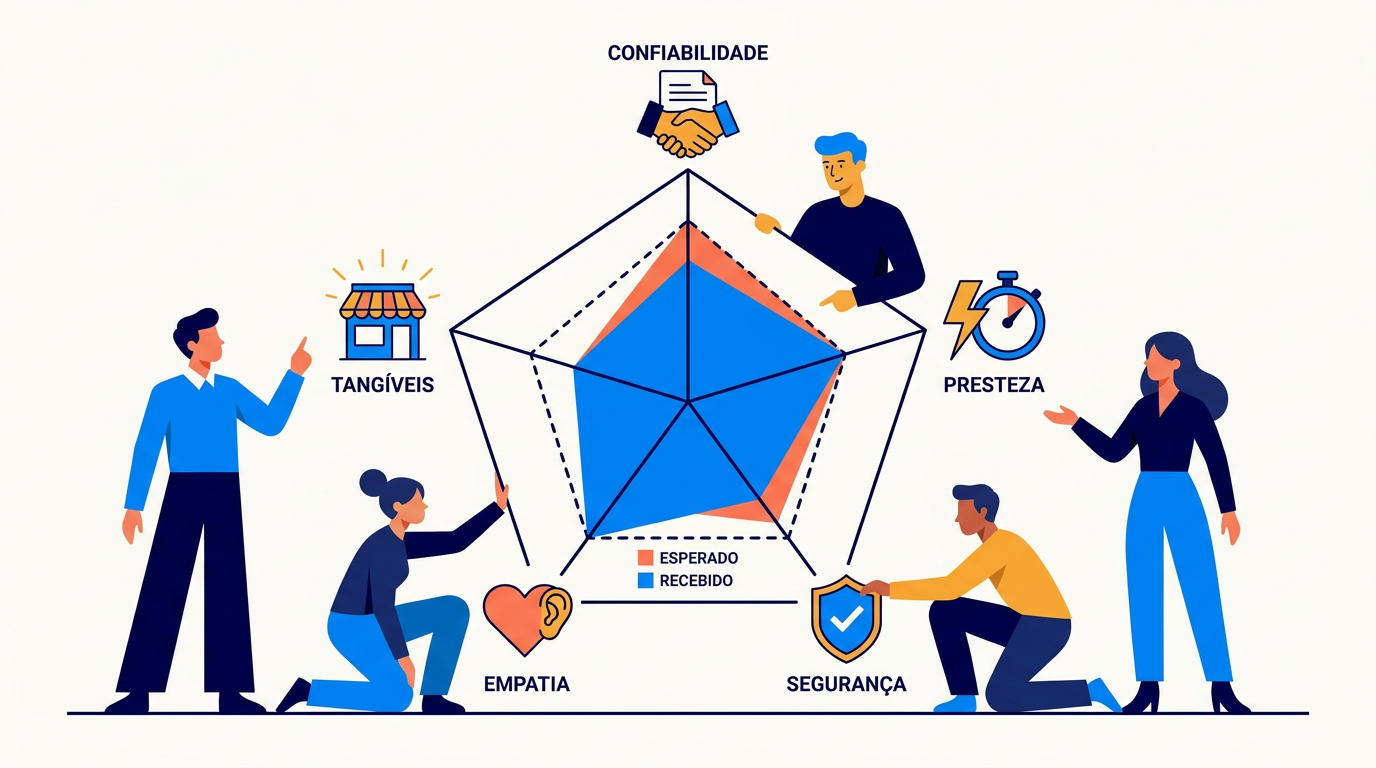
As cinco dimensões da qualidade de serviço: o mapa de onde a experiência nasce
"Atendimento bom" não existe: existem cinco dimensões da qualidade de serviço que os clientes julgam ao mesmo tempo. Na Casa Camélia O comentário chegou pelo totem da Casa Camélia, rede de restaurantes de Curitiba, seco como um SMS: "atendimento ruim". Nota 3. Marcos, o gerente, levou o caso para a reunião rápida da equipe, e a defesa foi imediata e unânime, cada um defendendo uma coisa diferente. "Fomos rápidos o dia inteiro", disse a líder de salão. "Fui atencioso com todas as mesas", disse o garçom veterano. "Ninguém errou pedido", disse o caixa. Todos tinham razão, e a régua de cada um media um atendimento diferente: velocidade, simpatia, precisão. "Atendimento", sozinho, era um guarda-chuva grande demais para caber num diagnóstico. Sobrou para Marcos a pergunta que ele levou para a regional: — Quando o cliente diz "atendimento ruim"… ele está falando de quê, exatamente? O problema de medir o invisível Medir a qualidade de um produto é relativamente fácil: o parafuso tem a rosca certa ou não tem. Mas e a qualidade de um serviço? Um almoço, uma consulta, uma compra no varejo não podem ser postos numa bancada de testes: o serviço é produzido e consumido no mesmo instante, e a "peça" avaliada é uma experiência. Nos anos 1980, três pesquisadores de marketing (A. Parasuraman, Valarie Zeithaml e Leonard Berry) atacaram esse problema com método científico de manual: entrevistaram consumidores e executivos de vários setores de serviço, perguntando o que, exatamente, as pessoas julgam quando julgam um serviço. Do material qualitativo emergiu um modelo; o modelo virou um instrumento de medição (o SERVQUAL, publicado em 1988 no Journal of Retailing); e o instrumento foi refinado até restarem cinco dimensões que se repetem em praticamente qualquer serviço, de banco a restaurante. Quase quarenta anos depois, é um dos frameworks mais citados de toda a literatura de marketing. E é extraordinariamente útil, porque transforma o "atendimento bom" genérico num mapa de cinco territórios mensuráveis. As cinco dimensões (com o teste do restaurante) Para memorizar, o acrônimo em inglês é RATER. Vamos a elas, testando cada uma no mesmo restaurante: 1. Confiabilidade (Reliability): cumprir o prometidoEntregar o que foi prometido, certo, na primeira vez. O prato que veio como descrito no cardápio, a reserva que estava valendo, a conta sem erro. Nas pesquisas dos autores, é consistentemente a dimensão mais importante para os clientes. Ninguém perdoa a promessa quebrada, e nenhuma simpatia compensa o pedido errado duas vezes. 2. Segurança (Assurance): competência que inspira confiançaO cliente sente que está em boas mãos: conhecimento, cortesia, credibilidade. O sommelier que sabe o que recomenda, o caixa que resolve sem chamar três supervisores. Em serviços de risco percebido (saúde, financeiro), esta dimensão explode de importância. Vale um parêntese: aqui, segurança está no sentido de garantia, de estar em boas mãos. 3. Tangíveis (Tangibles): o que os olhos avaliamInstalações, limpeza, equipamento, aparência da equipe. O banheiro do restaurante como "amostra grátis" da cozinha. É a dimensão mais visível, e por isso a proxy que o cliente usa para julgar o que não consegue ver. 4. Empatia (Empathy): atenção individualSer tratado como pessoa, não como senha. Lembrarem da sua mesa preferida, adaptarem o prato à alergia, o atendente que olha nos olhos. É a dimensão que transforma serviço correto em relação. 5. Presteza (Responsiveness): vontade de ajudar, sem demoraRapidez e disposição visível. O garçom que percebe o copo vazio, a fila que anda, o problema resolvido sem "vou ver o que posso fazer" eterno. Note a nuance: não é só velocidade; é a vontade percebida de servir. A ideia mais poderosa do modelo: qualidade é uma subtração O achado conceitual central de Parasuraman, Zeithaml e Berry não são as dimensões, e sim a fórmula por trás delas: Qualidade percebida = desempenho percebido − expectativa O cliente não avalia o serviço em absoluto; avalia contra o que esperava. O mesmo tempo de espera de 10 minutos é ótimo na churrascaria lotada de domingo e inaceitável no fast-food vazio de terça. Duas consequências práticas enormes: O modelo completo dos autores mapeia as "lacunas" (gaps) onde a qualidade se perde: entre o que o cliente espera e o que a gestão acha que ele espera (gap 1), entre o que a gestão entende e o que se especifica (gap 2), entre o que se especifica e o que se entrega (gap 3), e entre o que se entrega e o que se promete na comunicação (gap 4); a soma de todas aparece na diferença entre o esperado e o percebido pelo cliente (gap 5). Vale conhecer: muita nota baixa nasce menos na operação do que na distância entre o que o gestor acha que o cliente valoriza e o que o cliente valoriza de fato. É exatamente a distância que pesquisa bem feita fecha. Do modelo para o ponto de venda: como aplicar isso O SERVQUAL original é um questionário longo (22 itens, dois blocos), inviável no ponto de venda. E o modelo, apesar de citadíssimo, não passou ileso pelos quarenta anos seguintes. Duas críticas resistiram: medir qualidade por escore de diferença (desempenho menos expectativa) é estatisticamente frágil, porque a subtração herda o erro das duas medidas e sai menos confiável do que qualquer uma delas sozinha; e as cinco dimensões, tão limpas no artigo original, raramente se reproduzem intactas quando outros pesquisadores refazem a análise em outros setores, às vezes colapsando em três, às vezes em duas. Foi dessa crítica que nasceu o SERVPERF (Cronin e Taylor, 1992), que mede só desempenho, dispensa o bloco de expectativas e, na evidência dos autores, explica a qualidade percebida tão bem ou melhor. Nada disso derruba o modelo; situa o que ele é. Como mapa do que perguntar, o SERVQUAL é excelente e envelheceu bem; como régua de quanto medir, é um instrumento entre outros, com limites conhecidos (a diferença entre a régua apontar para o alvo certo e a régua ser firme é assunto de validade e confiabilidade de instrumentos de medição — um tema à parte). Na prática, o
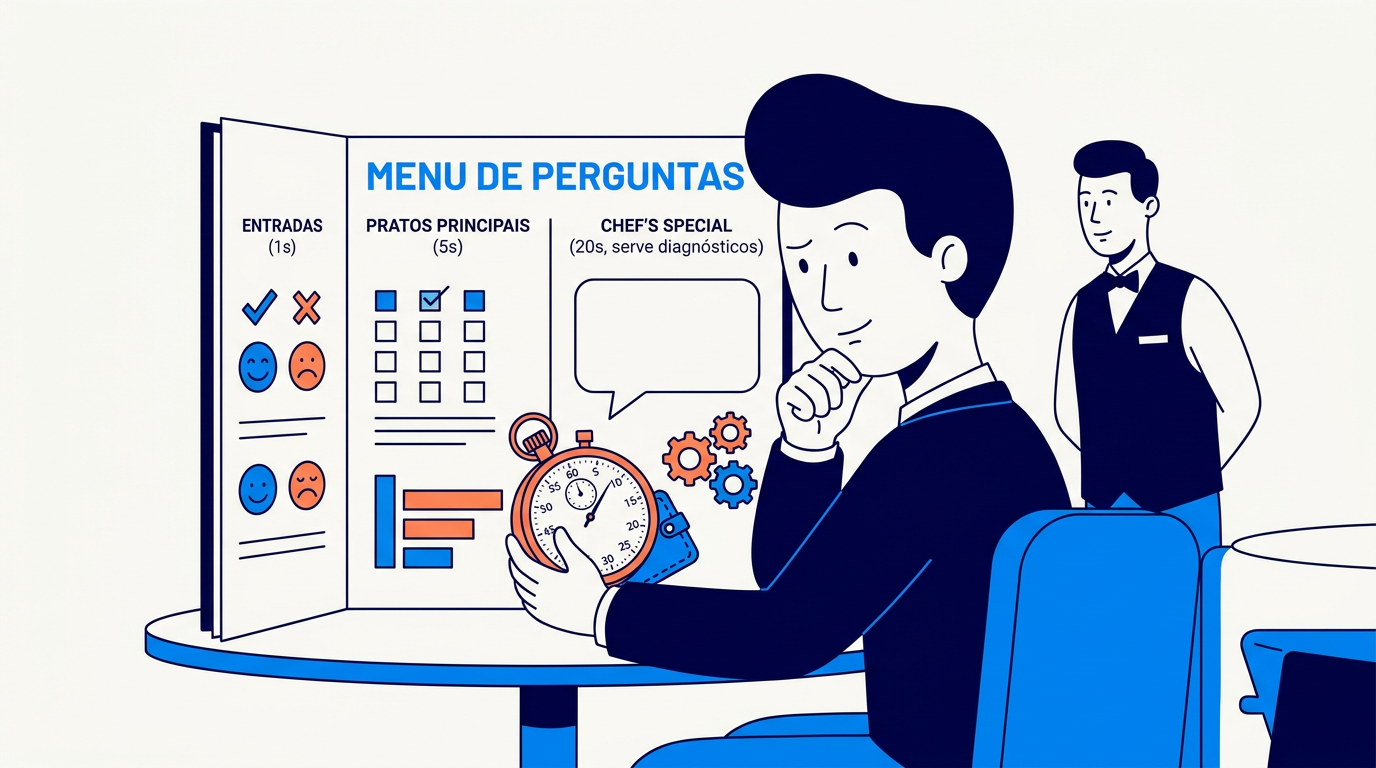
O cardápio de perguntas: os tipos que existem e quando usar cada um
Todo um dos tipos de pergunta de pesquisa cobra um preço em atenção: saiba o que você está comprando com ele. No Restaurante Farol O totem novo na saída do Restaurante Farol, rede com cinco lojas, estreou ambicioso: logo depois da nota, três perguntas abertas em sequência: "o que mais gostou?", "o que podemos melhorar?", "deixe sua sugestão". Caio, o gerente da loja principal, queria riqueza; o desenho prometia. O painel da primeira quinzena contou outra história: seis em cada dez clientes abandonavam na segunda pergunta aberta. Bolsa numa mão, filho na outra, fila atrás: as respostas que sobravam eram "tudo ótimo", "nada", "ok". Teclado de pressa, polegar cansado. Mari, consultora de pesquisa de satisfação, resumiu o diagnóstico diante do funil de abandono: — Cada pergunta custa segundos da atenção de quem responde, e o orçamento na saída de um mercado é de meio minuto, com sorte. Você montou um cardápio só de prato caro. Antes do cardápio, a conta Um bom questionário depende de saber redigir uma boa pergunta, mas depende tanto quanto de escolher o tipo certo, porque cada formato de pergunta é uma ferramenta com custo e benefício próprios. O custo se paga sempre do mesmo jeito: com a atenção do respondente. E no mundo do ponto de venda (cliente em pé, no caminho da saída, celular no bolso vibrando), o orçamento é de segundos. A regra que organiza tudo: quanto mais rica a resposta que o formato promete, mais atenção ele cobra. O ofício está em montar o cardápio que extrai o máximo de informação dentro do orçamento. Vale parar um parágrafo nesse custo, porque ele é fácil de subestimar. A atenção do respondente se parece com dinheiro em três pontos e difere em um quarto ponto. Como dinheiro, é finita: o que uma pergunta gasta falta para a seguinte. Como dinheiro, é cobrada na hora, use você a resposta ou não: a pergunta cujo relatório ninguém abre custa o mesmo que a pergunta que muda uma decisão, só que sem devolver nada. E, como dinheiro, tem dono: o orçamento é do cliente, que empresta por cortesia, sem dever nada e sem prometer a próxima parcela. A diferença é que esse orçamento não se repõe sozinho; ele encolhe com o mau uso. Quem abandonou um questionário comprido hoje aprende a não começar o de amanhã. A literatura chama isso de fadiga de pesquisa; na prática, é queima de base: o questionário ganancioso não encarece só a coleta desta semana, encarece todas as próximas. É com essa conta na cabeça que se lê o cardápio a seguir, do mais barato ao mais caro. Tipos de pergunta de pesquisa econômicos (1 toque, 1 segundo) 1. Escolha binária (sim/não)"Você encontrou o que procurava?" A pergunta mais barata que existe, e subestimada. Perfeita para fatos objetivos e triagem: um "não" pode disparar uma pergunta seguinte ("o que faltou?"). Limite óbvio: zero nuance. 2. Escala visual (carinhas, estrelas, corações)A avaliação de 3 ou 5 pontos em linguagem universal: atravessa idioma, idade e escolaridade, por isso é a rainha do ponto de venda. Pelo mesmo preço da binária (um toque), compra um degrau de nuance. Toda a ciência da escala Likert se aplica: simetria, ordem consistente, um item por tela. 3. Avaliação numérica (0–10, 1–5)A base do NPS e do CSAT. Barata, mas com pegadinha cultural: sem rótulos, cada pessoa inventa sua régua (para muita gente, "7 está ótimo"; para o NPS, 7 é neutro). Rotule as âncoras no mínimo. 4. Escala Likert (concordância)"O ambiente estava limpo: concordo/discordo." Mede atitudes e percepções específicas com custo baixo. Os intermediários (alguns segundos, mais riqueza) 5. Múltipla escolha (uma resposta)"Como você conheceu a loja?" Rápida e tabulável, mas repare onde está o preço: não no toque, e sim na lista. O cliente paga uma leitura por opção antes de escolher, então cada alternativa a mais é um item a mais na conta. Dois cuidados: opções mutuamente exclusivas e completas (com "outro" como válvula), e atenção ao viés de ordem: em telas, as pessoas tendem a favorecer as primeiras opções da lista (efeito de primazia, documentado por Krosnick). Quando a ordem não tem lógica natural, rotacione. 6. Caixas de seleção (múltiplas respostas)"O que motivou sua nota? (marque todos)" É o formato ideal para a pergunta-diagnóstico logo após uma avaliação negativa. Mais rica que a escolha única, um pouco mais cara em atenção. Limite prático no totem: até 6 opções visíveis sem rolagem. 7. Ranking (ordenar preferências)"Ordene do mais ao menos importante: preço, atendimento, variedade…" Informação valiosa (força trade-off, coisa que escala não faz: na escala, tudo pode ser "muito importante"). Mas é dos formatos mais caros cognitivamente: ordenar 6 itens exige 15 comparações mentais. Em autoatendimento rápido, use raramente e com poucos itens; em pesquisas mais profundas de mercado, é onde formatos avançados (como MaxDiff) entram. 8. Matriz (grade de itens × escala)Várias afirmações avaliadas na mesma escala, em tabela. É o formato que mais engana na etiqueta: parece uma pergunta só, mas cobra por linha. Eficiente no papel e no desktop; no celular e no totem é armadilha: favorece straightlining (marcar tudo igual para acabar) e abandono. Prática recomendada: desmembrar a matriz em telas de um item. Mesmo conteúdo, custo por gole. Os premium (custam caro, pagam diferente) 9. Pergunta aberta (texto livre)"O que podemos melhorar?" O formato mais rico que existe: captura o que você não sabia perguntar, a categoria de problema que nenhuma múltipla escolha previu. E o mais caro: digitar exige tempo e disposição, então a taxa de resposta despenca e quem responde é um recorte enviesado (os mais motivados). Uso profissional: sempre opcional, sempre depois das fechadas, e uma só. A dupla de ouro do diagnóstico é fechada + aberta: a nota diz quanto, o comentário diz por quê. 10. Campos de dado (e-mail, telefone, idade)Tecnicamente perguntas, na prática um contrato: o cliente entrega identificação. Custo altíssimo em confiança: cada campo desses reduz respostas e aciona deveres legais (LGPD: minimização e finalidade). Só peça o que tem uso definido, sempre
