
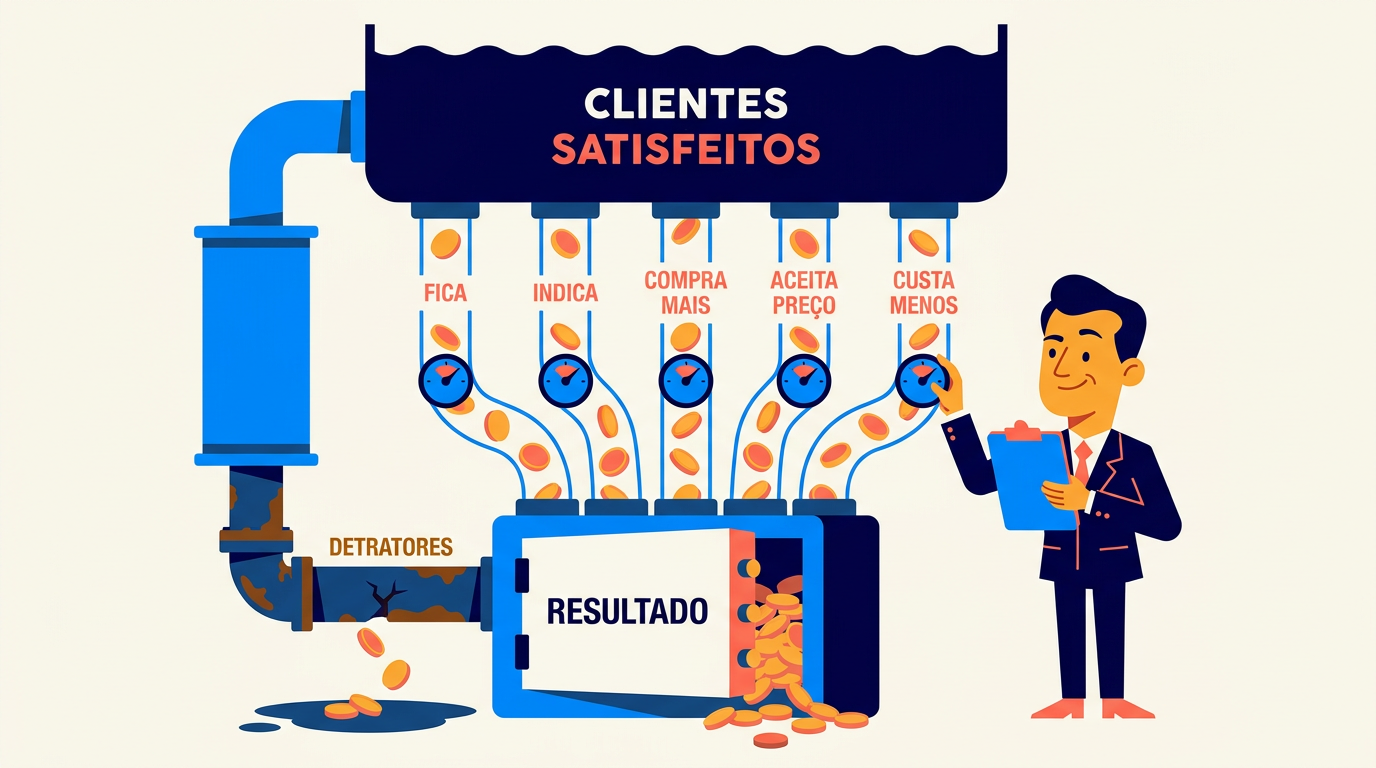
Experiência do cliente não é “coisa boa de se fazer”: é uma tese de investimento. E teses se defendem com números. Este é o caso financeiro da satisfação. Na Academia Ritmo Na reunião de orçamento da Academia Ritmo, rede de academias com três unidades, o contador chegou com a planilha anual e uma linha marcada em amarelo: “pesquisa de satisfação”. A proposta era educada e letal: cortar 60%. “É a linha mais fácil: não fecha unidade, não demite professor. E, com respeito, não consigo apontar o retorno.” Fábio, o dono, começou a responder com convicção e parou no meio da frase, com uma honestidade rara: a convicção era dele, mas a conta não existia. Em anos de pesquisa, a academia nunca tinha montado o caminho do dinheiro: quanto vale o aluno que fica mais um ano, o que traz o amigo, o que migra para o plano anual, o que custa menos atender. — Me dá noventa dias — disse ele. — Se a conta não fechar, o corte é seu. Se fechar, a linha amarela vira investimento no seu relatório. A pergunta do CFO: onde está o caso financeiro? Toda iniciativa de experiência do cliente eventualmente encontra a pergunta que a define: “e isso dá quanto de retorno?” Times de CX que respondem com adjetivos (“fideliza!”, “encanta!”) perdem o orçamento para quem responde com contas. A boa notícia: as contas existem, a evidência acumulada é farta, e o raciocínio cabe neste artigo. A má notícia (que é boa notícia para quem faz direito): o elo satisfação → dinheiro depende de mecanismos específicos e nada automáticos. Conhecer esses mecanismos é o que separa o caso financeiro sério do slide de motivação. A evidência de fundo: satisfação prevê resultado O elo agregado está bem documentado. O ACSI (The American Customer Satisfaction Index) permitiu testar a relação em escala: estudos liderados por Claes Fornell e colegas mostraram que empresas com satisfação consistentemente alta entregam retornos financeiros e de mercado superiores, e carteiras montadas com as líderes de satisfação bateram o mercado em horizontes longos (Fornell et al., Journal of Marketing, 2006; Anderson, Fornell e Mazvancheryl, 2004, documentaram a associação entre satisfação e valor ao acionista). Cautela metodológica de praxe (veja Diferença real ou ruído?): correlação em painel não é cheque em branco causal: empresas bem geridas tendem a ter clientes satisfeitos e bons resultados. Mas os mecanismos que ligam uma coisa à outra são observáveis, testáveis dentro de casa, e é neles que a gestão trabalha. Os cinco mecanismos (onde a satisfação vira dinheiro) 1. Retenção: o cliente que não foi embora.O mecanismo mais estudado. Reichheld e Sasser publicaram na HBR, em 1990, a análise clássica: pequenas melhorias na retenção têm efeitos desproporcionais no lucro, porque cliente retido dilui custo de aquisição, tende a comprar mais com o tempo e custa menos para servir. A conta local: qual o valor médio de um cliente/ano × quantos detratores viram ex-clientes × quantos a recuperação salva (artigo O ciclo fechado: o ciclo interno tem ROI direto por aqui). 2. Boca a boca: o marketing que a operação fabrica.Promotores indicam; detratores desindicam, com alcance assimétrico (a reclamação viaja mais). O custo de aquisição evitado por indicação é mensurável: pergunte “como nos conheceu?” (pergunta 41 do banco, artigo Banco de 50 perguntas de satisfação) e acompanhe a fração “indicação” ao longo do tempo contra a evolução do NPS. 3. Carteira: o cliente satisfeito compra mais.Frequência, tíquete, categorias adicionais. O teste interno é o cruzamento (com os cuidados que toda correlação exige): clientes promotores gastam mais depois de virarem promotores? A ordem temporal ajuda a separar causa de seleção. O quarto mecanismo é o preço, e ele funciona porque a satisfação compra tolerância. Clientes satisfeitos aceitam reajustes com menos evasão, ou seja, a elasticidade-preço cai com a lealdade. Em tempos de inflação de custos, isso vira o colchão que amortece o repasse. O quinto costuma ser esquecido: a operação que erra menos gasta menos. Insatisfação custa caro para dentro, em retrabalho, trocas, compensações, tempo de gestão apagando incêndio e rotatividade de equipe exausta (artigo O elo colaborador-cliente). Reduzir a causa-raiz dos detratores (ciclo externo, artigo O ciclo fechado) é projeto de redução de custo tanto quanto de receita. Montando o caso na prática: a árvore do ROI O caso financeiro de um programa (ou de uma melhoria específica) se monta em quatro passos, todos com ferramentas já apresentadas na série: E o teste contínuo do programa: decisões que mudaram por causa da escuta, com valor estimado. O portfólio de “casos fechados” vale mais que qualquer correlação de slide. As duas armadilhas do caso financeiro A promessa linear. “Cada ponto de NPS vale R$ X” é retórica perigosa: a relação não é linear (sair de 20 para 30 ≠ sair de 70 para 80), varia por setor e por mecanismo dominante, e vira meta goodhartizável na hora (artigos NPS sem mistério e Métricas de vaidade). Prefira sempre a versão por mecanismo: “reduzir detratores de fila em 30% vale ~R$ X em retenção”. O elo invertido no tempo. Resultado financeiro também melhora satisfação (empresa lucrativa investe mais em loja, gente e estoque), a flecha de mão dupla da causalidade. Por isso o caso sério se constrói com experimentos e casos fechados (mudança → movimento medido → resultado), não só com correlações de painel. De volta à Ritmo Na Ritmo, os noventa dias renderam a árvore que faltava: retenção (alunos em risco recuperados pelo ciclo fechado, multiplicados pela mensalidade anual), indicação (matrículas que chegavam com “vim porque me falaram”), carteira (migrações para o plano anual entre os satisfeitos), preço (o reajuste testado que não gerou êxodo) e custo (menos cancelamento, menos negociação de última hora na recepção). Premissas conservadoras, tudo auditável pelo contador, que ajudou a montar. A conta fechou com folga, e a linha amarela mudou de nome no orçamento seguinte, assinada por ele: de “pesquisa (despesa)” para “sistema de escuta (retenção de receita)”. Fábio guardou a lição: “o financeiro não compra fé; compra fluxo. E fluxo se
O formato dos dados: nem tudo é um sino
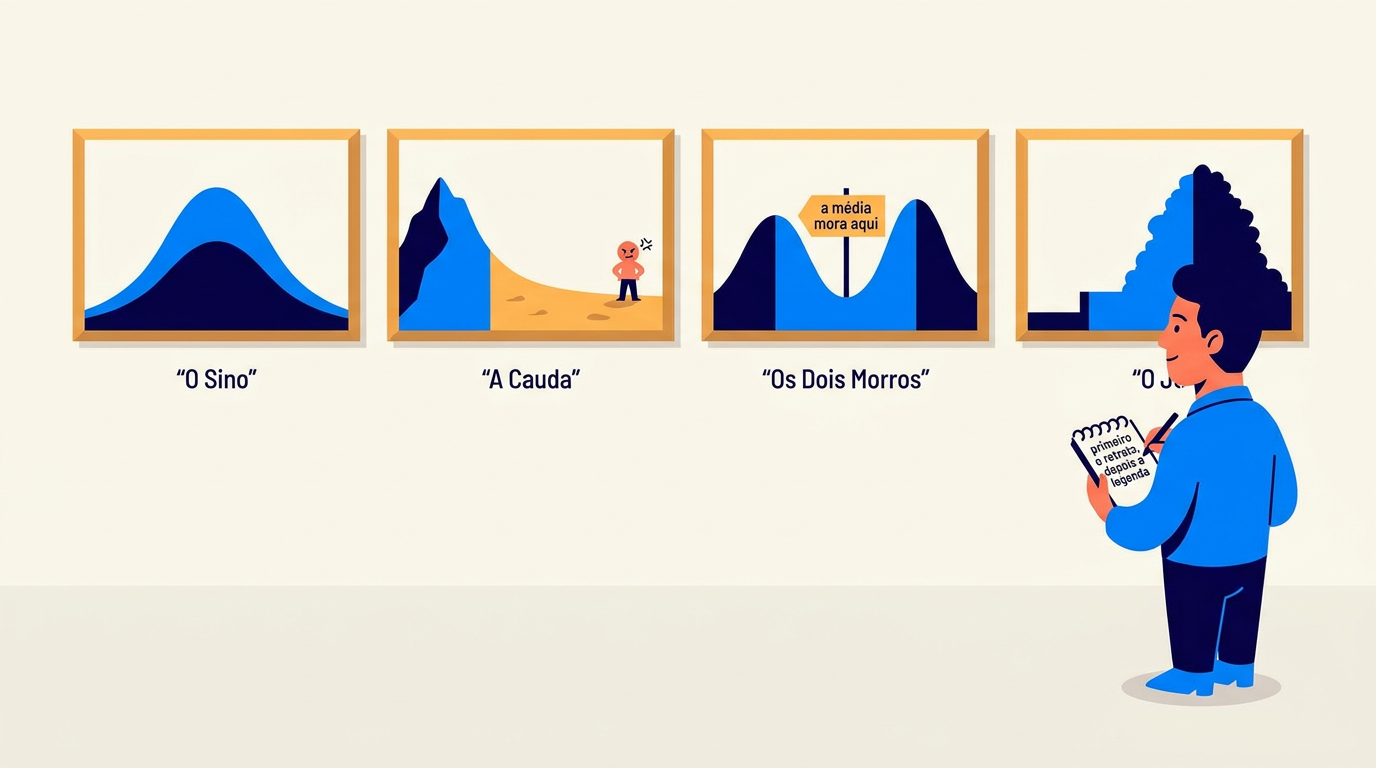
Antes de calcular qualquer coisa, pergunte que forma os dados têm: o resumo certo depende do desenho, e é o histograma de dados que o revela. No Hotel Cambará A média do mês do Hotel Cambará veio redonda: 4,6. Slide pronto, mês dado como bom. Mari Ferreira, consultora da Solvis, pediu uma coisa antes de arquivarem: o desenho. Não a média: o histograma, as notas empilhadas por valor. O desenho contou outra história. A pilha encostava no teto do 5, escorria pelo 4, e lá embaixo, quase discreta, uma cauda de notas 1 e 2: 6% das estadias, concentradas, quando abriram os cortes, nos check-ins depois das 22h e nos quartos do anexo antigo. A média 4,6 engolia aquela cauda sem soluçar: matematicamente correta, humanamente cega para os oitenta hóspedes do mês que tinham dormido mal. E hóspede que dorme mal escreve avaliação pública. — O seu mês não foi “4,6” — disse Mari. — Foi ótimo para muitos e péssimo para alguns. São duas gestões diferentes. O histograma de dados: o retrato antes da legenda Um histograma (a contagem de quantos casos caem em cada faixa) é o retrato de uma métrica. Média, mediana e desvio padrão são legendas desse retrato. E legenda sem retrato engana: o quarteto de Anscombe (Média mente) provou que resumos idênticos podem descrever desenhos opostos. Este artigo é um álbum dos quatro retratos que mais aparecem na análise de dados de satisfação, e do que cada um exige de quem o lê. Retrato 1: o sino (distribuição normal) O formato célebre: simétrico, amontoado no centro, raro nas pontas. Aparece quando o valor resulta de muitos fatores pequenos e independentes se somando: alturas de pessoas, erros de medição, médias de amostras grandes. É o lar da regra 68/95 (Desvio padrão sem dor) e o pressuposto silencioso de muitas ferramentas estatísticas. O erro cultural é achar que ele é o padrão do mundo. Não é. No dia a dia dos negócios, o sino é minoria e assumi-lo onde não existe produz as leituras erradas dos próximos três retratos. Retrato 2: a cauda longa (assimetria) Tempos de espera, tíquete de compra, tempo de resolução de chamado: quase todos os valores são modestos, mas uma minoria se estica numa cauda longa para a direita. Não há tempo de espera negativo, mas há o dia em que o sistema caiu e a fila levou 50 minutos. Consequências práticas: Média > mediana, em geral. A cauda puxa a média para cima do caso típico (o bilionário no bar, do artigo Média mente). “Tempo médio de espera: 9 minutos” pode conviver com “metade dos clientes espera menos de 5”. A ferramenta certa são os percentis. O valor abaixo do qual fica X% dos casos: a mediana é o p50; o p90 diz “90% dos clientes esperam menos que isto”. A engenharia de software gerencia latência de sistemas assim há décadas reportando p90/p95/p99 em vez de médias, precisamente porque a experiência ruim mora na cauda. Para operações de fila e atendimento, vale a mesma lente: a média mede o custo; o p90 mede a raiva. Metas honestas falam de percentil. “Atender em até 10 minutos em 90% dos casos” é uma promessa gerenciável e medível; “tempo médio de 8 minutos” pode ser cumprida enquanto um cliente por hora vive um desastre. Retrato 3: os dois morros (bimodal) Duas corcovas no histograma = duas populações misturadas vivendo experiências distintas: o almoço executivo e o jantar de sábado; o cliente novo e o habitual; o caixa humano e o autoatendimento. A média de uma bimodal cai no vale entre os morros, exatamente onde quase ninguém está. É o retrato mais traiçoeiro para resumos: qualquer número único descreve um cliente que não existe. A leitura certa não é resumir melhor; é separar as populações (segmentar; veja Média mente e Sazonalidade e séries temporais) e tratar cada morro como a história que ele é. O desvio padrão inflado sem explicação (Desvio padrão sem dor) é frequentemente o primeiro sintoma de bimodalidade escondida. Retrato 4: o “J” das notas de satisfação O retrato mais frequente nos painéis de satisfação: notas de satisfação não formam sino: amontoam-se no topo da escala (muitos 5, alguns 4), com um segundo grupinho menor no fundo (os 1 dos episódios ruins) e pouca coisa no meio. A literatura de marketing documenta isso há décadas: distribuições de satisfação são tipicamente assimétricas com concentração no extremo positivo (o levantamento clássico de Peterson e Wilson, 1992, já apontava o padrão e suas causas, do viés de quem escolhe responder e do desejo de ser gentil). Consequências para quem lê dashboards: A média fica cega no teto. Se quase todos marcam 4 ou 5, a média comprime tudo entre 4,2 e 4,6: parece estabilidade, mas o efeito teto está escondendo o movimento. Onde a ação acontece é nas pontas: acompanhe as proporções (% de notas máximas e % de notas baixas) em vez da média espremida. (O NPS, com seus promotores e detratores, é precisamente essa leitura institucionalizada; veja NPS sem mistério.) O meio vazio não é falta de opinião. Nota 3 em escala com formato J é frequentemente um “quase-detrator” educado. Trate a faixa média como zona de investigação, não como “neutros satisfeitos”. Pequenas quedas na média podem ser grandes notícias. Numa distribuição empilhada no teto, a média só cai quando gente migra para o fundo: uma queda de 0,2 pode significar que os casos ruins dobraram. Abra sempre a distribuição (Média mente) antes de julgar a magnitude. O hábito que resume o artigo Diante de qualquer métrica nova, peça o histograma antes de qualquer resumo. Trinta segundos de olhar respondem: é sino (média e desvio funcionam)? Cauda longa (mediana e p90)? Dois morros (segmente antes de tudo)? Empilhado no teto (proporções nas pontas)? Só então escolha a legenda. Resumo estatístico é como embalagem: precisa caber no formato do conteúdo, e é o conteúdo que manda. De volta ao Cambará No Cambará, o fechamento mensal ganhou um morador novo ao lado da média: o
CSAT, CES e NPS: qual métrica usar quando
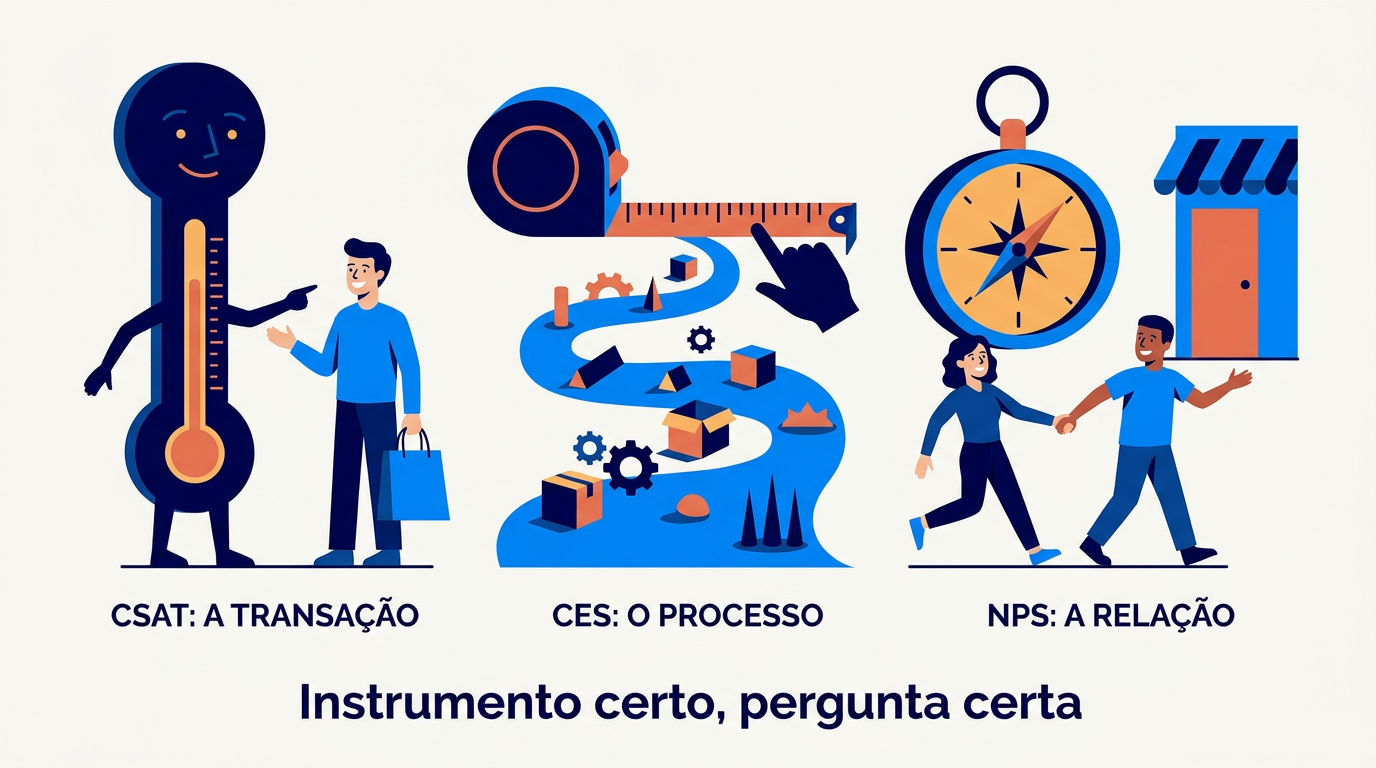
CSAT CES NPS: três siglas, três perguntas diferentes, e a mania de pedir que uma só faça o trabalho das três. Na Vetor Sistemas A reunião de métricas da Vetor Sistemas, empresa de software de gestão B2B, tinha três números na TV e uma discussão emperrada. Rodrigo, diretor comercial, defendia a nota de recomendação: "o que importa é o cliente nos indicar". Camila, de customer success, queria a satisfação com a implantação: "é ali que o cliente decide se confia". E o coordenador de suporte pedia misericórdia: "escolham uma nota só, não dá para acompanhar três". Mari Ferreira, consultora de pesquisa de satisfação, deixou a disputa correr um pouco antes de entrar: — Vocês estão escolhendo entre termômetro, fita métrica e bússola. São três instrumentos. Qual é a pergunta que vocês querem responder? Porque cada um responde uma diferente, e nenhum responde as três. Termômetro, balança e fita métrica Um médico não escolhe entre termômetro e balança: usa cada um para medir o que mede. As três grandes métricas de experiência do cliente funcionam igual: CSAT, CES e NPS não competem; respondem perguntas diferentes. A confusão entre elas (comum até em gente experiente do mercado) produz metas erradas, comparações sem sentido e discussões infinitas. Este artigo é o guia de bolso: o que cada uma mede, de onde veio, quando usar e onde escorrega. CSAT: "Você saiu satisfeito daqui?" A pergunta: "Qual seu nível de satisfação com [esta compra / este atendimento / esta visita]?", tipicamente numa escala de 1 a 5 (muito insatisfeito → muito satisfeito). O que mede: a avaliação de uma transação específica, logo depois dela. É a métrica do "aqui e agora". A conta usual: % de respostas nos dois pontos do topo (4 e 5, os "satisfeitos"). Um CSAT de 87% significa: 87 em cada 100 avaliações ficaram no topo da escala. Por que contar respostas em vez de tirar a média das notas? Primeiro, porque contar pessoas comunica melhor do que somar pontos: "87 em cada 100 saíram satisfeitos" dispensa tradução; "média 4,2" não. Segundo, porque a média esconde os extremos e trata degraus de rótulo como números equidistantes, o que a escala não garante. E o corte no topo é proposital: o 3 do "mais ou menos" não conta a favor; só entra na conta quem disse com clareza que saiu satisfeito. Linhagem: a satisfação é o construto mais antigo e estudado da área. É a base do ACSI (American Customer Satisfaction Index), o índice nacional americano criado por Claes Fornell na década de 1990, com décadas de estudos ligando satisfação a recompra e tolerância a preço. Onde brilha: diagnóstico operacional. Por ser transacional e específica ("satisfação com a fila", "com a limpeza", "com o atendimento"), aponta o que consertar e onde. É a métrica natural do totem no ponto de venda: experiência fresca, pergunta concreta, resposta em um toque. Onde escorrega: satisfação é só o ingresso: cliente satisfeito ainda troca de marca por preço ou conveniência. CSAT alto e estável pode esconder indiferença confortável. CES: "Deu trabalho resolver?" A pergunta do CES, na versão atual (CES 2.0), é uma afirmação com que o cliente concorda ou discorda: "a empresa facilitou a resolução do meu problema". O que ela mede é o esforço que o cliente gastou para conseguir o que queria, ou seja, quantas ligações, quantas repetições da mesma história, quantos obstáculos. A conta: o cliente responde numa escala de 1 a 7, de "discordo totalmente" a "concordo totalmente", e o placar sai como média das respostas (o padrão do Gartner) ou como % de concordância (respostas de 5 a 7), leitura mais segura pelo mesmo motivo do CSAT: distribuição engana menos que média. O formato de afirmação também tem um porquê: a versão original de 2010 perguntava "quanto esforço você gastou?" numa escala em que nota alta era notícia ruim, e essa polaridade invertida confundia o respondente e o leitor do relatório. O CES 2.0 refez a pergunta para que concordar aponte sempre na mesma direção: quanto maior, melhor. A métrica nasceu de um estudo do CEB (hoje parte do Gartner) publicado na Harvard Business Review em 2010 com um título provocador: "Stop Trying to Delight Your Customers" (pare de tentar encantar seus clientes). A descoberta, baseada em dezenas de milhares de atendimentos, foi que reduzir esforço prevê lealdade melhor do que encantar. Clientes não abandonam empresas por falta de "uau"; abandonam por excesso de atrito. A deslealdade nasce do retrabalho: repetir o problema, ser transferido, ter que insistir. O CES brilha em pós-atendimento, suporte, trocas, resolução de problemas e processos como cadastro, retirada e devolução. Se o processo tem um funil onde clientes "empacam", o CES encontra. Onde ele escorrega é fora desse contexto: não faz sentido perguntar esforço depois de um almoço agradável. E como mede apenas a fricção, uma experiência pode ser fácil e ainda assim medíocre. NPS: "Você apostaria sua reputação em nós?" O que mede lealdade e entusiasmo com a marca como um todo já tem artigo próprio nesta série, então só o essencial comparativo: O que mede: lealdade e entusiasmo com a marca como um todo, mais do que com a transação de hoje. Recomendação envolve colocar a própria reputação em jogo, por isso é régua mais dura que satisfação. A conta: % de promotores (notas 9 e 10) menos % de detratores (0 a 6), com os neutros (7 e 8) fora da subtração; o placar vai de −100 a +100. A subtração existe para endurecer a régua: a nota educada não conta a favor, e cada insatisfeito desconta um entusiasta em vez de se diluir numa média. Onde brilha: visão estratégica, acompanhamento de longo prazo, comparação entre unidades e benchmark com concorrentes (medidos do mesmo jeito). Onde escorrega: é termômetro, não diagnóstico: diz que a marca esfriou, mas não diz qual torneira vazou. E balança muito em amostras pequenas (a conta de % menos % dobra a sensibilidade ao ruído). CSAT CES NPS lado a lado: a tabela de bolso CSAT CES
NPS sem mistério: o que o número diz (e o que ele não diz)
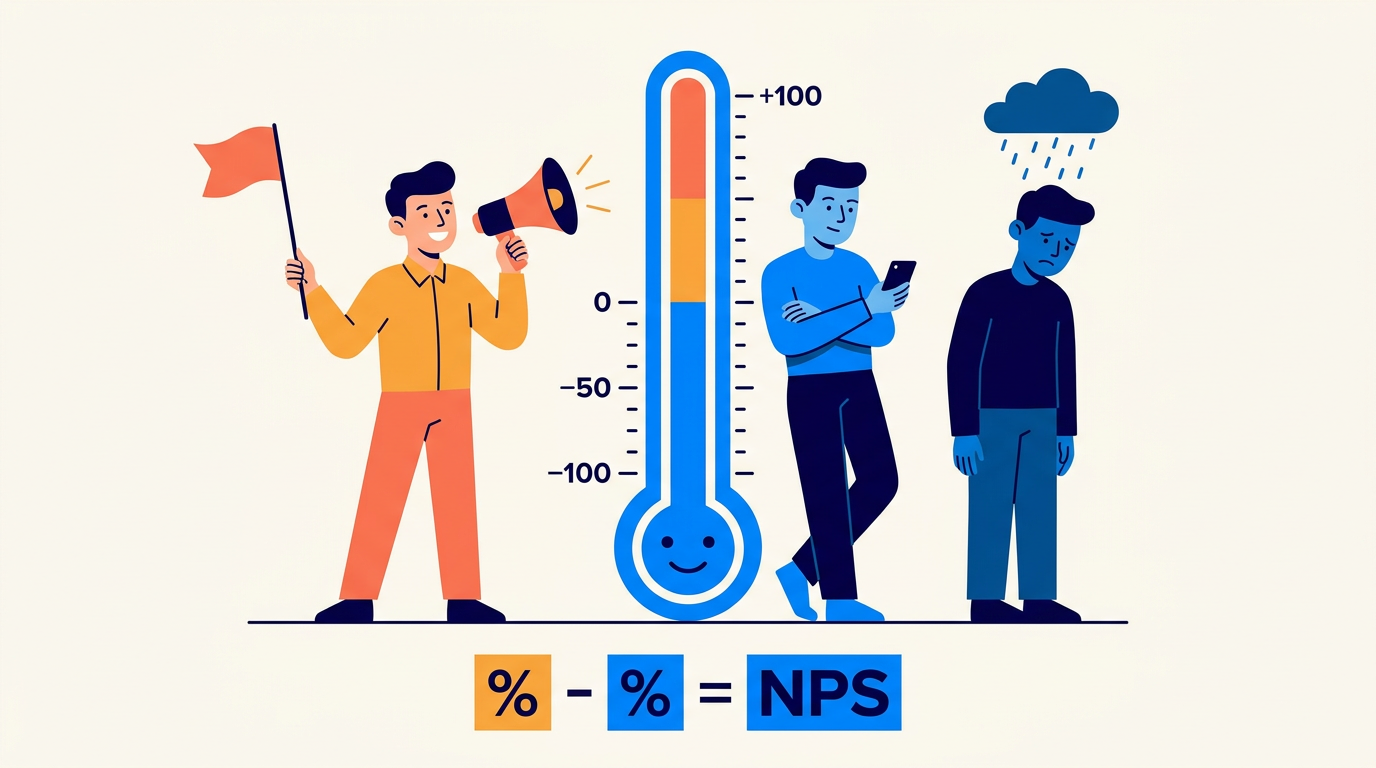
O cliente deu nota 7. Isso é bom ou ruim? Depende de quem responde — e depende de como o NPS trata essa nota. De onde veio esse número que todo mundo usa Em 2003, o consultor Frederick Reichheld, da Bain & Company, publicou na Harvard Business Review um artigo com um título ambicioso: “The One Number You Need to Grow” (o único número de que você precisa para crescer). A proposta era radical na sua simplicidade. Depois de testar dezenas de perguntas de pesquisa contra dados reais de recompra e indicação, Reichheld concluiu que uma pergunta superava quase todas as outras na maioria dos setores: “Em uma escala de 0 a 10, o quanto você recomendaria a [empresa] a um amigo ou colega?” Nascia o Net Promoter Score, o NPS. Vinte anos depois, é provavelmente a métrica de experiência do cliente mais usada no mundo, e a linguagem diária de boa parte dos nossos clientes. Por isso, todo mundo na Solvis precisa dominar a mecânica e a interpretação da métrica e, principalmente, os seus limites. A mecânica em 60 segundos As respostas de 0 a 10 dividem os clientes em três grupos: A conta: NPS = % de promotores − % de detratores O resultado vai de −100 (todo mundo detrator) a +100 (todo mundo promotor). Os neutros não entram na conta, mas entram no denominador: “empurrar” um neutro para promotor sobe o placar. Exemplo: 100 respostas, sendo 55 promotores, 30 neutros e 15 detratores. NPS = 55% − 15% = 40. As três pegadinhas de interpretação 1. A nota 7 não é “boa”, e isso é proposital. Na escola, 7 é aprovação. No NPS, 7 é neutro. Por quê? Porque as pessoas tendem a ser educadas em pesquisas e inflar notas (lembra da aquiescência, no artigo sobre perguntas?). A régua do NPS é dura de propósito: só conta como promotor quem demonstra entusiasmo inequívoco. Quando um cliente da Solvis pergunta “por que nota 8 não conta a favor?”, essa é a resposta: a escala desconta a gentileza. 2. NPS não é média. Duas lojas podem ter a mesma média de notas e NPS muito diferentes. Uma loja onde todos dão 8 tem NPS 0. Uma loja onde metade dá 10 e metade dá 6 também tem NPS 0. São situações completamente diferentes: a segunda tem fãs e insatisfeitos; a primeira, um mar de indiferença. Por isso, olhe sempre a distribuição das notas junto com o placar. 3. Comparar NPS entre setores (e países) é armadilha. O NPS “bom” varia por setor: bancos, supermercados e hospitais têm réguas naturais diferentes. Também varia com a cultura local: há evidência de que padrões de resposta a escalas mudam entre países. A comparação mais honesta é sempre você contra você mesmo ao longo do tempo, e contra concorrentes diretos medidos do mesmo jeito. O que o NPS não diz (e é aqui que nós entramos) O NPS funciona como um termômetro: mostra que há febre, mas não identifica a infecção. Um NPS que caiu de 62 para 48 não conta se o problema é fila, preço, produto ou o ar-condicionado quebrado. Por isso a pergunta de nota deve vir acompanhada da pergunta aberta (“o que motivou a sua nota?”) e de perguntas específicas por dimensão. É o conjunto que transforma o placar em diagnóstico. Vale conhecer também as críticas técnicas à métrica, publicadas em pesquisa acadêmica: estudos como o de Timothy Keiningham e colegas (Journal of Marketing, 2007) testaram a alegação de que o NPS seria o melhor preditor de crescimento e não conseguiram replicá-la: a satisfação tradicional previa crescimento tão bem quanto. O consenso prático que ficou é que o NPS vale pela simplicidade e pela comparabilidade, sem os poderes mágicos de previsão que o artigo original prometia. Quem promete que “subir NPS = crescer receita” está vendendo além da evidência. E há um risco de gestão documentado: quando o NPS vira meta de bônus individual, nasce a tentação de caçar nota em vez de melhorar a experiência (“me dá um 10 que me ajuda muito?”). Isso é uma manifestação da Lei de Goodhart: quando uma medida vira meta, deixa de ser uma boa medida. Uma nota coletada sob pressão diz mais sobre o constrangimento do cliente do que sobre a lealdade dele. O próprio criador está reclamando: e agora? Em 2025, num painel de mercado, o próprio Reichheld declarou estar “cansado de pesquisas”, e a frase virou manchete: “o NPS morreu?”. Lida por inteiro, porém, a reclamação dele tem endereço certo, e não é a métrica: é o NPS mal operado. Os alvos que ele cita são a pesquisa por e-mail em massa com 1% a 3% de resposta (amostra pequena e torta, como explica o artigo sobre amostra), a nota de cortesia ou mendigada por quem tem bônus atrelado (a Lei de Goodhart da seção anterior, em escala de mercado) e a coleta que não gera ação nenhuma. Repare: são três problemas de operação, não de fórmula, e cada um tem antídoto conhecido: coleta no momento da experiência, incentivo bem desenhado e ciclo fechado. A resposta construtiva do próprio Reichheld veio em “Net Promoter 3.0” (Harvard Business Review, 2021): complementar o placar declarado com uma régua comportamental, o Earned Growth Rate, que separa a receita “ganha” (clientes que voltam e clientes que chegam por indicação) da receita “comprada” (aquisição paga). A lógica é elegante: o promotor de verdade aparece no caixa, não só no questionário. É uma régua auditável e imune ao pedido de dez, embora exija um rastreamento da origem de cada cliente que poucas empresas têm hoje. Para a leitura diária, fica a lição: nota declarada e comportamento real são dois termômetros que se vigiam, e divergência entre eles é informação. No mesmo embalo, parte do mercado prega substituir pesquisas por “sinais” capturados por IA: carrinho abandonado, cliques de raiva, tom de voz. Dois cuidados antes de aderir. Primeiro, quem faz esse diagnóstico costuma vender exatamente a plataforma de sinais que receita, então separe o diagnóstico
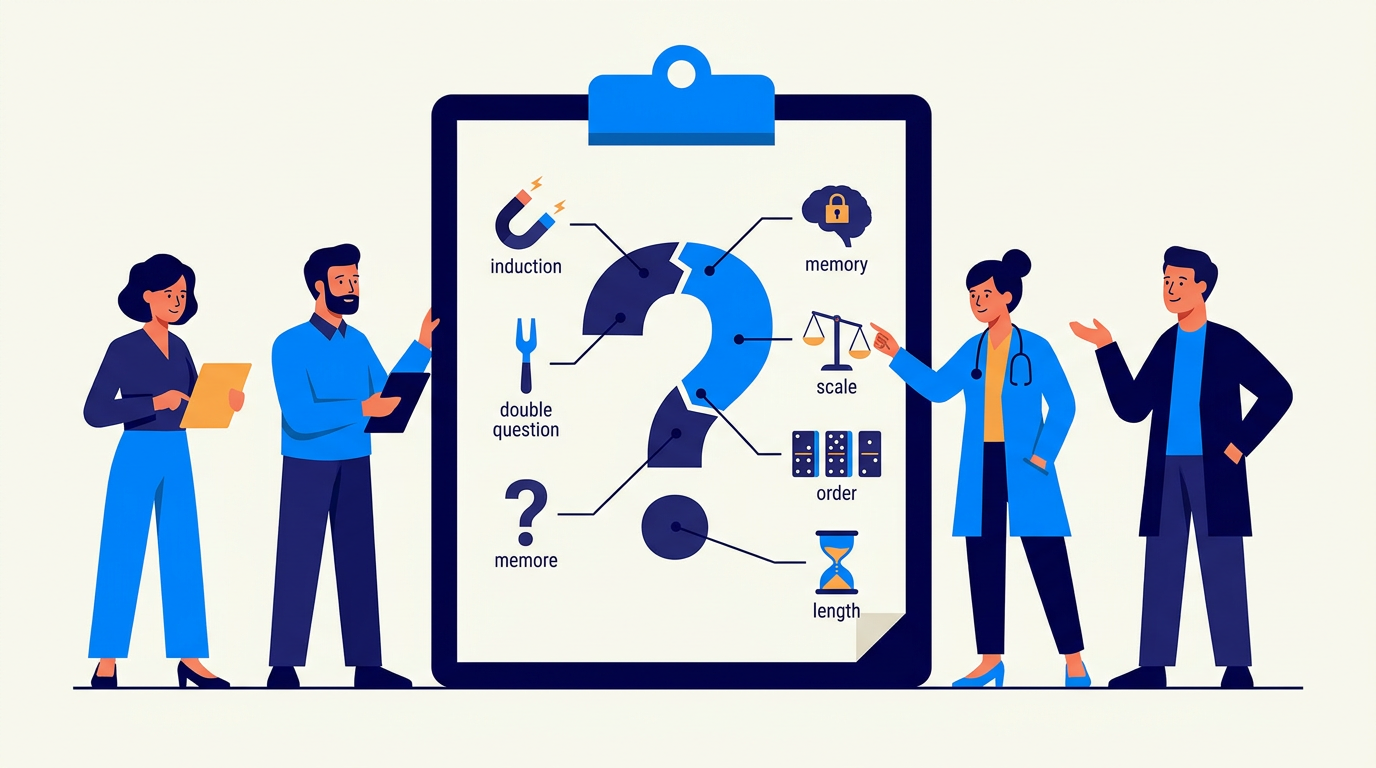
Anatomia de uma boa pergunta: Por que o jeito de perguntar muda a resposta
“Você gostou?” e “O que achou?” parecem iguais. Não são. Toda pergunta de pesquisa é um instrumento de medição, e instrumentos mal calibrados enganam. Na Clínica Aurora Wagner, administrador da Clínica Aurora, uma rede de clínicas médicas, tinha um rascunho pronto para o totem da recepção e a satisfação de quem enxugou tudo em uma linha: “Você ficou satisfeito com o atendimento da recepção e da equipe médica?”. Curta, educada, direta. Mari Ferreira, consultora da Solvis que acompanhava a implantação, leu a pergunta duas vezes e devolveu o notebook com outra pergunta no lugar de uma opinião: — Se o paciente responder 3… o que exatamente você vai consertar? Wagner abriu a boca para responder e percebeu a armadilha no meio do caminho. Um 3 podia ser uma hora de espera com uma consulta excelente, um médico atencioso atrás de uma recepção caótica, ou um paciente irritado com o convênio, sem culpa de ninguém dali. A pergunta era uma só; as respostas dentro dela eram três. A pergunta de pesquisa: o instrumento mais delicado “Um termômetro mal calibrado mede a febre errada. Uma balança desregulada mente o peso. E uma pergunta mal formulada coleta uma opinião que o cliente não tem.” A pergunta é o instrumento de medição da pesquisa, e é um instrumento delicado. Décadas de pesquisa em metodologia de questionários (a área tem até nome: survey methodology) mostram que mudanças aparentemente inocentes na redação, na ordem ou nas opções de resposta alteram os resultados de forma mensurável. Um exemplo clássico: em experimentos conduzidos pela psicóloga Elizabeth Loftus nos anos 1970, pessoas assistiam ao vídeo de um acidente de carro. Quando perguntadas “a que velocidade os carros iam quando se esmagaram?”, as estimativas eram significativamente maiores do que quando o verbo era “se bateram”. Uma palavra mudou a memória do que as pessoas viram. Se uma palavra faz isso com uma memória, imagine o que faz com uma opinião. Todo mundo na Solvis, de vendas a suporte, deveria saber reconhecer uma pergunta ruim. Este artigo é o manual de anatomia. As 7 fraturas mais comuns de uma pergunta 1. A pergunta induzida (leading question) Ela já carrega a resposta desejada dentro de si. “Você gostou?” pressupõe que houve gosto, e as pessoas tendem a concordar com pressuposições, um fenômeno documentado chamado aquiescência (a tendência de responder “sim” independentemente do conteúdo). “O que achou?” abre espaço para qualquer resposta. Parecem iguais; medem coisas diferentes. 2. A pergunta dupla (double-barreled) Duas perguntas vestidas de uma. Impossível responder com uma nota só. E se foi rápido e grosseiro? A nota 3 significa o quê? Regra simples: um assunto por pergunta. Se tem “e” no meio, desconfie. 3. A pergunta que exige memória demais Ninguém lembra. O respondente não deixa em branco: inventa um número plausível. Pergunte sobre períodos curtos e experiências recentes, tema tão importante para nós que tem artigo próprio nesta série (O momento da verdade). 4. O jargão e a ambiguidade Cada respondente entende uma coisa, e a média de interpretações diferentes não significa nada. Use a linguagem do respondente, não a da empresa. E troque termos vagos por quantidades. 5. A escala torta A escala é metade da pergunta. Fraturas comuns: A referência clássica aqui é a escala Likert (proposta pelo psicólogo Rensis Likert em 1932): afirmação + graus simétricos de concordância, com ponto neutro. Simples, testada há quase um século, e ainda assim frequentemente mal copiada. 6. A ordem que contamina Perguntas anteriores criam contexto para as seguintes. Perguntar “qual foi o problema do seu atendimento?” antes de “qual sua satisfação geral?” faz a nota geral cair: o respondente foi convidado a lembrar do problema primeiro. Regra prática: do geral para o específico, e perguntas delicadas (incluindo dados pessoais) por último. 7. O questionário-maratona Cada pergunta a mais custa atenção, e atenção é o que o respondente tem de mais escasso. Questionários longos sofrem de abandono e de respostas em linha reta (o respondente marca tudo 5 só para acabar logo, fenômeno conhecido como straightlining). No ponto de venda, onde o cliente responde em pé, no caminho da saída, a disciplina é ainda mais brutal: cada pergunta precisa pagar o próprio aluguel. Se a resposta não vai mudar nenhuma decisão, a pergunta não deveria existir. O teste de bancada: 5 perguntas antes de publicar Antes de qualquer questionário ir a campo, submeta cada pergunta a este checklist: E o teste final, herdado do método científico: teste-piloto. Peça para 5 pessoas responderem na sua frente, falando em voz alta o que entendem de cada pergunta (a técnica formal se chama entrevista cognitiva). É impressionante o que 20 minutos disso revelam. Por que isso importa para nós O cliente da Solvis não compra “um totem”: compra respostas confiáveis. E não existe resposta confiável saída de pergunta ruim: viés na entrada, lixo na saída. Saber reconhecer uma pergunta fraturada é, portanto, uma competência que atravessa toda a operação de quem coleta dados de satisfação: de quem atende o cliente no dia a dia a quem desenha os questionários e os fluxos de coleta. Cada pergunta bem formulada é um voto de confiança no dado que ela vai gerar — e cada uma malfeita é um ponto cego que ninguém percebe até doer. De volta à Aurora Na Aurora, a pergunta dupla virou duas perguntas inteiras, cada uma com um dono claro do outro lado: recepção para a escala e o fluxo de senhas, equipe médica para a coordenação clínica. Na primeira semana de coleta, o mistério se desfez: equipe médica 4,8, recepção 3,8. A nota que a pergunta emendada teria misturado num 4,3 sem endereço apontava agora para a espera do balcão, invisível até então. O teste da Mari entrou no ritual de bancada da clínica: antes de publicar qualquer pergunta, alguém responde mal a ela de propósito, e a equipe confere se saberia o que consertar. Pergunta que não passa, não entra. O resumo de uma frase (teste Feynman) “A pergunta é uma balança: se ela estiver torta, não
Cliente neutro: O risco oculto
Nem todo cliente que não reclama está, de fato, satisfeito. Muitas vezes interpretamos a ausência de críticas como um sinal positivo, enquanto na prática isso pode esconder um risco silencioso. Os clientes neutros continuam utilizando o serviço ou produto, mas sem vínculo emocional, sem engajamento e com altas chances de saída ao primeiro problema ou alternativa melhor.
Mantendo a Experiência em Toda a Rede
Para empresas que operam com múltiplas unidades, franquias ou pontos de contato híbridos, a consistência não é mais um diferencial estético, mas a espinha dorsal da sobrevivência econômica.
Unidade A vs. Unidade B: O Diagnóstico de Rede que Revela Lucros Ocultos
Em 2026, a tecnologia de varejo deixou de ser uma camada de suporte para se tornar a base da execução das lojas. O surgimento de “superapps” de varejo permite unificar múltiplas capacidades — desde a gestão de escala até o treinamento e a comunicação — em uma única interface para o funcionário da linha de frente.

Carnaval 2026: Mantendo a Qualidade em Meio aos Pontos Facultativos
O Carnaval no Brasil transcende a mera festividade; ele é, em essência, o maior exame de proficiência operacional que uma empresa pode enfrentar. Ao olharmos para o horizonte de 2026, compreendemos que a maestria na gestão de serviços não nasce do improviso, mas da observação atenta dos rastros deixados pelos anos que nos precederam. Convido você a enxergar o ano de 2025 não apenas como uma lembrança estatística, mas como a bússola fundamental que orienta nossas decisões para o ciclo atual. A qualidade, especialmente em períodos de pontos facultativos, é um edifício construído sobre a rocha dos dados e a agilidade da resposta em tempo real.

Alertas de Detração em Tempo Real: Não espere a reunião trimestral. Aja imediatamente sobre problemas de serviço.
O cenário corporativo de 2026 não tolera a latência. O que antes era considerado um ciclo de gestão aceitável — a revisão trimestral de indicadores — tornou-se, na prática, uma autópsia de oportunidades perdidas. Em um mercado onde a fidelidade é volátil e a concorrência está a apenas um clique ou uma esquina de distância, a capacidade de identificar a insatisfação e reagir instantaneamente deixou de ser um diferencial competitivo para se tornar uma condição de sobrevivência. A detração, quando não tratada no “momento da verdade”, atua como um vazamento silencioso de capital, erodindo a reputação da marca e drenando o valor do tempo de vida do cliente antes mesmo que os diretores possam visualizar o primeiro slide de uma apresentação de resultados.
