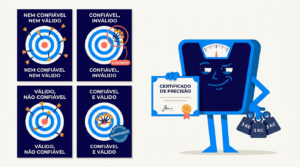
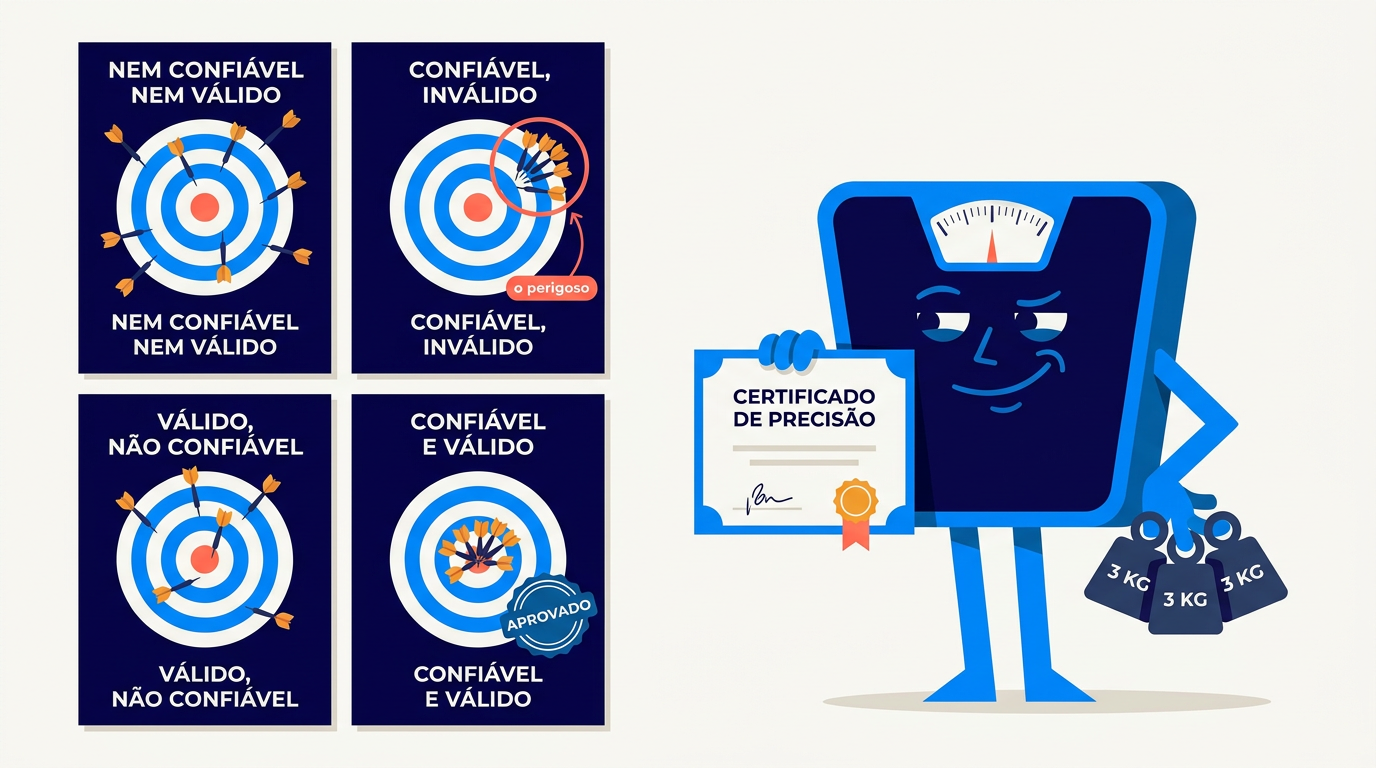
Uma balança que marca sempre 3 quilos a menos é confiável, e mente todos os dias. Validade e confiabilidade são as duas perguntas que todo instrumento de medição precisa responder.
Na Clínica Aurora
Na auditoria anual do questionário da Clínica Aurora, rede de clínicas médicas, Wagner, o administrador, parou numa pergunta veterana: “Você se sentiu bem na clínica?”. Criada dois anos antes, ela tinha um propósito original de que quase ninguém lembrava: monitorar a limpeza das unidades.
A série histórica denunciava o problema: a nota oscilava com o tempo de espera, despencava nas semanas de calor (ar-condicionado no limite), subia em dezembro com a decoração de fim de ano, e permanecia serenamente indiferente aos dois episódios reais de falha de limpeza que a clínica tinha registrado no período. O instrumento era estável, até consistente no seu jeito: media alguma coisa, sempre do mesmo modo. Só não media limpeza. Media um humor geral de “estar bem”, temperado de espera e temperatura.
— A régua não treme — resumiu Wagner para Mari, a consultora da Solvis. — Ela aponta para o alvo errado, com firmeza admirável.
Validade e confiabilidade: as duas perguntas que ninguém faz ao instrumento
Antes de confiar em qualquer medição (de temperatura, de peso ou de satisfação), a metrologia faz duas perguntas distintas:
- O instrumento é consistente? Medindo a mesma coisa duas vezes, dá o mesmo resultado? Isso é confiabilidade (reliability).
- O instrumento mede o que deveria? O número que sai corresponde ao conceito que se queria medir? Isso é validade (validity).
São independentes, e a combinação delas define quatro destinos possíveis para uma pesquisa. A imagem clássica é o alvo de dardos:
- Dardos espalhados pelo alvo todo: nem confiável, nem válido. Ruído puro.
- Dardos agrupados, mas no canto errado: confiável e inválido: o caso mais perigoso, porque parece ciência. A balança dos 3 quilos a menos: precisa, consistente, errada.
- Dardos em volta do centro, mas espalhados: válido na média, impreciso no caso a caso.
- Dardos agrupados no centro: confiável e válido. O objetivo.
O mercado de pesquisa vive cheio de balanças do segundo tipo: séries históricas lindas, estáveis, comparáveis, medindo consistentemente a coisa errada.
Confiabilidade: o instrumento não pode tremer
Três formas práticas de tremor, e como detectá-las:
Tremor no tempo (estabilidade). Se nada mudou na operação, a medição deveria dar parecido esta semana e na próxima. Oscilação grande sem causa é sinal de instrumento ruim, ou de amostra pequena demais (artigo Amostra: antes de culpar o instrumento, confira a margem de erro; artigo Diferença real ou ruído?: diferença real ou ruído?).
Tremor entre itens (consistência interna). Se cinco perguntas pretendem medir a mesma dimensão (digamos, “presteza”; artigo As cinco dimensões da qualidade de serviço), as respostas delas deveriam andar juntas. Quando uma destoa sistematicamente das irmãs, ela provavelmente mede outra coisa. A psicometria tem um índice clássico para isso, o alfa de Cronbach, que resume o quanto os itens de um grupo variam juntos. Não é preciso calculá-lo à mão; é preciso saber que a pergunta “esses itens medem mesmo a mesma coisa?” tem resposta verificável.
Tremor entre leitores (concordância). Vale para a análise qualitativa: dois analistas categorizando os mesmos comentários (artigo Quali e quanti) deveriam chegar a etiquetas parecidas. Se cada um classifica de um jeito, o “31% citam espera” muda conforme quem conta. O instrumento aqui é o esquema de categorias, e ele está trêmulo.
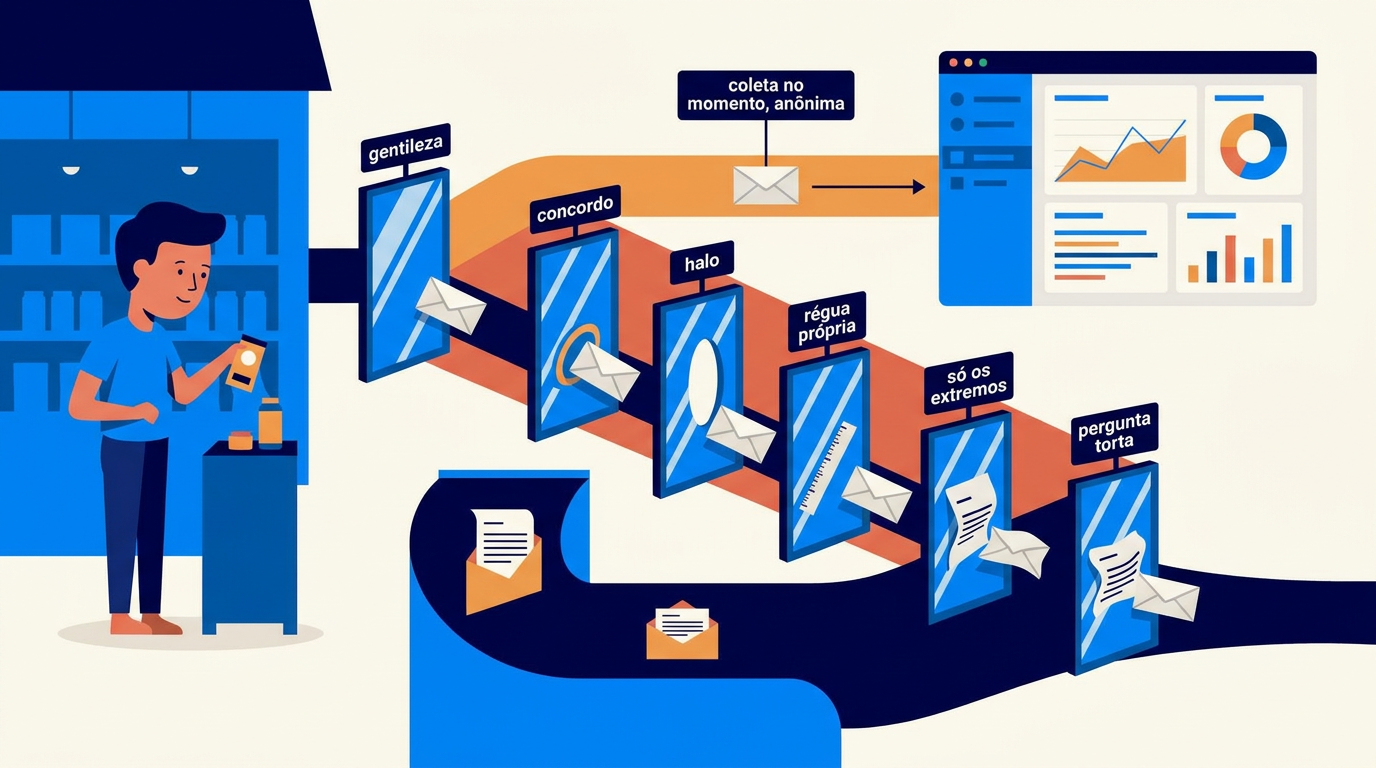
O que mais destrói confiabilidade na prática: perguntas ambíguas (cada um entende uma coisa; artigo Anatomia de uma boa pergunta), escalas sem rótulos (cada um inventa a régua; artigo Escala Likert) e mudanças de redação no meio da série histórica (mudou a pergunta, nasceu outro instrumento e a série quebrou; artigo Escala Likert, pecado 3).
Validade: o instrumento não pode apontar para o lugar errado
Quatro testes, do mais barato ao mais forte:
1. Validade de face: o teste do cheiro. A pergunta parece medir o que promete, para quem lê? “Você recomendaria?” tem cara de lealdade; “quantas estrelas?” tem cara de… alguma coisa. É o teste mais fraco, mas filtra os absurdos. O pré-teste cognitivo é onde ele acontece de verdade: descobrir o que o respondente entendeu pode ser bem diferente do que se perguntou.
2. Validade de conteúdo: o mapa cobre o território? “Satisfação com a loja” tem dimensões (artigo As cinco dimensões da qualidade de serviço: confiabilidade, presteza, segurança, empatia, tangíveis). Um questionário que só pergunta sobre limpeza mede um pedaço e assina pelo todo. Teste prático: liste as dimensões da experiência real do cliente (os comentários abertos são o mapa; artigo Quali e quanti) e confira o que o questionário cobre.
3. Validade de construto: o número se comporta como o conceito? Se sua métrica mede mesmo satisfação, ela deveria se relacionar com as coisas que a teoria manda: subir quando o serviço melhora, andar junto com recompra, cair após incidentes. Métrica que não reage a nada que deveria movê-la está medindo outra coisa (ou nada; artigo Métricas de vaidade).
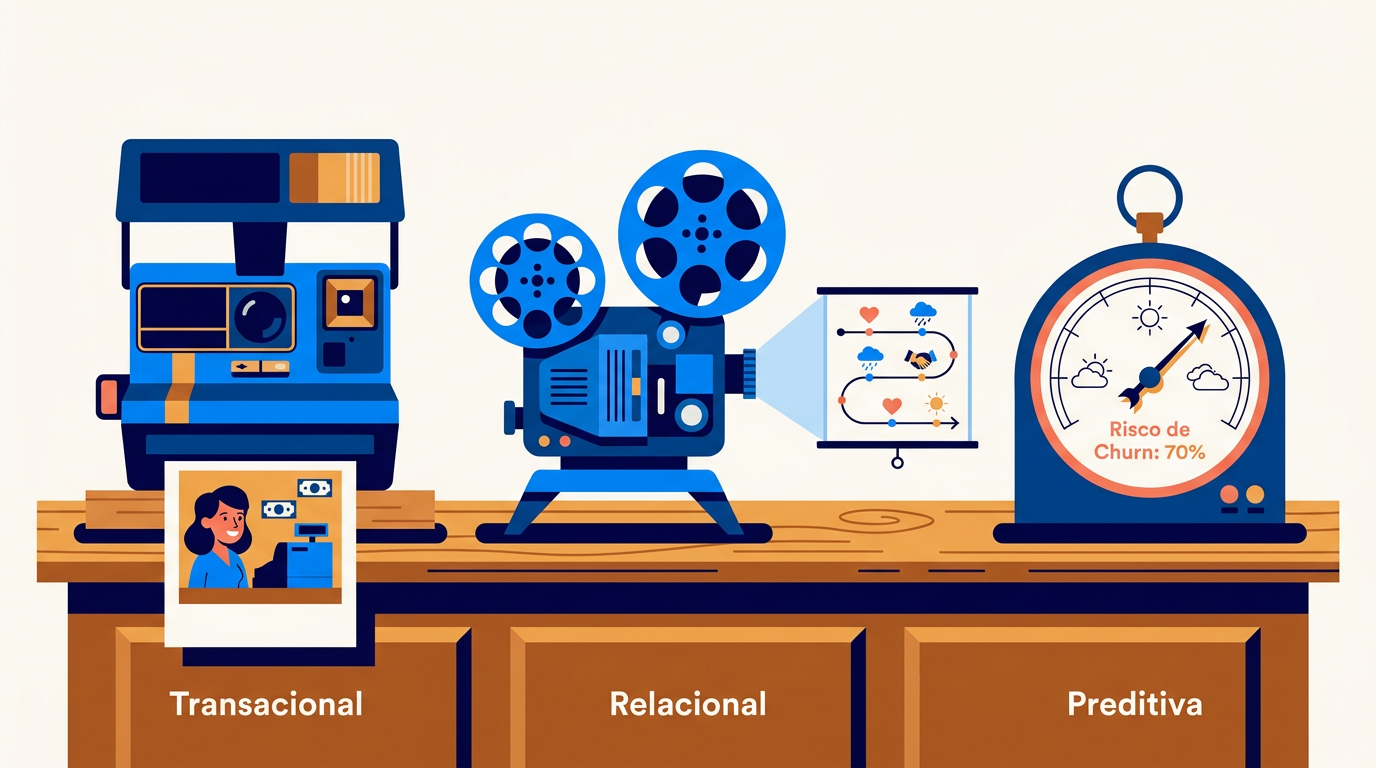
4. Validade preditiva: o teste supremo. A nota de hoje prevê o comportamento de amanhã? Detratores abandonam mais? Notas de espera baixas antecedem queda de fluxo no horário? É o teste mais caro, porque exige cruzar pesquisa com comportamento real ao longo do tempo (artigo Tipos de pesquisa, pesquisa preditiva), e o único que fecha a questão. A literatura que ligou satisfação a resultado financeiro (artigo O caso financeiro da satisfação) é exatamente isso: validação preditiva em escala acadêmica.
O checklist do instrumento honesto
Antes de confiar numa série de dados, sua ou de terceiros:
- Mesma pergunta, mesma escala, desde quando? (Mudou? Anote a data; desconfie das comparações que cruzam a fronteira.)
- Os itens que dizem medir a mesma dimensão andam juntos?
- O questionário cobre as dimensões que aparecem nos comentários?
- A métrica reage ao que deveria movê-la? (Melhorias reais aparecem no número?)
- Alguém já conferiu se ela prevê comportamento? (Ou estamos todos apenas acreditando?)
Cinco perguntas que separam medição de ritual.
Por que isso importa
Quando alguém pergunta “essa pesquisa funciona mesmo?”, está perguntando, sem o vocabulário, sobre validade e confiabilidade. Quem domina esses conceitos responde com critérios, não com convicção: mostra a consistência da série, o vínculo entre nota e comportamento, a cobertura das dimensões. É a diferença entre pedir confiança e demonstrá-la.
De volta à Aurora
Na Aurora, a pergunta simpática e inválida foi aposentada com honras e substituída por duas específicas, cada uma mirando o que a decisão precisava: limpeza (“recepção, consultório e banheiro estavam limpos?”) e conforto (“espera, temperatura e acomodação estavam bem?”). Na primeira falha de limpeza seguinte, a pergunta nova acusou o golpe em dois dias: exatamente o que a antiga nunca tinha feito.
A auditoria anual ganhou o ritual dos alvos de dardos: para cada pergunta do questionário, “ela acerta sempre o mesmo lugar?” (confiabilidade) e “o lugar que ela acerta é o que queremos medir?” (validade). Pergunta que treme, conserta-se; pergunta que aponta para o alvo errado, por mais firme que seja, troca-se.
O resumo de uma frase (teste Feynman)
“Confiabilidade é o instrumento dar sempre a mesma resposta; validade é a resposta ser sobre a pergunta certa; e uma pesquisa precisa das duas para merecer decisão.”
Fontes e leituras recomendadas
- CARMINES, Edward G.; ZELLER, Richard A. Reliability and Validity Assessment. Sage, 1979. (A introdução clássica e curta ao par de conceitos.)
- CRONBACH, Lee J. “Coefficient Alpha and the Internal Structure of Tests”. Psychometrika, v. 16, 1951. (O artigo original do alfa.)
- CHURCHILL, Gilbert A. “A Paradigm for Developing Better Measures of Marketing Constructs”. Journal of Marketing Research, v. 16, 1979. (O roteiro canônico para construir métricas de marketing que medem o que prometem.)
- DEVELLIS, Robert F. Scale Development: Theory and Applications. 5ª ed. Sage, 2021. (O manual moderno de construção de escalas.)
- MORGAN, Neil A.; REGO, Lopo L. “The Value of Different Customer Satisfaction and Loyalty Metrics in Predicting Business Performance”. Marketing Science, v. 25, 2006. (Validade preditiva das métricas de satisfação, na prática.)