“Você gostou?” e “O que achou?” parecem iguais. Não são.
Na Clínica Aurora
Wagner, administrador da Clínica Aurora, uma rede de clínicas médicas, tinha um rascunho pronto para o totem da recepção e a satisfação de quem enxugou tudo em uma linha: “Você ficou satisfeito com o atendimento da recepção e da equipe médica?”. Curta, educada, direta.
Mari Ferreira, consultora da Solvis que acompanhava a implantação, leu a pergunta duas vezes e devolveu o notebook com outra pergunta no lugar de uma opinião:
— Se o paciente responder 3… o que exatamente você vai consertar?
Wagner abriu a boca para responder e percebeu a armadilha no meio do caminho. Um 3 podia ser uma hora de espera com uma consulta excelente, um médico atencioso atrás de uma recepção caótica, ou um paciente irritado com o convênio, sem culpa de ninguém dali. A pergunta era uma só; as respostas dentro dela eram três.
O instrumento mais delicado da pesquisa
“Um termômetro mal calibrado mede a febre errada. Uma balança desregulada mente o peso. E uma pergunta mal formulada coleta uma opinião que o cliente não tem.”
A pergunta é o instrumento de medição da pesquisa, e é um instrumento delicado. Décadas de pesquisa em metodologia de questionários (a área tem até nome: survey methodology) mostram que mudanças aparentemente inocentes na redação, na ordem ou nas opções de resposta alteram os resultados de forma mensurável.
Um exemplo clássico: em experimentos conduzidos pela psicóloga Elizabeth Loftus nos anos 1970, pessoas assistiam ao vídeo de um acidente de carro. Quando perguntadas “a que velocidade os carros iam quando se esmagaram?”, as estimativas eram significativamente maiores do que quando o verbo era “se bateram”. Uma palavra mudou a memória do que as pessoas viram.
Se uma palavra faz isso com uma memória, imagine o que faz com uma opinião. Todo mundo na Solvis, de vendas a suporte, deveria saber reconhecer uma pergunta ruim. Este artigo é o manual de anatomia.
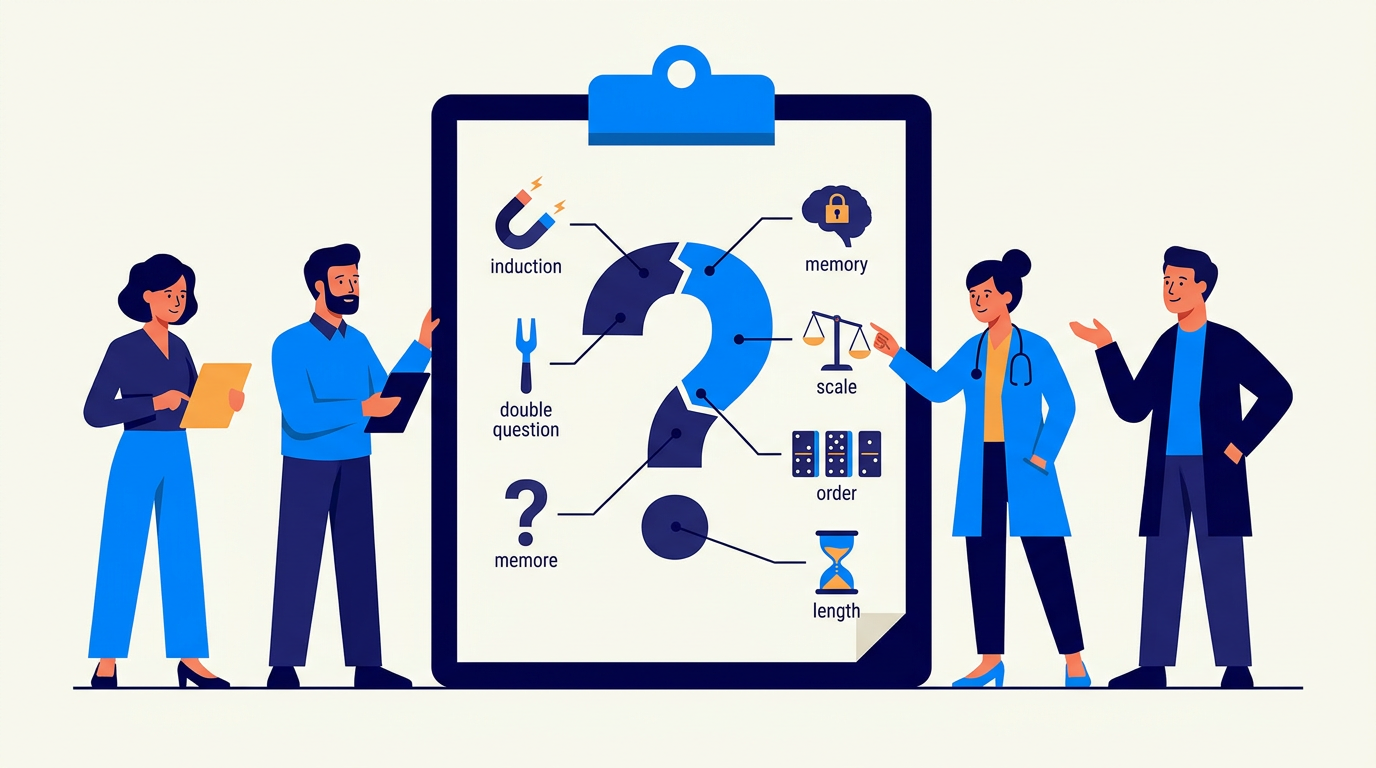
As 7 fraturas mais comuns de uma pergunta
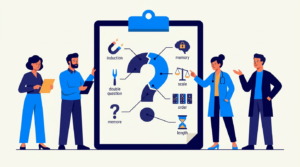
1. A pergunta induzida (leading question)
Ela já carrega a resposta desejada dentro de si.
- Ruim: “Você concorda que nosso atendimento melhorou?”
- Ruim: “O quanto você gostou da nossa nova loja?”
- Melhor: “Como você avalia o atendimento de hoje?”
- Melhor: “O que você achou da nova loja?”
“Você gostou?” pressupõe que houve gosto, e as pessoas tendem a concordar com pressuposições, um fenômeno documentado chamado aquiescência (a tendência de responder “sim” independentemente do conteúdo). “O que achou?” abre espaço para qualquer resposta. Parecem iguais; medem coisas diferentes.
2. A pergunta dupla (double-barreled)
Duas perguntas vestidas de uma. Impossível responder com uma nota só.
- Ruim: “Como você avalia a rapidez e a cordialidade do atendimento?”
E se foi rápido e grosseiro? A nota 3 significa o quê? Regra simples: um assunto por pergunta. Se tem “e” no meio, desconfie.
3. A pergunta que exige memória demais
- Ruim: “Quantas vezes você visitou nossa loja nos últimos 12 meses?”
Ninguém lembra. O respondente não deixa em branco: inventa um número plausível. Pergunte sobre períodos curtos e experiências recentes, tema tão importante para nós que tem artigo próprio nesta série (O momento da verdade).
4. O jargão e a ambiguidade
- Ruim: “Como você avalia nossa omnicanalidade?”
- Ruim: “Você visita nossa loja frequentemente?” (o que é “frequentemente”? Toda semana? Todo mês?)
Cada respondente entende uma coisa, e a média de interpretações diferentes não significa nada. Use a linguagem do respondente, não a da empresa. E troque termos vagos por quantidades.
5. A escala torta
A escala é metade da pergunta. Fraturas comuns:
- Desequilíbrio: “Excelente / Ótimo / Bom / Regular”: três opções positivas, uma neutra, nenhuma negativa. O resultado nasce inflado.
- Opções que se sobrepõem: “1 a 5 visitas / 5 a 10 visitas”. Quem visitou 5 marca onde?
- Falta de saída honesta: sem “não sei” ou “não se aplica”, quem não tem opinião inventa uma.
A referência clássica aqui é a escala Likert (proposta pelo psicólogo Rensis Likert em 1932): afirmação + graus simétricos de concordância, com ponto neutro. Simples, testada há quase um século, e ainda assim frequentemente mal copiada.
6. A ordem que contamina
Perguntas anteriores criam contexto para as seguintes. Perguntar “qual foi o problema do seu atendimento?” antes de “qual sua satisfação geral?” faz a nota geral cair: o respondente foi convidado a lembrar do problema primeiro. Regra prática: do geral para o específico, e perguntas delicadas (incluindo dados pessoais) por último.
7. O questionário-maratona
Cada pergunta a mais custa atenção, e atenção é o que o respondente tem de mais escasso. Questionários longos sofrem de abandono e de respostas em linha reta (o respondente marca tudo 5 só para acabar logo, fenômeno conhecido como straightlining). No ponto de venda, onde o cliente responde em pé, no caminho da saída, a disciplina é ainda mais brutal: cada pergunta precisa pagar o próprio aluguel. Se a resposta não vai mudar nenhuma decisão, a pergunta não deveria existir.
O teste de bancada: 5 perguntas antes de publicar
Antes de qualquer questionário ir a campo, submeta cada pergunta a este checklist:
- Ela induz alguma resposta? (Leia como se você fosse o advogado do resultado contrário.)
- Ela pergunta uma coisa só?
- Uma pessoa com pressa, no celular ou num totem, entende de primeira?
- A escala é equilibrada, sem sobreposição, com saída honesta?
- O que exatamente faremos com essa resposta? (Se ninguém souber, corte.)
E o teste final, herdado do método científico: teste-piloto. Peça para 5 pessoas responderem na sua frente, falando em voz alta o que entendem de cada pergunta (a técnica formal se chama entrevista cognitiva). É impressionante o que 20 minutos disso revelam.
Por que isso importa para nós
O cliente da Solvis não compra “um totem”: compra respostas confiáveis. E não existe resposta confiável saída de pergunta ruim: viés na entrada, lixo na saída.
Saber reconhecer uma pergunta fraturada é, portanto, uma competência que atravessa toda a operação de quem coleta dados de satisfação: de quem atende o cliente no dia a dia a quem desenha os questionários e os fluxos de coleta. Cada pergunta bem formulada é um voto de confiança no dado que ela vai gerar — e cada uma malfeita é um ponto cego que ninguém percebe até doer.
De volta à Aurora
Na Aurora, a pergunta dupla virou duas perguntas inteiras, cada uma com um dono claro do outro lado: recepção para a escala e o fluxo de senhas, equipe médica para a coordenação clínica. Na primeira semana de coleta, o mistério se desfez: equipe médica 4,8, recepção 3,8. A nota que a pergunta emendada teria misturado num 4,3 sem endereço apontava agora para a espera do balcão, invisível até então.
O teste da Mari entrou no ritual de bancada da clínica: antes de publicar qualquer pergunta, alguém responde mal a ela de propósito, e a equipe confere se saberia o que consertar. Pergunta que não passa, não entra.
O resumo de uma frase (teste Feynman)
“A pergunta é uma balança: se ela estiver torta, não importa quantas pessoas você pese; todos os pesos sairão errados.”
Fontes e leituras recomendadas
LOFTUS, Elizabeth F.; PALMER, John C. “Reconstruction of Automobile Destruction”. Journal of Verbal Learning and Verbal Behavior, v. 13, 1974.
LIKERT, Rensis. “A Technique for the Measurement of Attitudes”. Archives of Psychology, n. 140, 1932.
KROSNICK, Jon A. “Survey Research”. Annual Review of Psychology, v. 50, 1999. (Referência sobre aquiescência, straightlining e efeitos de ordem.)
SCHUMAN, Howard; PRESSER, Stanley. Questions and Answers in Attitude Surveys. Academic Press, 1981. (O estudo clássico sobre efeitos de redação e ordem de perguntas.)
BRADBURN, Norman; SUDMAN, Seymour; WANSINK, Brian. Asking Questions: The Definitive Guide to Questionnaire Design. Jossey-Bass, 2004.