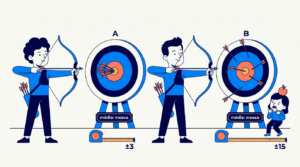
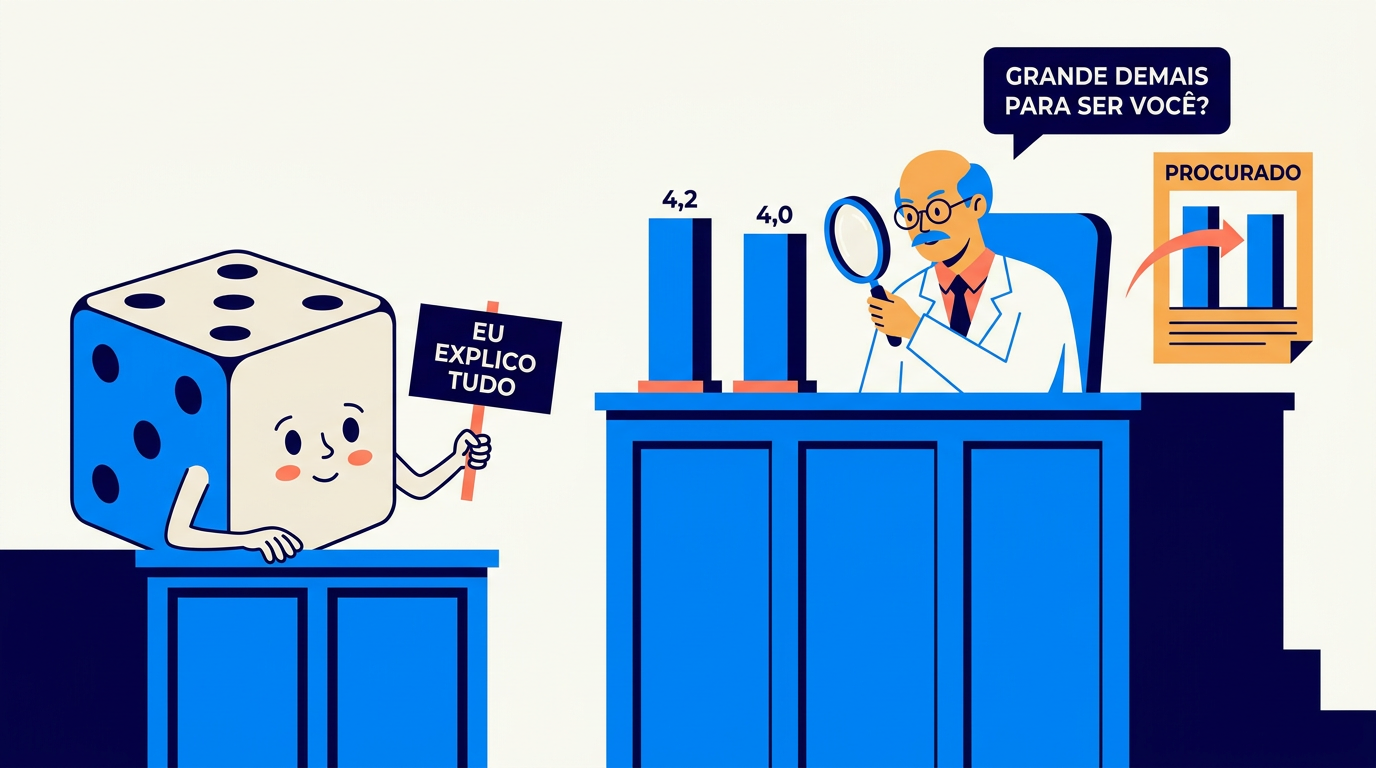
Loja A: 4,2. Loja B: 4,0. Antes de premiar a Loja A, teste a significância estatística: jogue uma moeda cem vezes.
No Hotel Cambará
Os dois e-mails saíram da mesma sala do Hotel Cambará, com trinta dias de diferença. O primeiro, em tom de festa: "Parabéns, equipe! Nota geral subiu de 4,3 para 4,5. O trabalho está aparecendo!". O segundo, em tom de crise: "Precisamos conversar. Caímos de 4,5 para 4,3. Reunião amanhã às 8h". Os dois assinados por Otávio, o gerente-geral.
Luana, a chefe de recepção, releu os dois antes da reunião das 8h e fez a conta que ninguém tinha pedido: com o volume mensal de avaliações do hotel, a nota oscilava naturalmente uns dois décimos para cada lado, sem que nada de real mudasse. A festa e a crise tinham a mesma amplitude do vaivém de sempre.
Ela levou os dois e-mails impressos para Otávio, lado a lado:
— Antes da reunião das 8h, uma pergunta: e se os dois meses forem o mesmo mês?
O experimento da moeda
Pegue uma moeda honesta e lance 100 vezes. Você espera 50 caras, mas quase nunca sai exatamente 50. Sai 46, 53, 48. Lance de novo: 55. A moeda não mudou; o acaso produz variação sem nenhuma causa por trás.
Agora troque a moeda por notas de satisfação. A Loja A fez 4,2 este mês; a Loja B, 4,0. A pergunta de um milhão de reais: essa diferença é como 53 caras contra 48 (flutuação de moeda honesta), ou as lojas são de fato diferentes?
Toda a maquinaria da "significância estatística" existe para responder essa única pergunta. E dá para entendê-la inteira sem uma fórmula.
Significância estatística: a lógica do advogado do diabo
O raciocínio estatístico clássico funciona como um tribunal às avessas. Diante da diferença entre A e B, o estatístico banca o advogado do diabo e assume o tédio como hipótese: "suponha que as lojas são idênticas e tudo isso é acaso" (a chamada hipótese nula). Depois pergunta:
"Se fosse só acaso, seria comum ver uma diferença deste tamanho?"
- Se a resposta é "sim, o acaso produz isso toda hora" → não temos evidência de nada. A diferença é declarada não significativa.
- Se a resposta é "não, o acaso quase nunca produz algo tão grande" → o tédio fica insustentável. A diferença é declarada estatisticamente significativa.
O famoso valor-p é só o número que quantifica essa resposta: a probabilidade de o acaso sozinho gerar uma diferença pelo menos tão grande quanto a observada. O costume (herdado do estatístico Ronald Fisher, nos anos 1920) de usar 5% como linha de corte é convenção, não lei da natureza: um combinado social sobre quanto risco de falso alarme aceitamos.
Intuição rápida: com poucas centenas de respostas por loja, uma diferença de 4,2 vs. 4,0 numa escala de 5 frequentemente cabe dentro do que o acaso produz — a mesma conclusão da margem de erro, vista por outro ângulo. Premiar a Loja A por isso é premiar o cara-ou-coroa.
As cinco pegadinhas que até gente experiente comete
1. "Significativo" não significa "importante".
Palavra traiçoeira. Com amostra gigante, uma diferença de 0,02 ponto pode ser "estatisticamente significativa": real, porém irrelevante para qualquer decisão. Significância diz "provavelmente não é acaso"; nunca diz "é grande" ou "vale dinheiro". Sempre pergunte pelas duas coisas: é real? E é relevante?
2. "Não significativo" não significa "igual".
Ausência de evidência não é evidência de ausência. Com 30 respostas por loja, quase nenhuma diferença atinge significância: o teste está míope, não o mundo homogêneo. A conclusão honesta é "não dá para afirmar com esta amostra", nunca "provamos que é tudo igual".
3. "Quase significativo" não existe.
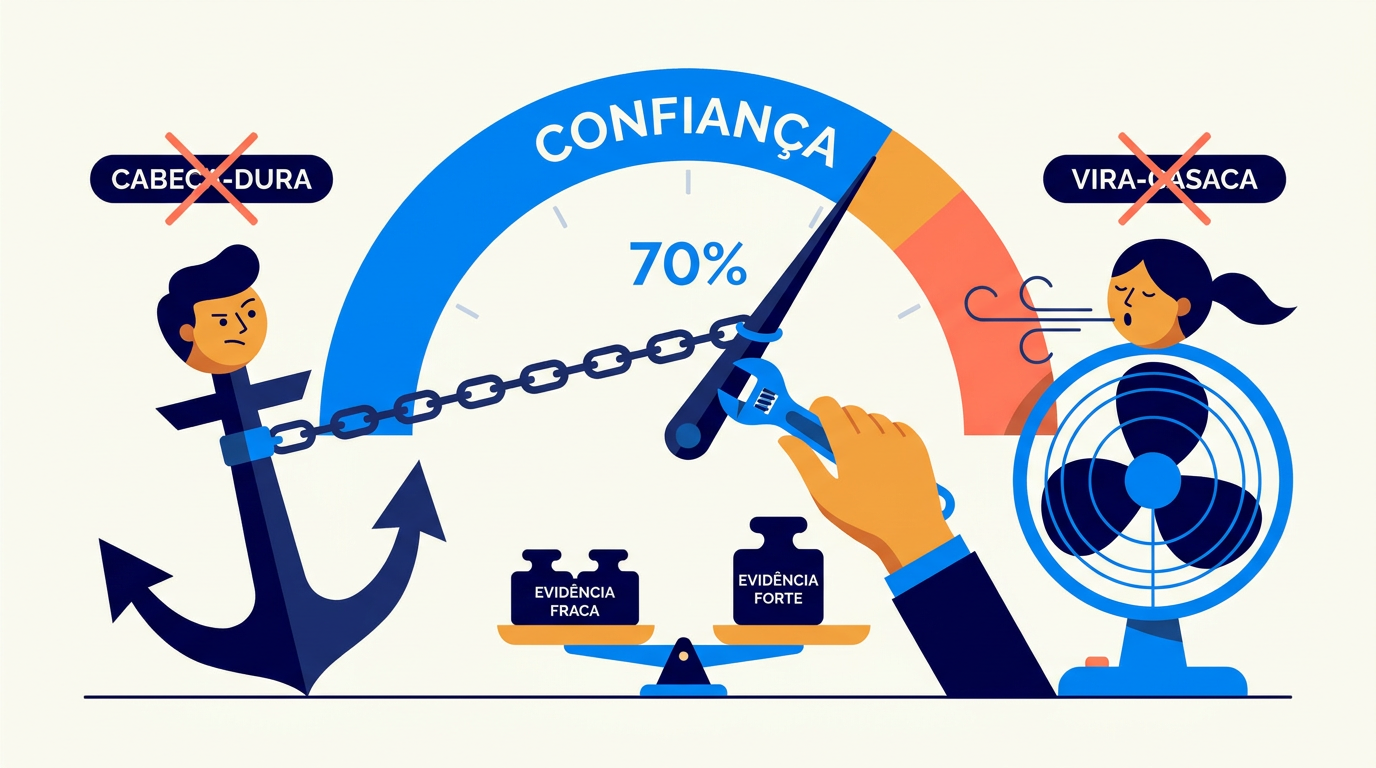
Se o combinado era 5% e deu 6%, o resultado é não significativo. Ponto. A tentação de flexibilizar a régua depois de ver o resultado é o viés de confirmação vestindo jaleco. A régua se define antes, como o critério de sucesso de uma ficha de experimento.
4. Quem procura em 20 lugares, acha em 1 por puro acaso.
Este é o mais traiçoeiro. Se você fatia o dashboard em 20 recortes (por loja, turno, dia, perfil…), espere que um deles pareça "significativo a 5%" por sorte pura: é o que 5% significa. O costume de fatiar até algo "dar positivo" tem nome (p-hacking) e é considerado má conduta científica. A defesa prática: recorte que apareceu na pescaria vira hipótese a confirmar com dados novos antes de virar manchete.
5. Significância não conserta amostra torta.
O teste pressupõe que as respostas são uma "colherada de sopa mexida". Se a coleta foi enviesada, o p-valor sai bonito e errado. Nenhuma matemática posterior conserta coleta ruim.
A comunidade estatística se preocupou tanto com esses maus usos que a American Statistical Association fez algo raríssimo em 2016: publicou um comunicado oficial sobre o que o p-valor é e não é, incluindo o alerta de que decisões não deveriam se apoiar apenas em "passou/não passou do 0,05".
Dragagem de dados vs. mineração de dados
Embora pareçam conceitos semelhantes (ambos buscam padrões em grandes volumes de dados), o objetivo e a metodologia são opostos:
- Data Mining (Mineração de Dados): É um processo exploratório legítimo. O objetivo é gerar novas perguntas, levantar hipóteses ou criar modelos preditivos que serão validados posteriormente em novos dados.
- Data Dredging (ou p-hacking, ou data fishing): É um processo conclusivo falho. O pesquisador tenta vender uma correlação puramente acidental como se fosse uma prova definitiva de causa e efeito, sem fazer uma validação independente. Ocorre quando se testa muitos dados sem uma hipótese fixa, e é considerado um erro grave na ciência e na estatística.
Como evitar a dragagem de dados
Para garantir que uma descoberta é real e não apenas uma coincidência estatística, existem três estratégias principais:
- Pré-registro do estudo. Definir a hipótese e o método estatístico antes de olhar os dados. Evita mudar o foco da pesquisa para "achar algo" após coletar as informações.
- Divisão dos dados (train/test split). Dividir os dados em duas partes independentes: usar a primeira para explorar e gerar teorias, e a segunda estritamente para testar e confirmar se a teoria se mantém.
- Correções estatísticas. Utilizar métodos matemáticos que ajustam o nível de significância (como a Correção de Bonferroni). Quanto mais testes se faz, mais rigoroso o cálculo se torna para aceitar um resultado como verdadeiro.
O kit prático para o dia a dia
Sem rodar teste nenhum, quatro hábitos capturam 90% do valor:
- Pergunte "n" antes de reagir. Quantas respostas sustentam cada número comparado?
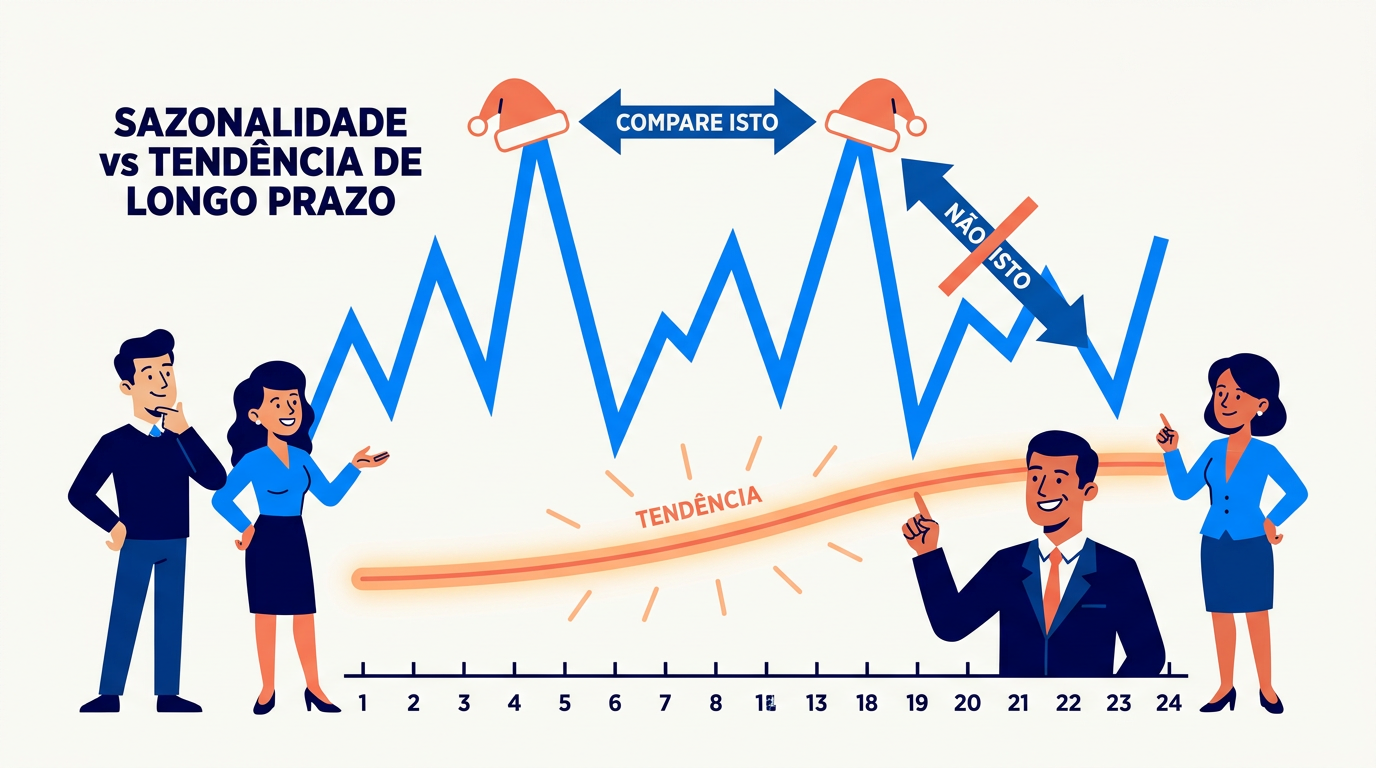
- Compare a diferença com o vaivém natural. Olhe a série histórica da própria loja: se ela oscila ±0,3 de mês em mês, uma diferença de 0,2 entre lojas é textura de moeda.
- Exija persistência. Acaso não tem memória; causa tem. Diferença real se repete: a loja A acima da B por seis meses seguidos é evidência forte mesmo sem teste formal; uma foto isolada não é evidência nem com teste.
- Nas decisões grandes, rode o teste de verdade. Testes A/B de fluxos, mudanças de processo em rede, comparações que movem investimento: aí a calculadora de significância entra (qualquer ferramenta padrão serve), com a régua definida antes: tamanho da amostra, critério e prazo.
Um quinto hábito vale para quem já vasculha dados livremente, especialmente com apoio de IA: é muito fácil chegar a conclusões irreais quando se cruza tudo com tudo. Busque sempre encontrar hipóteses a partir dos dados, não encontrar respostas prontas. As hipóteses podem depois ser testadas, validadas e confrontadas com dados novos.
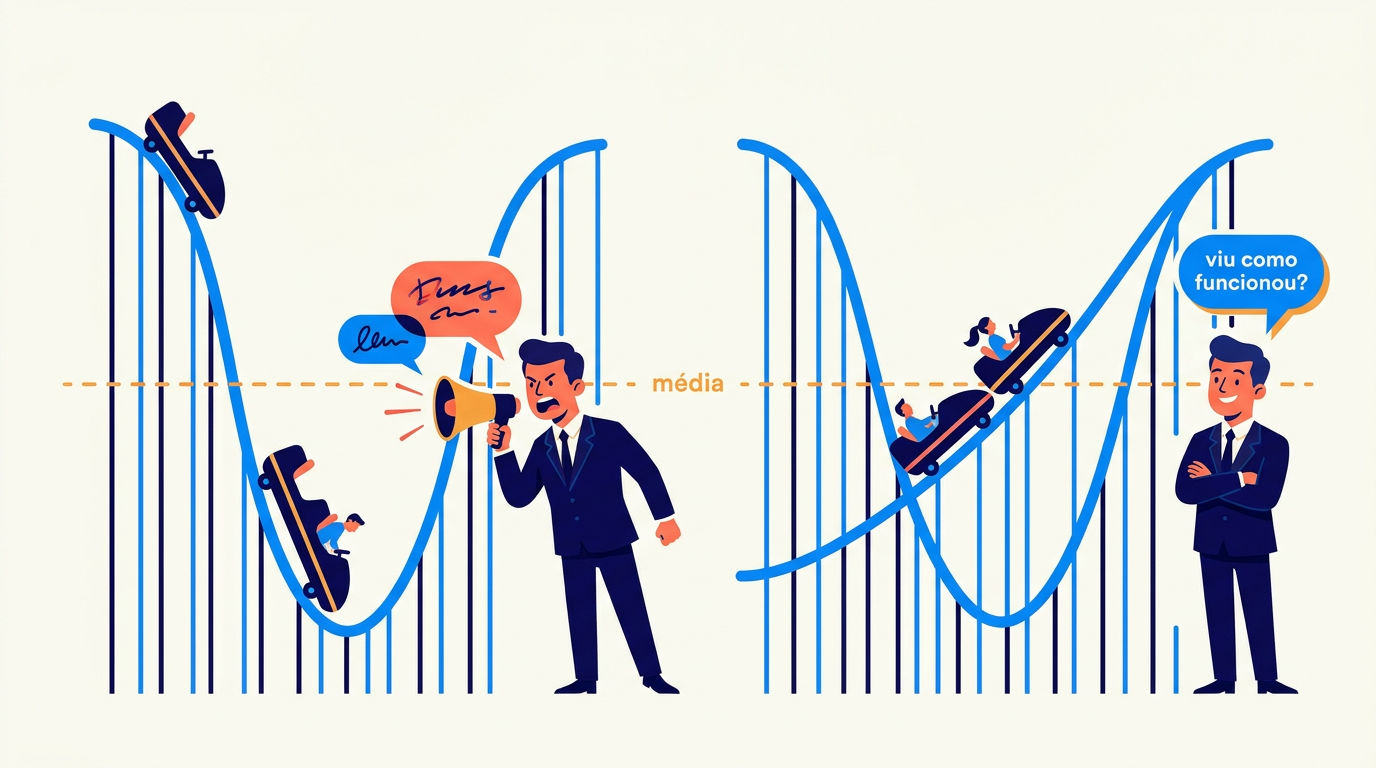
Os dois inimigos desses hábitos têm nome na literatura, e vale conhecê-los: o viés de ação (a compulsão de "fazer algo" diante de qualquer variação, porque esperar parece omissão, mesmo quando esperar é a decisão estatisticamente certa) e o viés de autoatribuição (melhorou: mérito meu; piorou: azar do mercado, o que transforma todo plano de choque em sucesso retroativo).
De volta ao Cambará
No Cambará, a reunião das 8h mudou de pauta: em vez de investigar a queda, investigou-se a régua. A faixa de flutuação normal do hotel, calculada e desenhada no dashboard como uma zona sombreada, passou a separar notícia de ruído: dentro da faixa, ninguém comemora nem convoca crise; fora dela, ou com padrão persistente por três meses, aciona-se a investigação de verdade.
Otávio assinou a mudança com autocrítica em voz alta: os dois e-mails dele tinham treinado a equipe a torcer pelo acaso. O terceiro e-mail corrigiu: "nota dentro da faixa é silêncio; fora dela, é trabalho. Elogio, de agora em diante, é pelo que vocês fizeram, não pelo que o dado oscilou".
O resumo de uma frase (teste Feynman)
"Antes de explicar uma diferença, pergunte se ela precisa de explicação: o acaso produz diferenças o tempo todo, e significância é só o teste de se essa aí é grande demais para ser obra dele."
Fontes e leituras recomendadas
WASSERSTEIN, Ronald L.; LAZAR, Nicole A. "The ASA Statement on p-Values: Context, Process, and Purpose". The American Statistician, v. 70, 2016.
GELMAN, Andrew; STERN, Hal. "The Difference Between ‘Significant’ and ‘Not Significant’ Is Not Itself Statistically Significant". The American Statistician, v. 60, 2006.
FISHER, Ronald A. Statistical Methods for Research Workers. Oliver & Boyd, 1925.
KOHAVI, Ron; TANG, Diane; XU, Ya. Trustworthy Online Controlled Experiments. Cambridge University Press, 2020.
WHEELAN, Charles. Estatística: O Que É, Para Que Serve, Como Funciona. Zahar, 2016.