Software vai a campo depois de testado. Questionário, que também é um instrumento de engenharia, costuma ir cru. Por isso o teste de questionário precisa ser etapa obrigatória, e não um luxo.
Na Vetor Sistemas
A ironia aconteceu justamente numa empresa de software. A pesquisa nova da Vetor Sistemas, de gestão B2B, foi direto para o ar numa sexta: prazo apertado, questionário revisado “de olho” por três pessoas experientes, “afinal, é só um formulário”. Três semanas depois, o estagiário, conferindo números para outro relatório, notou o buraco: a pergunta 4, sobre o novo painel de relatórios, não tinha uma única resposta de quem usava o painel. Nenhuma. Em 700 respostas.
A autópsia levou vinte minutos: um erro na lógica condicional pulava a pergunta 4 exatamente para os usuários do painel, o único público para quem ela importava. O questionário nunca travou, nunca deu erro na tela, coletou 700 respostas com fluidez… e três semanas de dado sobre a principal dúvida do trimestre simplesmente não existiam.
— A gente não sobe nem um hotfix sem passar no teste — disse Camila, mais para si mesma. — Formulário a gente publica na fé.
O bug que ninguém reporta
Quando um software tem defeito, o usuário reclama. Quando um questionário tem defeito, o respondente responde assim mesmo: entendendo outra coisa, marcando o degrau errado, inventando a opinião que não tem. O defeito não gera erro na tela; gera dado plausível e errado, que segue viagem até virar decisão.
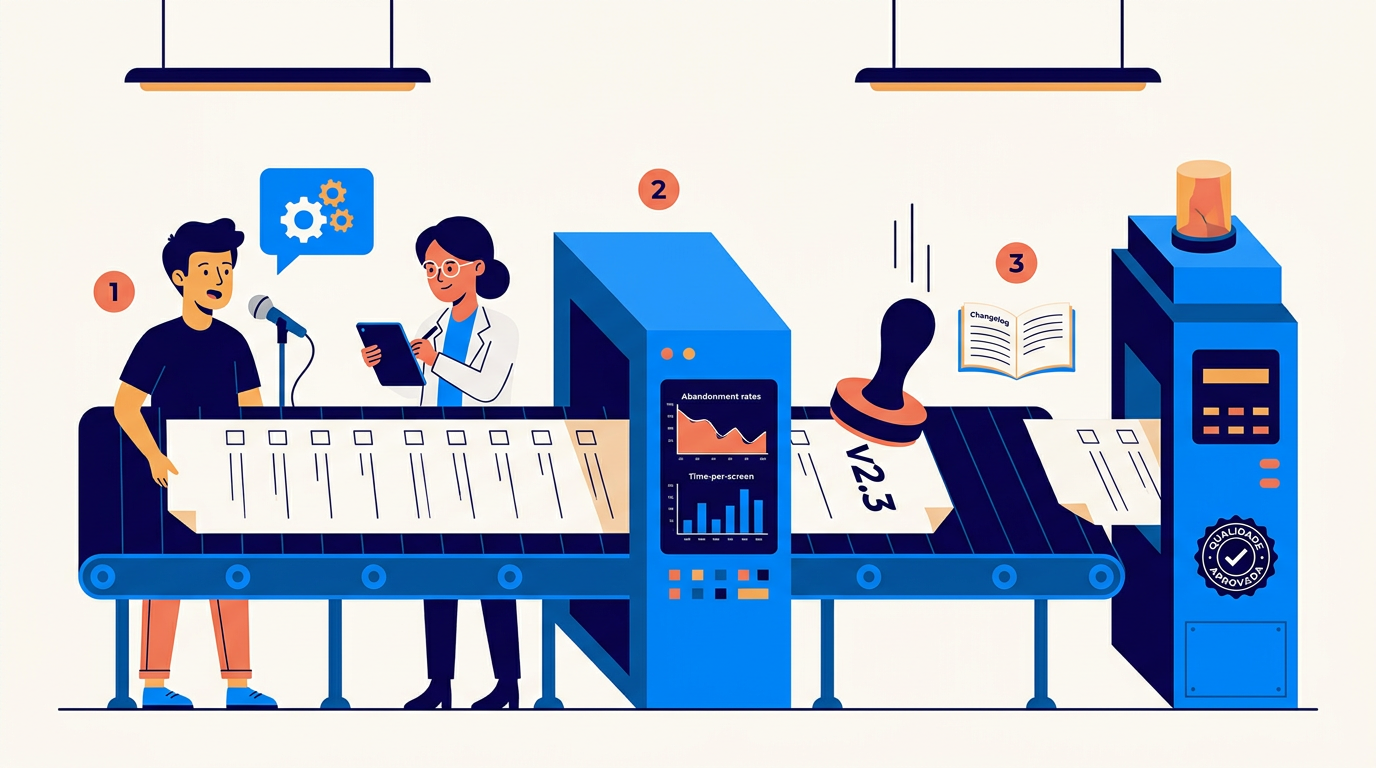
Por isso a metodologia de pesquisa desenvolveu seu próprio ciclo de testes. Ele tem três estágios, e cada um pega uma família diferente de defeitos.
Estágio 1: o pré-teste cognitivo (5 pessoas, 1 hora, os defeitos graves)
A técnica: sentar com alguém do perfil do respondente e pedir que responda o questionário pensando em voz alta: o que entendeu da pergunta, como escolheu a resposta, o que hesitou. O nome formal é entrevista cognitiva (artigo Anatomia de uma boa pergunta a apresentou; aqui está o método completo). Duas variantes se complementam:
- Think-aloud: o respondente narra o raciocínio livremente, sem interferência.
- Probing: o aplicador sonda pontos específicos depois de cada resposta: “o que significa ‘atendimento’ pra você nessa pergunta?”, “por que 4 e não 5?”, “reformule essa pergunta com suas palavras”.
O que esse estágio revela (e nada mais revela tão barato):
- Interpretações divergentes: você perguntou sobre a loja, ele respondeu sobre a marca.
- Vocabulário de empresa que o cliente não usa (artigo O questionário como conversa, regra 5).
- Degraus de escala entendidos de formas diferentes (o “neutro” que uns leem como “tanto faz” e outros como “não sei”; artigo Escala Likert).
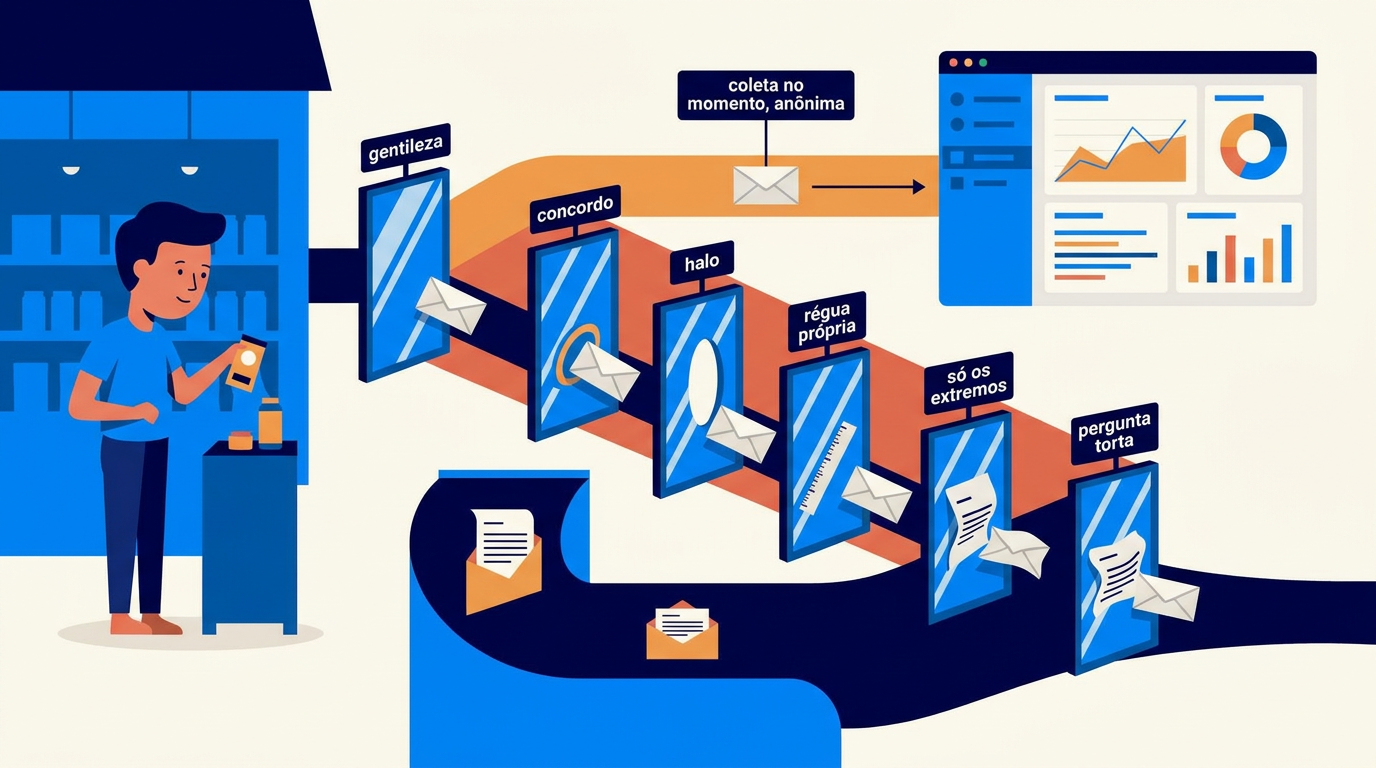
- A pergunta que constrange, que o respondente responde com a nota-gentileza (artigo Vieses do respondente).
A literatura da área converge num ponto contraintuitivo: cinco a dez entrevistas cognitivas encontram a grande maioria dos problemas graves. É o melhor retorno por hora investida de toda a pesquisa.
Estágio 2: o piloto quantitativo (soft launch, os defeitos de comportamento)
O questionário revisado vai a campo em escala reduzida (uma loja, uma semana, uma fração do tráfego) antes do lançamento geral. Aqui não se conversa com o respondente; observa-se o comportamento agregado das respostas, procurando sintomas:
- Funil de abandono: em que tela os respondentes desistem? Uma queda concentrada aponta a pergunta cara demais (artigo O cardápio de perguntas) ou o momento em que a fadiga vence (artigo O questionário como conversa).
- Tempo por tela: pergunta que leva o triplo do esperado está confusa; que leva menos de um segundo está sendo respondida sem leitura.
- Distribuições estranhas: 98% de nota máxima pode ser excelência, ou escala desequilibrada, halo e desejabilidade social somados (artigos Anatomia de uma boa pergunta e Vieses do respondente). Tudo empilhado num degrau merece investigação, não comemoração.
- Picos em números redondos: Darrell Huff, em Como Mentir com Estatística (1954), nota que censos encontravam mais pessoas com 35 anos do que com 34 ou 36: quem informava a idade dos outros arredondava para o múltiplo de cinco mais familiar. Tempos de espera, gastos e frequências declaradas fazem o mesmo. Quando o dado existe no sistema, não pergunte (artigo O questionário como conversa, regra 1); quando precisar perguntar, peça o fato (a data de nascimento), não a estimativa (a idade).
- Taxa de “não sei” e de pulo: alta demais = pergunta irrelevante para o público; zero = talvez falte a saída honesta.
- Straightlining: blocos de respostas idênticas em sequência denunciam fluxo longo ou monótono.
- Ramos mortos: com lógica condicional (artigo O questionário como conversa), todo caminho precisa ser percorrido por gente de verdade no piloto; o ramo que ninguém alcançou é um bug silencioso de configuração.
Regra de bolso: algumas centenas de respostas bastam para o piloto revelar esses sintomas; o objetivo é diagnosticar o instrumento, e para isso não é preciso a precisão estatística fina de uma medição de satisfação.
Estágio 3: a iteração disciplinada (o instrumento vivo, a série protegida)
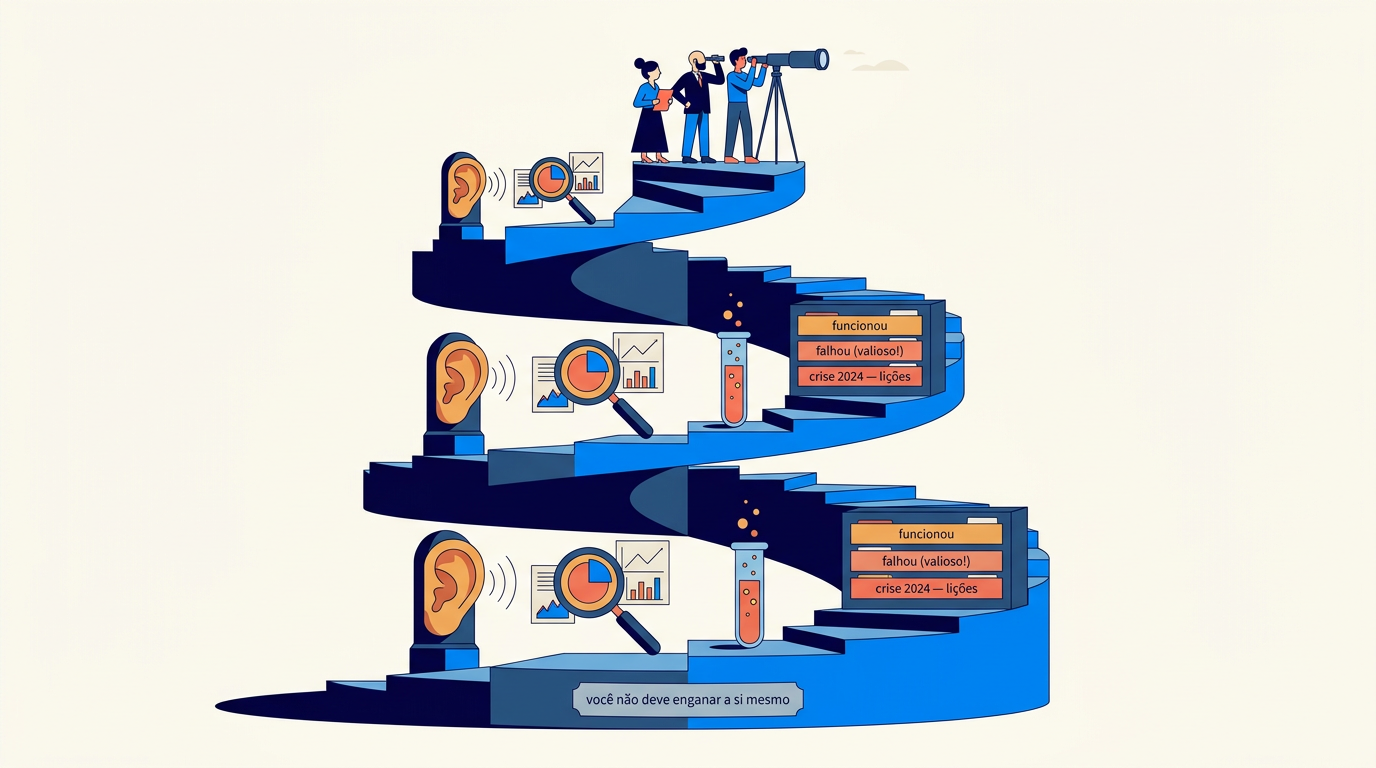
Questionário não é obra concluída: decisões mudam (artigo O questionário como conversa, design reverso), temas novos emergem dos comentários (artigo Quali e quanti) e perguntas envelhecem. A iteração é saudável, desde que disciplinada, porque cada mudança ameaça o bem mais valioso de um programa contínuo: a série histórica.
As três regras da casa:
- Toda mudança tem registro: o quê, quando, por quê. Um changelog de questionário (uma linha por versão) custa nada e vale ouro na hora de explicar por que a nota “mudou” em março (o que mudou foi a régua, e não a satisfação; artigo Escala Likert, pecado 3).
- Mudanças em lote, não em conta-gotas: melhor uma revisão trimestral bem testada que microajustes semanais que picotam a série.
- O núcleo é intocável: a pergunta-âncora (a avaliação central que sustenta a série histórica e as metas; artigo Metas de satisfação bem desenhadas) só muda com justificativa forte e decisão consciente de recomeçar a série. A periferia pode iterar; a âncora precisa ficar estável.
E quando houver dúvida real entre duas formulações? Teste A/B de questionário: metade do tráfego vê cada versão, por tempo suficiente (artigos Experimentos internos e Diferença real ou ruído?), e a evidência decide, em vez da opinião mais graduada da sala.
O ciclo completo do teste de questionário, em uma linha
Redigir (artigos Anatomia de uma boa pergunta, O cardápio de perguntas e O questionário como conversa) → pré-teste cognitivo (5 a 10 pessoas) → revisar → piloto (1 loja, 1 semana) → revisar → lançar → monitorar sintomas → iterar com registro.
Quem pula os passos do meio não economiza o teste: só o transfere para produção, onde ele custa decisões erradas em vez de horas de trabalho.
De volta à Vetor
Na Vetor, questionário virou software oficialmente, com direito a pipeline: nenhuma pesquisa vai ao ar sem os dois estágios. Primeiro o pré-teste cognitivo: cinco clientes respondendo em voz alta, em chamada, na frente de alguém da equipe, que é onde a pergunta ambígua e o caminho quebrado aparecem por centavos. Depois o piloto: uma semana numa carteira pequena, lendo sintomas (abandono por pergunta, respostas em linha reta, ramos sem tráfego) antes de abrir para a base inteira.
E cada mudança entra no changelog com data, para a série histórica nunca ser comparada por cima de uma emenda invisível. As três semanas perdidas viraram o exemplo do treinamento, com a moral da Camila: “defeito de pergunta não trava a tela; trava a verdade. E a verdade não abre chamado”.
O resumo de uma frase (teste Feynman)
“Questionário se testa como software: primeiro assistindo cinco pessoas usarem, depois soltando para poucos e lendo os sintomas; porque defeito de pergunta não trava a tela, trava a verdade.”
Fontes e leituras recomendadas
- WILLIS, Gordon B. Cognitive Interviewing: A Tool for Improving Questionnaire Design. Sage, 2005. (O manual de referência do pré-teste cognitivo.)
- PRESSER, Stanley et al. (org.). Methods for Testing and Evaluating Survey Questionnaires. Wiley, 2004. (O panorama completo das técnicas de teste.)
- CONVERSE, Jean M.; PRESSER, Stanley. Survey Questions: Handcrafting the Standardized Questionnaire. Sage, 1986. (O clássico curto sobre lapidação de perguntas.)
- GROVES, Robert M. et al. Survey Methodology. 2ª ed. Wiley, 2009. (Capítulos sobre pré-teste e piloto dentro do processo completo.)
- KROSNICK, Jon A. “Survey Research”. Annual Review of Psychology, v. 50, 1999. (Sintomas de satisficing detectáveis em piloto.)
- HUFF, Darrell. Como Mentir com Estatística. Intrínseca, 2016 (original de 1954). (Capítulo 9: o arredondamento de idades no censo e a pergunta pelo fato em vez da estimativa.)