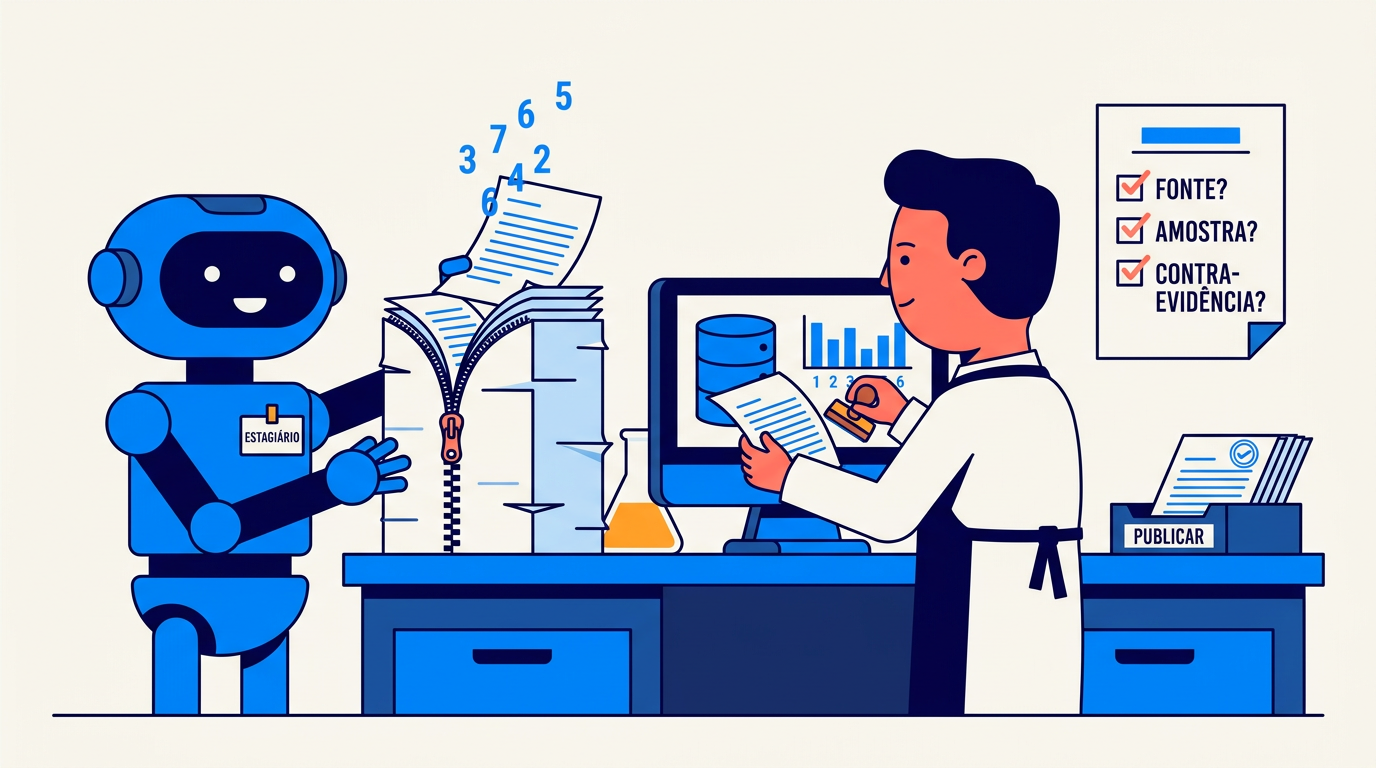
A IA na análise de dados lê mil comentários em um minuto, e erra com a mesma fluência com que acerta. O método científico é o cinto de segurança. Na Vetor Sistemas O estagiário da Vetor Sistemas, empresa de software de gestão B2B, entregou em dez minutos o que costumava tomar uma tarde: os 600 comentários e tickets do trimestre resumidos pela IA em cinco temas, com porcentagens e até sugestões de ação. O texto era claro, confiante, bem escrito. Camila, a diretora de customer success, foi lendo e elogiando por dentro, até tropeçar no terceiro tema: "reclamações recorrentes de lentidão no módulo financeiro". Ela conhecia o produto. O módulo financeiro tinha sido descontinuado no ano anterior; os comentários que ela abriu para conferir falavam de outra coisa: lentidão no módulo fiscal, dois casos antigos de antes da migração, e três que nem eram de cliente da Vetor, e sim de uma integração de terceiros. A ferramenta tinha costurado retalhos verdadeiros numa afirmação falsa, com a fluência de quem jura que viu. — Ele escreve melhor que eu — admitiu o estagiário. — Escreve — disse Camila. — E erra com a mesma elegância. IA na análise de dados: a ferramenta que já está na bancada Classificar 5.000 comentários abertos em categorias já foi trabalho de uma semana (análise de conteúdo, no sentido clássico). Um modelo de linguagem faz uma primeira versão em minutos, e ainda resume, traduz, detecta sentimento e rascunha o relatório. Esse tipo de automação já deixou de ser experimento de bancada: sistemas de coleta de satisfação, incluindo o da Solvis, já usam IA para classificar comentários e disparar alertas em produção, para clientes reais. Isso torna ainda mais importante saber supervisionar bem essa ferramenta — seja para quem analisa dados no dia a dia, seja para quem constrói ou compra um produto com IA embutida. Seria tolice não usar. E seria tolice usar sem entender como essa ferramenta erra, porque ela erra de um jeito novo, para o qual os instintos de ninguém foram treinados. Máquinas antigas falhavam com cara de falha: tela azul, erro 404. A IA generativa falha com cara de acerto: texto fluente, confiante, bem formatado, mas ocasionalmente falso. A literatura técnica chama isso de alucinação: o modelo gera conteúdo plausível sem lastro nos dados. Vale saber por que isso acontece, porque explica por que a próxima versão não resolve. Em 2025, pesquisadores da própria OpenAI publicaram o diagnóstico (Kalai et al.): o modelo aprende prevendo a próxima palavra, e fatos raros (uma data, um número, o nome de um módulo) não têm padrão suficiente para serem previstos, só chutados; e as provas com que a indústria avalia os modelos dão ponto pela resposta certa e zero pelo "não sei", de modo que chutar com confiança rende mais nota do que admitir dúvida. O estagiário que nunca diz "não sei" foi criado por uma prova que premia o chute. Os modelos melhoram a cada ano e alucinam menos. Mas nenhum deixou de alucinar. Daí a imagem do título: um estagiário brilhante e incansável, que nunca diz "não sei". Você o contrataria? Claro. Você assinaria o relatório dele sem revisar? Nunca. Onde a IA brilha na análise de dados 1. Codificação de comentários em escala. A primeira passada de categorização, trabalho que era o gargalo da análise qualitativa, vira minutos. É um dos usos mais valiosos dessa tecnologia — inclusive já roda em produção em sistemas como o da Solvis, fazendo a primeira classificação de cada comentário e disparando o alerta correspondente. 2. Radar do inesperado, turbinado. "Liste temas recorrentes nestes comentários que NÃO se encaixam nas categorias existentes". A IA é boa em farejar o padrão novo que nenhuma pergunta fechada previu. 3. Tradução entre públicos. Do relatório técnico para o resumo executivo de 5 linhas; da análise para o rascunho de data storytelling. Rascunho: a palavra importa. 4. Parceiro de método. Talvez o uso mais subestimado: pedir à IA que banque o advogado do diabo. "Aqui está minha conclusão e meus dados: que explicações alternativas eu não considerei?". Ela é rápida em gerar hipóteses rivais, exatamente o exercício que o viés de confirmação faz qualquer um pular. Onde ela derrapa (e como cada derrapada se conserta) Derrapada 1: a alucinação. Números que não estão na base, citações de clientes que ninguém escreveu, porcentagens inventadas com três casas decimais de confiança.Conserto: regra da rastreabilidade: toda afirmação quantitativa que a IA produzir se confere na fonte antes de publicar. Verbatim citado em relatório? Busque-o na base, literal. Se não está lá, não existe. Derrapada 2: a classificação enviesada. O modelo aprendeu padrões do mundo, inclusive os tortos. Pode ler ironia como elogio ("adorei esperar 40 minutos, maravilhoso"), penalizar regionalismos e gírias, oscilar com o formato do texto. E oscila até consigo mesmo: um dos primeiros testes sérios do modelo como codificador (Reiss, 2023) mostrou que o mesmo texto, enviado duas vezes, pode voltar com categorias diferentes, e que trocar uma palavra na instrução muda o resultado.Conserto: auditoria por amostragem, exatamente como a análise de conteúdo clássica sempre exigiu (Krippendorff): tire uma amostra aleatória das classificações (não as 10 primeiras; aleatória), revise no braço, meça a taxa de concordância humano-máquina. Boa o suficiente, siga com auditorias periódicas; ruim, recalibre as instruções e repita. Classificador que ninguém audita é caixa-preta fabricando confiança, e agora em escala industrial. O mesmo padrão vale para qualquer classificador entregue a um cliente, com uma exigência a mais: a taxa de concordância deveria ser medida como qualidade do produto, acompanhada como qualquer outra métrica e, sempre que possível, visível no painel. Derrapada 3: a resposta que muda com a pergunta. A mesma base, perguntada de dois jeitos, rende conclusões diferentes: o efeito de pergunta induzida aplicado à máquina, que é ainda mais complacente do que um cliente educado. "Mostre como o atendimento melhorou" produz um relatório; "o que os dados dizem sobre o atendimento?" produz outro. O conserto é perguntar como cientista e não como torcedor, pedindo sempre o contra:
A ética de quem pergunta: privacidade, honestidade e responsabilidade com dados
O cliente confiou a opinião dele a quem pergunta. E agora? É aqui que entra a ética de dados. Na Clínica Aurora Foi um dia de dois pedidos na Clínica Aurora, rede de clínicas médicas. De manhã, o coordenador da unidade em reforma mandou mensagem para Wagner, o administrador: "as notas desta semana despencaram por causa da obra; dá pra apagar essas respostas? Não é justo contar". À tarde, um parceiro comercial pediu "a lista de telefones dos pacientes que avaliaram bem", para oferecer um plano odontológico. Os dois pedidos eram razoáveis à primeira vista. Os dois vinham de gente boa, querendo o melhor para a casa. E aqui o dado tinha um peso a mais: era dado de paciente. Wagner levou os dois para a Dra. Beatriz, a sócia fundadora, na mesma conversa: — Um quer apagar dado que dói. O outro quer usar dado que não foi emprestado para isso. Eu nego os dois? O ativo invisível Toda vez que alguém toca uma carinha num totem, acontece uma pequena transação de confiança: o cliente entrega uma opinião (às vezes um desabafo, às vezes dados pessoais), apostando que será feito bom uso dela. Confiança é o ativo invisível de qualquer negócio que vive de perguntar. Invisível e assimétrico: leva anos para construir e pode ser perdida num único episódio. Uma série sobre pensar cientificamente precisa terminar aqui, porque rigor sem ética é só eficiência a serviço de qualquer coisa. Este artigo cobre os dois compromissos de quem vive de perguntar: cuidar do dado (a parte da lei) e não mentir com ele (a parte que nenhuma lei fiscaliza). Ética de dados, parte 1: a LGPD traduzida para o dia a dia A Lei Geral de Proteção de Dados (Lei nº 13.709/2018) regula o tratamento de dados pessoais no Brasil desde 2020, sob fiscalização da ANPD (Autoridade Nacional de Proteção de Dados). Mais do que um manual de proibições, ela é um princípio central com desdobramentos: o dado pessoal pertence ao titular; quem coleta é guardião temporário, com finalidade definida. O vocabulário mínimo que qualquer equipe que lida com dados de pesquisa deveria dominar: Dado pessoal é qualquer informação que identifique ou possa identificar uma pessoa: nome, e-mail, CPF, telefone, mas também combinações que identifiquem indiretamente. E os dados pessoais sensíveis são aqueles que, quando revelados, podem gerar algum tipo de discriminação, como raça, religião, orientação sexual ou política. Dado anonimizado, aquele que perdeu de forma irreversível o vínculo com a pessoa, está fora do alcance da lei. A nota "4 estrelas às 14h32" solta não identifica ninguém; associada ao CPF do programa de fidelidade, é dado pessoal e exige todo o cuidado da lei. Finalidade: dado coletado para um propósito informado só pode ser usado para aquele propósito. O e-mail coletado "para enviarmos a resolução do seu problema" não pode virar lista de marketing, a menos que isso tenha sido informado e consentido. Minimização: coletar apenas o necessário. Cada campo a mais num questionário não é só atrito de resposta; é passivo jurídico e ético. "Pode ser útil um dia" não é finalidade. Direitos do titular: a pessoa pode saber o que existe sobre ela, corrigir, e pedir eliminação do que foi coletado com base em consentimento. Se um respondente aciona esses direitos, precisa existir processo: a resposta certa do atendimento é acionar o responsável interno, nunca improvisar. Segurança e incidentes: vazamento de dados pessoais é incidente com obrigações legais de comunicação à ANPD e aos titulares em prazos definidos. A regra de ouro preventiva: dado pessoal não passeia: não vai em planilha por e-mail, não vai em print de WhatsApp, não vai em slide de apresentação com nome de cliente visível. Há uma camada extra para quem, como fornecedor de pesquisa, processa dados dos clientes de outra empresa. Na linguagem da lei, esse fornecedor costuma ser operador, processando dados sob instruções do controlador (o cliente contratante). Cada descuido nessa cadeia compromete a confiança de duas relações ao mesmo tempo. Parte 2: A honestidade com resultados (a parte que a lei não cobre) Nenhum artigo da LGPD proíbe "maquiar" um resultado de pesquisa. Essa parte é uma questão de ofício. Não caçar nota. Pressionar o cliente por um 10, escolher o momento da pergunta para inflar o placar, dificultar a resposta negativa: tudo isso produz um número bonito que mede a maquiagem, não a experiência. É a Lei de Goodhart operando pela via da tentação. Quem engana a métrica engana o gestor que decide por ela, e no limite engana a si mesmo (Feynman, sempre: você é a pessoa mais fácil de enganar). Não esconder o recorte inconveniente. Apresentar o trimestre bom e omitir o mês ruim, mostrar a média e esconder a distribuição, citar "os dados" sem mostrar a amostra: cada uma dessas escolhas é uma pequena fraude estatística socialmente aceita. O padrão saudável é outro: o dado que enfraquece a história vai junto. Não afirmar além do que o dado sustenta. "O NPS subiu" quando a variação está dentro da margem de erro; "a campanha causou o aumento" quando há só correlação. O vocabulário honesto existe e não é fraqueza: "os dados sugerem", "ainda não dá para separar do efeito da promoção", "a amostra é pequena para afirmar". Precisão sobre incerteza é sinal de sofisticação. Resultado ruim se entrega com o mesmo capricho do bom. Se um cliente tem um NPS em queda, o relatório não deveria suavizar: precisa contextualizar, diagnosticar e apontar caminho. Quem pesquisa é contratado para dizer a verdade útil, não a verdade agradável. É exatamente por isso que a palavra de quem entrega o resultado vale alguma coisa. Essa postura tem tradição: os códigos de ética das associações internacionais de pesquisa (como o Código ICC/ESOMAR, adotado em dezenas de países) estabelecem há décadas os mesmos pilares: voluntariedade do respondente, transparência de propósito, proteção do dado e obrigação de não distorcer ou deturpar resultados. São princípios de um ofício centenário — quem os segue está apenas se filiando a uma tradição bem estabelecida.