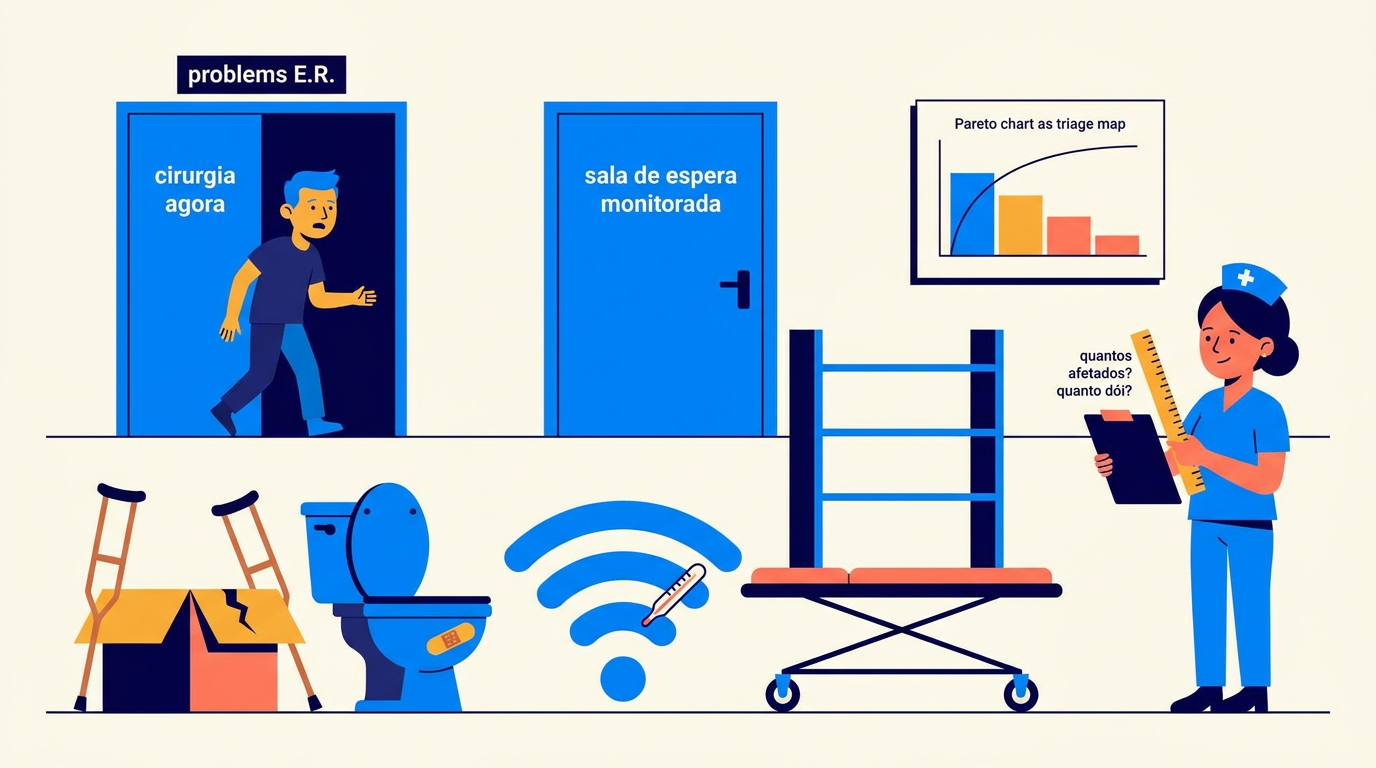
A lista de problemas sempre será maior que o orçamento. Priorizar é a decisão de gestão mais frequente que a pesquisa alimenta. Veja como fazer a priorização de melhorias sem virar um leilão de vieses. No Hotel Cambará Depois do semestre mais ouvido da história do Hotel Cambará, a parede da sala de reuniões virou um mural de post-its: quarenta melhorias apontadas pelos dados, uma ao lado da outra. Colchões do anexo, wi-fi do terceiro andar, fila do check-in, café da manhã que acaba cedo, estacionamento: quarenta soldados enfileirados. O efeito foi o contrário do pretendido. Nas três reuniões seguintes, a parede paralisou o hotel: tudo parecia urgente, começar por qualquer um parecia injusto com os outros trinta e nove, e a discussão recomeçava do zero a cada encontro. Otávio, o gerente-geral, resumiu o estado das coisas: — A gente descobriu quarenta problemas e criou o quadragésimo primeiro: essa parede. Ninguém sai daqui hoje até ela virar uma fila. O luxo de ter problemas demais Um programa de escuta funcionando produz um efeito colateral previsível: uma fila de problemas conhecidos maior que a capacidade de resolver. Fila no caixa, banheiro, estacionamento, ruptura de estoque, wi-fi, temperatura, um atendente específico… Qual primeiro? Sem método, a fila é furada pelos critérios de sempre: o problema mais recente (viés de recência), o mais dramático (disponibilidade), o do cliente que gritou mais alto (a amostra de um), ou o favorito do diretor (efeito halo hierárquico; no jargão de produto, o HiPPO, highest paid person’s opinion: a opinião de quem ganha mais decide). Este artigo organiza os métodos que substituem esse leilão de vieses. Ferramenta 1: o princípio de Pareto (a triagem) A observação empírica mais rentável da gestão de qualidade: os problemas não se distribuem uniformemente: poucas causas concentram a maioria das ocorrências. Joseph Juran, um dos pais do movimento da qualidade, batizou o padrão de princípio de Pareto (os “poucos vitais contra os muitos triviais”) e o transformou em ferramenta: ordene as categorias de problema por frequência e olhe a concentração. Tipicamente, 2 ou 3 categorias respondem por 60–80% das ocorrências. Na prática: as categorias dos comentários e das perguntas-diagnóstico (artigos As cinco dimensões da qualidade de serviço, Banco de 50 perguntas de satisfação e Quali e quanti) empilhadas num gráfico de barras ordenado. Trinta segundos de leitura e a fila de dez problemas vira uma triagem: os 2–3 vitais, e o resto. Duas ressalvas de série: confira se a concentração não é artefato de categoria larga demais (“atendimento” engole tudo; abra em subcategorias antes de concluir), e lembre que frequência de menção depende de quem responde (artigos Amostra e Quali e quanti). Ferramenta 2: frequência × impacto (a matriz que corrige o Pareto) Pareto ordena por volume, mas nem toda ocorrência pesa igual. A ruptura de estoque pode ser menos citada que a fila e ainda assim derrubar mais nota por ocorrência. A correção é cruzar dois eixos: O cruzamento gera a matriz com quatro cantos que se explicam sozinhos: frequente e grave (prioridade absoluta), raro e grave (previna e prepare a recuperação; artigo O ciclo fechado), frequente e leve (irritantes de escala: baratos de consertar costumam pagar bem), raro e leve (fila de espera). O refinamento fino vem do modelo Kano (spoiler do artigo Pesquisa e inovação): consertar básicos quebrados vale mais que polir encantamentos: a ausência de básico destrói mais nota do que o encanto constrói. Ferramenta 3: o ICE (o desempate executável) Impacto sozinho ignora o custo de agir. Para ordenar a fila final, o desempate prático (apresentado em Experimentos internos): ICE: Impacto (quanto move a experiência/o dinheiro; artigo O caso financeiro da satisfação), Confiança (que evidência sustenta a estimativa? A escada do artigo Achismo, opinião e evidência vira nota) e Esforço (custo, tempo, complexidade). Ranqueie, ataque do topo, e trate as notas como hipóteses: o piloto pequeno (artigo Experimentos internos) antes do rollout é o teste da nota de confiança. O fluxo completo da priorização de melhorias Repare no que o fluxo institucionaliza: a passagem do dado à decisão sem passar pelo leilão de vieses: cada etapa tem critério explícito que qualquer pessoa da equipe pode auditar (artigo A ética de quem pergunta: transparência) e desafiar (artigo Achismo, opinião e evidência: pelo degrau da evidência em vez do cargo). As quatro armadilhas da priorização Consertar o que é fácil em vez do que importa. O ICE mal usado degenera nisso: esforço baixo dominando a conta. Antídoto: impacto e esforço em colunas separadas e visíveis; “rápido e inútil” não pode se disfarçar de prioridade. Priorizar pela última reunião. A fila que muda a cada semana não é fila, é humor. A fila se revisa no rito mensal (artigo Rituais de gestão), com dado novo, e não a cada comentário forte (artigo Coincidências acontecem: rajada abre uma pergunta, sem valer como veredito). Atacar a fila inteira de uma vez. A lição central de As 4 Disciplinas da Execução (McChesney, Covey e Huling): o inimigo da execução não é a falta de plano, é o “vendaval”, o dia a dia operacional que consome toda a energia da equipe e devora as iniciativas de melhoria uma a uma. A fila mais bem ranqueada do mundo morre se virar oito frentes simultâneas: quem está imerso na operação executa uma ou duas melhorias por vez, com começo, meio e verificação, antes de puxar a próxima. Priorizar não é só ordenar a fila; é ter a disciplina de deixar o resto dela esperando. Esquecer o problema raro e catastrófico. Pareto é cego para o que quase não acontece mas destrói (a intoxicação, o vazamento, o episódio viral). Esses não disputam a fila de frequência: têm fila própria, de prevenção e preparo, assunto do artigo Gestão de crise guiada por pesquisa. De volta ao Cambará No Cambará, a parede virou fila em uma tarde, com três ferramentas em sequência. O Pareto triou: seis post-its concentravam 70% das reclamações. A matriz de frequência e impacto separou, desses seis, o que doía muito do que só acontecia
Experimentos internos: como testar ideias antes de apostar alto
Antes de discutir por 3 reuniões, teste por 3 dias: é a lógica dos experimentos internos. Na Academia Ritmo A pauta “volume da música” chegou à terceira reunião consecutiva na Academia Ritmo, rede de academias com três unidades, com as mesmas duas torcidas e nenhum dado novo. Fábio, o dono, sustentava que música alta é energia: “aluno treina mais, fica mais”. Renata, a gerente, sustentava que o volume espantava o pessoal da manhã e os alunos de mais idade: “e aluno que não gosta não reclama; some”. A ata da reunião anterior podia ser lida em voz alta: era idêntica ao debate em curso. No minuto quarenta, Renata desistiu de vencer e fez a proposta que encerrou o loop: — A gente já gastou três reuniões de opinião. Isso custa mais caro que o teste. Duas unidades com volume menor de manhã, uma como está, duas semanas. A realidade desempata, e ela não cobra hora. A reunião em loop Toda empresa conhece a cena: uma ideia divide o time. Metade acha que vai funcionar, metade acha que não. Argumentos de um lado, argumentos do outro. A reunião acaba sem decisão. Duas semanas depois, a mesma discussão, com os mesmos argumentos, porque nenhuma informação nova entrou na sala. O empate entre opiniões não se resolve com mais opinião. Se resolve com dado novo. E a forma mais barata de fabricar dado novo tem nome: experimento. A proposta deste artigo é mostrar como aplicar, no dia a dia de qualquer equipe, o mesmo método científico que sustenta uma boa pesquisa de satisfação: testar antes de apostar alto. A regra de ouro dos experimentos internos: aposte pequeno A lógica do experimento interno é economia pura: qual é o jeito mais barato e rápido de descobrir se essa ideia funciona? Essa filosofia tem lastro: é o núcleo do movimento Lean Startup, de Eric Ries (construir o teste mínimo, medir, aprender, e só então escalar), e é prática consolidada nas empresas de tecnologia mais estudadas do mundo. O motivo é um dado humilhante e libertador que essas empresas divulgam: a maioria das ideias testadas falha em produzir o efeito esperado. Ron Kohavi, que liderou experimentação na Microsoft, relata que só cerca de um terço das ideias testadas por lá melhorava de fato as métricas que pretendia melhorar; um terço não fazia diferença e um terço piorava. E eram ideias propostas por especialistas. Se especialistas erram dois terços dos palpites, a conclusão não é “não tenha ideias”; é “não aposte alto em palpite não testado”. A ficha de experimento: 5 campos antes de começar Um experimento se diferencia de “vamos tentar e ver no que dá” por um detalhe: as regras são definidas antes. Sem isso, o viés de confirmação redige a conclusão depois: qualquer resultado vira “deu certo”. A ficha mínima: Cinco campos, meia página. O custo de preenchê-la é 20 minutos; o custo de não preenchê-la é descobrir em produção, seis meses depois, que a aposta era ruim. Ou, tão ruim quanto: nunca descobrir. As armadilhas de quem começa Testar tudo ao mesmo tempo. Mudou o preço, o texto e o público na mesma semana? Se melhorar, foi o quê? Uma variável por experimento, ou aceite que só saberá o efeito do pacote. Escolher a métrica depois. Com liberdade para escolher a métrica após o resultado, alguma sempre terá subido. É a versão corporativa do atirador que desenha o alvo em volta do tiro. Encerrar quando está ganhando. Definiu duas semanas? São duas semanas. Parar no dia em que o número está bonito é colher ruído, não sinal (lembre-se da margem de erro: números pequenos balançam). Ignorar o contexto. O teste rodou na semana de promoção? Na baixa temporada? Anote junto ao resultado. Experimento interno raramente tem a pureza de laboratório; honestidade sobre as condições vale mais que fingir rigor. Confundir “falhou” com “fracassou”. A hipótese derrubada por um teste de 3 dias e R$ 0 é um dos produtos mais valiosos que existem: uma aposta ruim cancelada pelo preço de um palpite. No placar científico, “aprendemos que não” é vitória. Como isso conversa com a priorização de iniciativas Isso conversa direto com frameworks de priorização de iniciativas como o ICE score (impacto, confiança e esforço, popularizado por Sean Ellis): o experimento é o que alimenta o “C” de confiança. Uma iniciativa com hipótese testada em pequena escala sobe de confiança com dado em vez de retórica. O ciclo ideal: ideia → ficha de iniciativa → experimento pequeno → resultado → decisão de escalar (ou arquivar), com o aprendizado registrado para o time inteiro, inclusive quando a resposta é “não”. De volta à Ritmo Na Ritmo, a ficha de experimento saiu preenchida antes do café esfriar: hipótese (volume menor de manhã aumenta frequência e nota do turno), unidades pareadas, duas semanas, critérios combinados de antemão. Catorze dias depois, a realidade votou: a tarde não mudou nada, e a manhã surpreendeu: check-ins 9% maiores nas unidades de volume reduzido, com comentários novos do tipo “finalmente dá para conversar com o professor”. Fábio aceitou a derrota com a elegância de quem perdeu para o método, não para a Renata. A regra ficou na parede da sala: “terceira reunião sobre o mesmo empate é proibida; no lugar dela, marca-se o teste”. O resumo de uma frase (teste Feynman) “Empate de opinião não se desempata com voz mais alta; se desempata com um teste pequeno, combinado antes, que deixe a realidade dar o voto de minerva.” Fontes e leituras recomendadas RIES, Eric. A Startup Enxuta. Sextante, 2019. KOHAVI, Ron; TANG, Diane; XU, Ya. Trustworthy Online Controlled Experiments: A Practical Guide to A/B Testing. Cambridge University Press, 2020. THOMKE, Stefan. Experimentation Works: The Surprising Power of Business Experiments. Harvard Business Review Press, 2020. ELLIS, Sean; BROWN, Morgan. Hacking Growth. HarperCollins, 2017. (Origem prática do ICE score.) KOHAVI, Ron; CROOK, Thomas; LONGBOTHAM, Roger. “Online Experimentation at Microsoft”. Third Workshop on Data Mining Case Studies, 2009. (Fonte do dado “um terço melhora, um terço não muda, um terço piora”.)