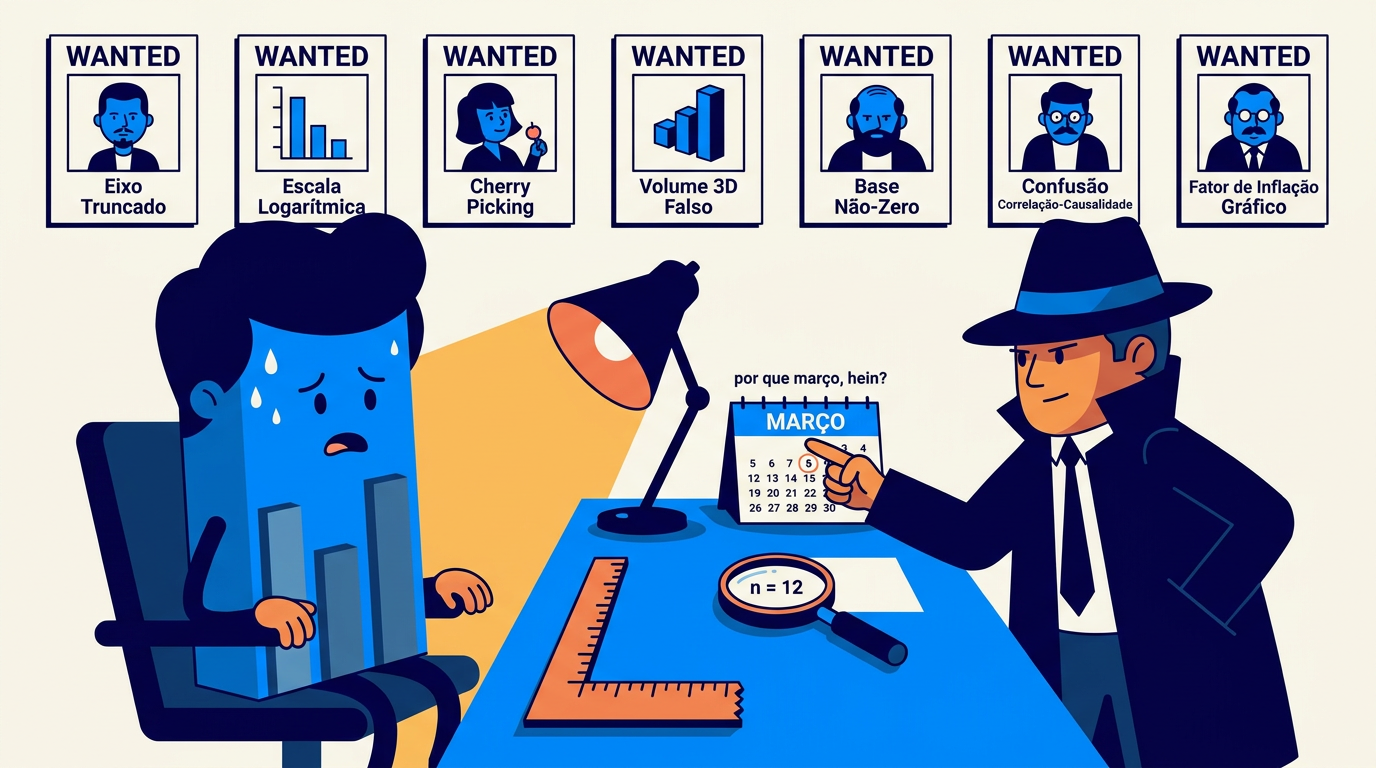
Um gráfico enganoso pode estar 100% correto nos números e ainda assim mentir com a imagem. Aprenda a revistar os dois. Nas Lojas Andorinha O fornecedor de sistemas de fila chegou às Lojas Andorinha, rede de moda com trinta lojas, com uma proposta cara e um gráfico irresistível: a “explosão de conversão” de um cliente após adotar a solução, uma linha subindo como foguete. Metade da sala já fazia contas de instalação. Igor, gerente da loja do Centro, pediu licença, papel e régua. Refez o gráfico à mão, com o eixo começando no zero. O foguete pousou: a subida era de 4,31 para 4,42 em oito meses, um décimo honesto esticado por um eixo que começava em 4,25 e por uma janela que, por coincidência, abria exatamente no pior mês do cliente. — O número de vocês pode até ser bom — disse ele, virando o papel para o vendedor. — Mas o desenho está fazendo hora extra. O gráfico enganoso: a mentira que não precisa de números falsos O artigo Data storytelling ensinou a construir gráficos honestos. Este é o espelho: como ler os gráficos dos outros (relatórios de fornecedores, benchmarks de mercado, posts virais, propostas) com colete à prova de retórica visual. A premissa desconfortável: a maioria dos gráficos enganosos usa dados verdadeiros. A distorção mora nas escolhas visuais: eixo, escala, área, recorte, cor. Edward Tufte deu nome ao fenômeno nos anos 1980 e até propôs medi-lo (o “fator de mentira”: a razão entre o tamanho do efeito na imagem e o tamanho do efeito nos dados). Alberto Cairo, professor de visualização, escreveu o manual moderno do tema com um título que serve de lema: How Charts Lie. Eis as sete técnicas mais comuns, com o antídoto de cada uma. 1. O eixo Y truncado: o drama fabricado O clássico absoluto. A satisfação foi de 4,20 para 4,26, mas o eixo começa em 4,18, e a segunda barra fica quatro vezes tão alta quanto a primeira. Variação de 1,4% vira paredão visual. Antídoto: procure o zero do eixo (em gráficos de barra, ele é obrigatório: a barra codifica valor pela altura total). Em gráficos de linha, eixo cortado é aceitável para mostrar detalhe, desde que sinalizado. A pergunta-reflexo: “quanto isso mudou em números, mesmo?” E a régua do artigo Diferença real ou ruído?: essa mudança supera o ruído? Exemplo com dados fictícios. O aumento é de 0,06 ponto. Com a base em 4,18, a altura visível passa de 0,02 para 0,08: quatro vezes maior. 2. O duplo eixo: a correlação encomendada Duas linhas, duas escalas (uma à esquerda, outra à direita), calibradas para as curvas dançarem juntas. Com liberdade para escolher as duas escalas, quase qualquer par de séries “se acompanha”. É o gerador visual de correlações espúrias (o clássico das correlações espúrias, que “sincroniza” filmes de Nicolas Cage com afogamentos em piscinas, era exatamente isso). Antídoto: desconfie por padrão de eixos duplos; pergunte como ficaria cada série normalizada (variação %, base 100). Quem tem um caso sólido raramente precisa desse recurso. Exemplo com dados fictícios. À esquerda, as escalas fazem as curvas coincidir. À direita, a base comum revela aumentos de 6% e 60%; a coincidência visual não demonstra causalidade. 3. Área e volume: o exagero quadrático Para mostrar que B é o dobro de A, o designer desenha um círculo com o dobro do raio, que tem quatro vezes a área. Pictogramas que crescem em altura e largura, bolhas, moedas empilhadas em 3D: o olho lê área/volume, e a diferença real sai inflada ao quadrado (ou ao cubo). A defesa é lembrar que diferenças quantitativas se leem com segurança em comprimento (barras), não em área. Bolha bonita é para impressão geral; decisão pede barra. Exemplo com dados fictícios. Os dados dobram, mas a área do círculo quadruplica. As barras mostram a proporção correta. 4. O recorte temporal conveniente “Crescimento impressionante desde março!” E março foi o fundo do poço (escolhido a dedo). Toda série tem um ponto de partida que conta a história desejada; quem corta a janela escolhe a manchete. É a versão gráfica da regressão à média (Regressão à média) e da sazonalidade ignorada (Sazonalidade e séries temporais: comparar dezembro com janeiro em vez de dezembro com dezembro). Antídoto: peça a série mais longa (“como está contra o mesmo período do ano passado? e nos últimos 3 anos?”) e desconfie de janelas que começam em vales ou picos. Exemplo com dados fictícios. De março a junho, as vendas crescem 60%. Incluindo janeiro, o saldo até junho é uma queda de 20%. 5. O acumulado que nunca desce A escada rolante do artigo Métricas de vaidade em forma de gráfico: “total acumulado” sobe para sempre, mesmo com o negócio encolhendo. Primo dele: o gráfico de “crescimento do crescimento” (mostra a taxa, esconde que a taxa está caindo). Nos dois casos, peça a métrica por período, ou seja, novos por mês em vez de total desde a fundação. Se o apresentador resistir, você já sabe por quê. Exemplo com dados fictícios. O acumulado chega a 300 clientes, enquanto a aquisição mensal cai de 100 para 20. São os mesmos dados, respondendo a perguntas diferentes. 6. A escala e o mapa que distorcem Escalas logarítmicas apresentadas sem aviso (achatam explosões e dramatizam começos); mapas onde área geográfica vira proxy de importância (municípios enormes e vazios dominam a tela, o “problema do mapa eleitoral”); cores escolhidas para alarmar (vermelho para variação de 0,1). Antídoto: leia a legenda e a escala antes do desenho. São os 5 segundos mais rentáveis da leitura de qualquer gráfico. E lembre-se de que cor não é dado: é editorial. Exemplo com dados fictícios. Este exemplo ilustra a escolha da escala: distâncias iguais no eixo logarítmico representam multiplicações, não acréscimos iguais. A escala logarítmica é válida, mas precisa ser identificada. 7. O gráfico sem contexto de incerteza Barras comparando lojas com 30 respostas cada, sem margem de erro; linhas de “tendência” traçadas sobre 3 pontos; o ranking em que o 1º e o
Coincidências acontecem: a lei dos números muito grandes
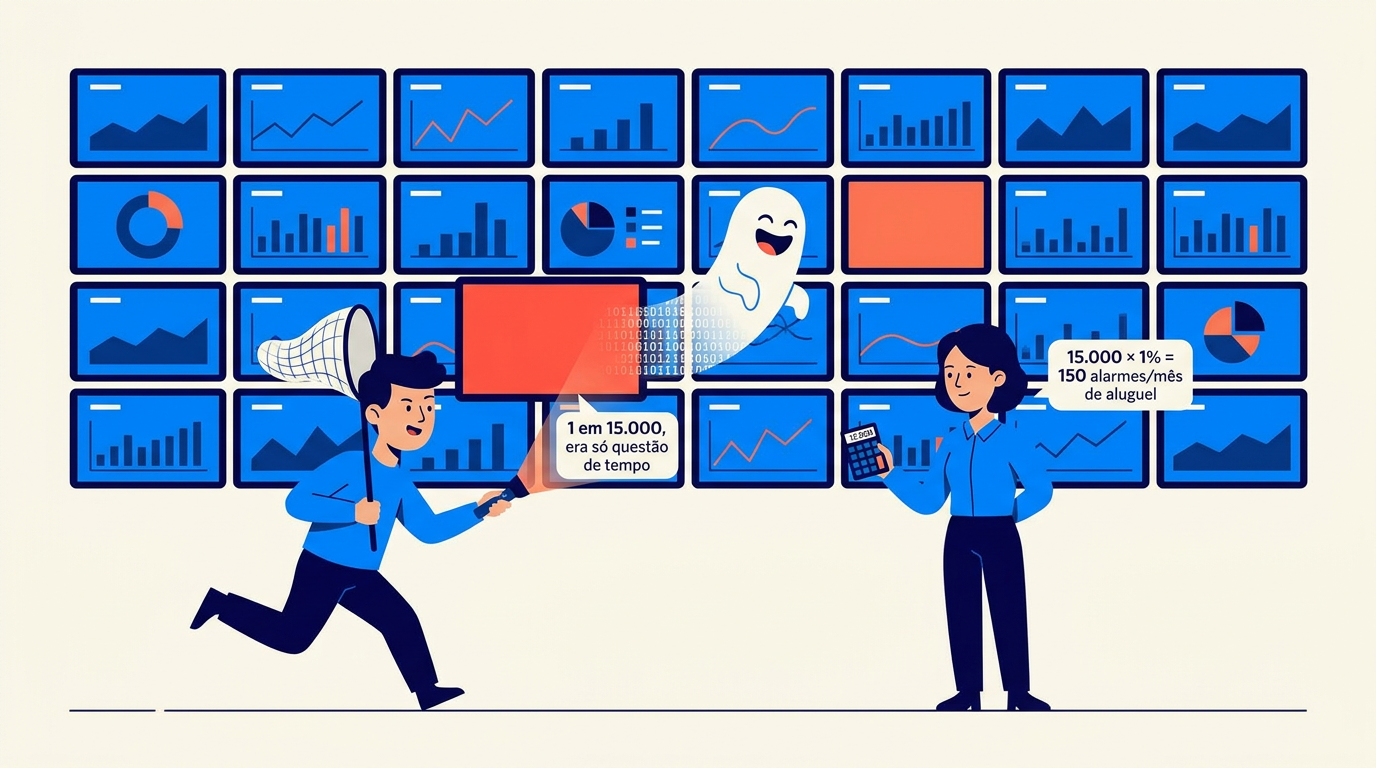
Com tentativas suficientes, o improvável vira rotina, e o cérebro humano vira caçador de fantasmas. É a lei dos números muito grandes em ação. No Supermercado Farol O painel novo do Supermercado Farol, rede com cinco lojas, cruzava tudo com tudo: nota por dia da semana, por clima, por horário, por seção, por loja. Foi lá que Caio, o gerente da loja principal, garimpou o achado que anunciou por e-mail com assunto em caixa alta: “DESCOBERTA: terças-feiras de chuva têm nota 0,4 acima da média!”. Já havia até esboço de plano: promoção de dia de chuva, para surfar o fenômeno. A analista da rede respondeu com uma conta em vez de uma opinião. Entre cortes e combinações, o painel oferecia alguns milhares de cruzamentos possíveis. Em milhares de tentativas, o acaso não é um risco: é uma fábrica. Alguma “terça chuvosa” sempre aparece, como num caça-níquel de alavanca puxada o dia inteiro: de vez em quando três limões se alinham, e ninguém chama de milagre. O milagre estatisticamente obrigatório: a lei dos números muito grandes Qual a chance de alguém ganhar na loteria duas vezes? Praticamente nula, para você. Mas para alguém, em algum lugar, algum dia? Quase certa. Milhões de pessoas jogando, semana após semana, ano após ano: em algum ponto, o “milagre” é aritmeticamente inevitável, e sempre vira notícia, porque noticiamos o ganhador, nunca os milhões de não ganhadores ao lado dele. Os estatísticos Persi Diaconis e Frederick Mosteller, num artigo clássico sobre o estudo de coincidências, formularam a lei dos números verdadeiramente grandes: com uma amostra suficientemente grande, qualquer coisa escandalosa tende a acontecer. Sem magia, sem conspiração: só multiplicação. A consequência para quem trabalha com dados é direta: uma empresa que monitora muitas métricas, em muitas lojas, todos os dias, está rodando milhões de “tentativas”, e vai testemunhar “milagres” estatísticos toda semana. Saber disso muda a leitura de metade dos alarmes. O cérebro odeia o acaso (e inventa histórias) O acaso verdadeiro é desconfortável de olhar. O cérebro humano, uma máquina de padrões, prefere qualquer história a nenhuma: A falácia do apostador. Deu “cara” cinco vezes seguidas; agora “tem que” dar coroa. Não tem: a moeda não tem memória, e a probabilidade segue 50%. No trabalho, o mesmo raciocínio veste terno: “tivemos três meses ruins, estatisticamente agora melhora” (não existe “estatisticamente” nessa frase; existe esperança) ou “essa loja já deu problema demais este ano, a cota dela acabou”. O acaso não distribui cotas. Sequências aleatórias parecem intencionais. Pergunte a alguém para “inventar” 50 lançamentos de moeda: a pessoa alterna demais, evitando sequências longas, porque CCCCC “não parece aleatório”. O acaso real é cheio de rajadas: em 100 lançamentos honestos, uma sequência de 6+ caras seguidas é mais provável que não. Tradução: cinco avaliações negativas em sequência no mesmo turno podem ser perfeitamente compatíveis com uma operação estável (as “8 respostas de segunda-feira” do artigo Amostra, vistas pela lente da probabilidade). Uma rajada dessas merece verificação, mas só a persistência confirma alguma coisa (Diferença real ou ruído?). A mão quente. O estudo famoso de Gilovich, Vallone e Tversky (1985) analisou arremessos no basquete e concluiu que a “mão quente” (o jogador “embalado” que “não erra mais”) era em grande parte ilusão de percepção sobre sequências aleatórias. (Honestidade científica: análises modernas, como a de Miller e Sanjurjo em 2018, mostraram um erro sutil no método original; algum efeito real de mão quente parece existir, menor do que a crença popular. A lição dupla é ainda melhor: o instinto humano superestima padrões em rajadas, e até cientistas revisam conclusões diante de método melhor.) Onde isso morde: o alarme que se pesca sozinho Junte a lei dos números muito grandes com o hábito de olhar dashboards fatiados (pegadinha 4 do artigo Diferença real ou ruído?) e nasce o monstro doméstico: Uma rede com 50 lojas × 10 métricas × 30 dias = 15.000 números por mês. Se cada número tem 1% de chance de parecer “anômalo” por puro acaso, são ~150 anomalias mensais fabricadas pelo nada. Quem sai caçando explicação para cada uma vai encontrar: o cérebro fornece a história com prazer (a obra na rua! o gerente novo! a chuva!), e a empresa passa a gerenciar fantasmas, exatamente o “tampering” contra o qual Deming alertava (Sazonalidade e séries temporais). As defesas já estão espalhadas pela série; aqui, reunidas: Espere X falsos alarmes por mês: literalmente calcule o X. Se o painel monitora N números com limiar de “5% de estranheza”, N × 5% alarmes mensais são o aluguel estatístico do painel. Só o excedente merece investigação. Rajada vira hipótese; repetição vira caso. Anomalia detectada na pescaria só é promovida a fato se persistir em dados novos (veja Achismo, opinião e evidência e Diferença real ou ruído?). O acaso não sustenta performances longas. Pergunte “quantas tentativas houve?” antes de se impressionar com qualquer coincidência: do cliente que reclamou duas vezes no mesmo dia (“quantos clientes temos?”) à métrica que “sempre cai na sexta” (“em quantas sextas olhamos?”). Cuidado redobrado com o que foi encontrado versus o que foi previsto. A previsão registrada antes (“apostamos que o turno da noite cairá”) que se confirma vale muito; o padrão achado depois, vasculhando, vale pouco até segunda ordem; é a ficha de experimento (Experimentos internos) protegendo contra o atirador que desenha o alvo em volta do tiro. O outro lado: não vire cético de pedra A lição não é ignorar padrões, e sim precificar o acaso antes de comprar a história. Rajadas reais existem: o freezer que quebrou gera mesmo cinco reclamações seguidas; o funcionário novo gera mesmo uma sexta-feira ruim. A diferença entre o fantasma e o fato não está na cara do padrão (rajadas aleatórias e causais são idênticas de perto); está no teste: causa real deixa outras digitais (o comentário aberto citando o freezer; veja Quali e quanti) e persiste ou se repete sob observação. Fantasma evapora na amostra seguinte. De volta ao Farol No Farol, a descoberta das terças chuvosas recebeu o tratamento que o acaso merece: virou
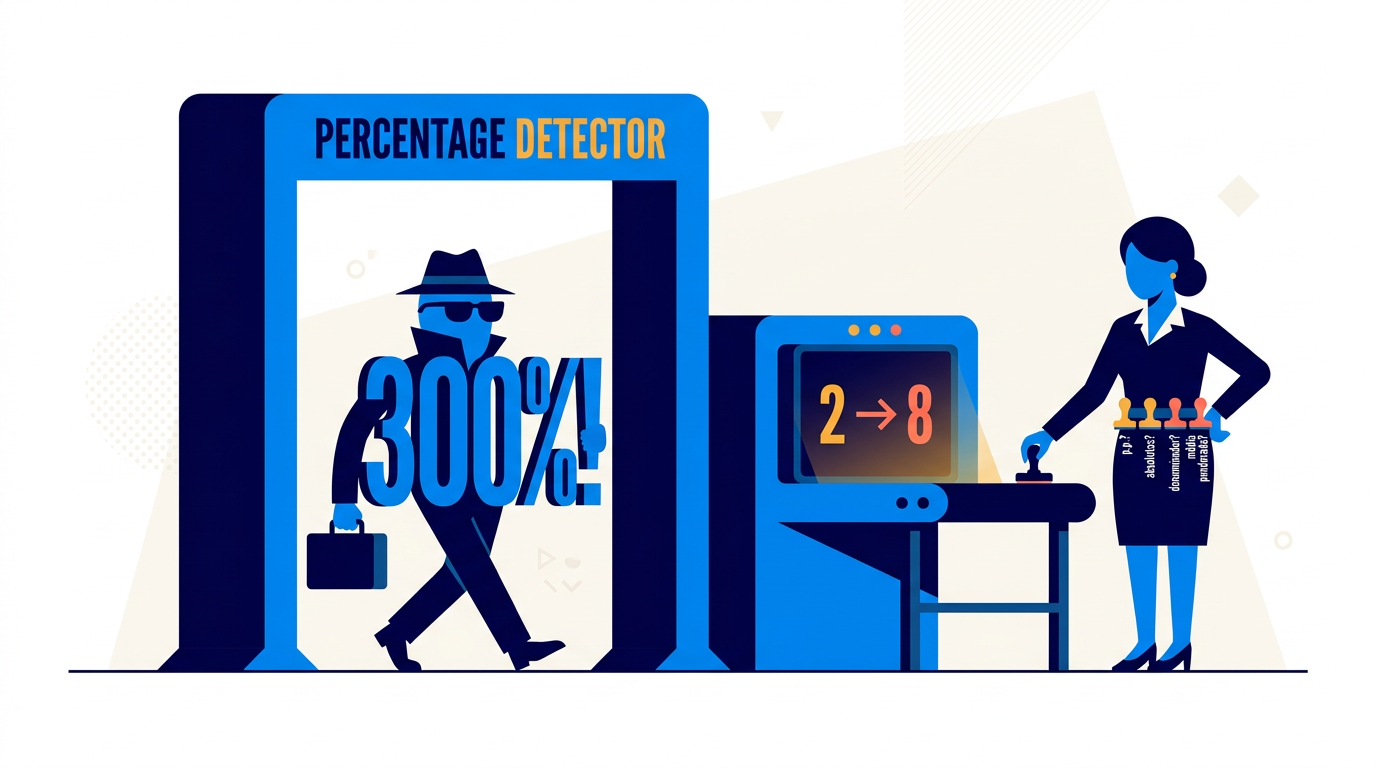
Porcentagem, ponto percentual e o crescimento de 300%
A aritmética mais simples do escritório é a que mais engana, quase sempre sem má intenção. E tudo começa na diferença entre porcentagem e ponto percentual. No Supermercado Farol Foi um dia de duas festas no Supermercado Farol, rede com cinco lojas. De manhã, o marketing comemorou em post interno: “cadastros no clube de fidelidade cresceram 300%!”. À tarde, a operação anunciou na reunião: “reclamações do açougue caíram 50%!”. Dona Ivone, a fundadora, aplaudiu as duas e, por via das dúvidas, pediu os números por trás dos por cento. As festas murcharam juntas. Os cadastros tinham ido de 12 para 48, num universo de nove mil clientes por semana: o 300% era verdadeiro e, por enquanto, irrelevante. As reclamações tinham caído de 2 para 1, na semana de feriado em que o movimento inteiro caíra junto. Ivone devolveu os dois slides com a mesma anotação na margem, a lápis: “por cento de quê? e quanto é isso em gente?” O quiz de um minuto Três afirmações, todas tecnicamente verdadeiras, todas potencialmente enganosas: “Nossa taxa de resposta subiu 10%.” “As reclamações cresceram 300%!” “A ação caiu 50% e depois subiu 50%: voltamos ao ponto de partida.” A terceira é falsa na conclusão (caiu de 100 para 50; subiu 50% de 50 = 75; faltam 25%). A segunda pode descrever “de 1 para 4 reclamações”. E a primeira é ambígua a ponto de significar duas coisas com um abismo entre elas. Porcentagem é a língua franca dos negócios, e um campo minado aritmético. Este artigo desarma as cinco minas mais pisadas e, no fim, mostra que todas elas já estavam catalogadas em 1954. Mina 1: por cento × ponto percentual A taxa de resposta era 40% e foi para 44%. Ela subiu: 4 pontos percentuais (a diferença absoluta: 44 − 40), e 10 por cento (a variação relativa: 4 é 10% de 40). As duas frases descrevem o mesmo fato, mas “subiu 10%” sugere, para metade da sala, que a taxa foi de 40% para 50%. Em métricas que já são porcentagens (taxa de resposta, % de detratores, participação), a confusão é sistemática e às vezes conveniente: “reduzimos a insatisfação em 20%!” soa melhor que “de 10% para 8%”. Regra da casa: variações de métricas percentuais se reportam sempre em pontos percentuais (abreviado p.p.): “subiu 4 p.p., de 40% para 44%”. O NPS, que já é uma subtração de porcentagens (NPS sem mistério), idem: “o NPS subiu 6 pontos”, nunca “6%”. Mina 2: o crescimento espetacular sobre base minúscula “Reclamações sobre o app cresceram 300%.” Pânico? Depende: eram 2, viraram 8. Num universo de 5.000 respostas, isso é estatisticamente invisível (veja Amostra e Diferença real ou ruído?), mas a manchete de 300% viaja pela empresa causando reuniões. Variação relativa amplifica bases pequenas: qualquer coisa rara que dobre “cresceu 100%”. O inverso também engana: um problema gigante que melhora pouco gera porcentagem tímida (“as filas caíram 3%” pode ser a melhor notícia do ano em volume absoluto de clientes beneficiados). Regra da casa: porcentagem de variação nunca viaja sozinha: sempre com os valores absolutos ao lado, como em “de 2 para 8 casos (+300%)”. A dupla desarma tanto o pânico quanto o triunfalismo indevidos. E antes de reagir a qualquer variação percentual, a pergunta do artigo Amostra: quantos casos são? Parênteses para a vida: esse é o recurso preferido dos jornalistas, em manchetes para impressionar a audiência (“casos de X triplicam!”) sem dizer que eram dois e viraram seis. Tome cuidado: a pergunta “quantos casos são?” vale para o jornal da manhã tanto quanto para o slide da tarde. Mina 3: subiu e desceu não se cancelam Quedas e altas percentuais são assimétricas: cair 50% exige subir 100% para voltar. Uma nota que cai 20% e sobe 20% termina 4% abaixo do início. Parece pedantismo até aparecer em decisão real: “perdemos 30% das respostas na mudança do fluxo, mas já recuperamos 30%” significa que ainda faltam 9%, e o slide de “recuperação completa” está errado. Por isso, em voltas e comparações multiperíodo, a regra da casa é comparar níveis (“estávamos em X, estamos em Y”) em vez de empilhar variações. Mina 4: porcentagem de quê? (o denominador escondido) Toda porcentagem é uma fração usando chapéu de número, e quem escolhe o denominador escolhe a história: “80% dos que responderam” ≠ “80% dos clientes” (a diferença é a taxa de resposta e seu viés; veja Amostra e O momento da verdade). “% de reclamações sobre atendimento entre as reclamações” pode subir porque o atendimento piorou ou porque as outras categorias melhoraram. Proporção interna muda sem que nada mude no numerador: é matemática de fatia de pizza: uma fatia cresce quando outra encolhe. “Satisfação de 92% entre clientes ativos” pode melhorar simplesmente porque os insatisfeitos foram embora: o denominador foi purificado pela evasão (viés de sobrevivência, na sua forma mais elegante). Regra da casa: diante de qualquer porcentagem, pergunte em voz alta: “por cento de quê, exatamente?”, e se o denominador pode ter mudado junto. É a pergunta irmã do “número solto é achismo com dígitos” (veja Achismo, opinião e evidência). Parênteses para a vida: essa é uma das formas de distorcer fatos nas pesquisas eleitorais. O mesmo candidato pode ter “40% dos votos válidos” e “31% do total de entrevistados”; a diferença são os brancos, nulos e indecisos que saíram do denominador. Os dois números são verdadeiros, e a campanha escolhe o que lhe convém. Tome cuidado. Mina 5: porcentagens não se somam nem se tiram média (quase nunca) Duas armadilhas de planilha: Média de porcentagens sem peso: a loja A tem 90% de satisfação com 1.000 respostas; a B, 50% com 10 respostas. “Média da rede: 70%”? Não: a média correta, ponderada pelo volume, é ~89,6%. Tirar média simples de taxas com bases diferentes dá voz de gigante a amostras anãs (e é primo do paradoxo de Simpson, explicado em Média mente). Somar porcentagens de perguntas multi-resposta: nas caixas de seleção (O cardápio de perguntas), as opções somam mais de 100%: cada
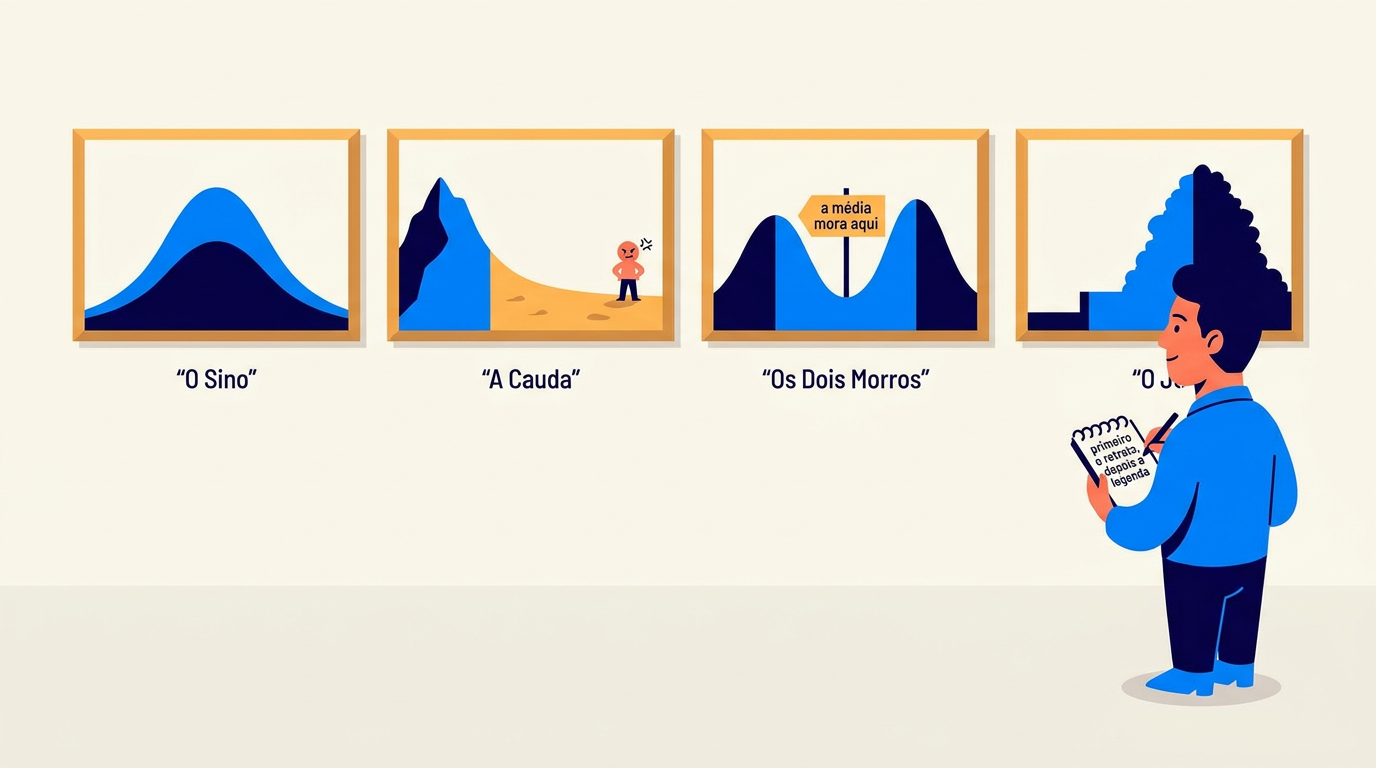
O formato dos dados: nem tudo é um sino
Antes de calcular qualquer coisa, pergunte que forma os dados têm: o resumo certo depende do desenho, e é o histograma de dados que o revela. No Hotel Cambará A média do mês do Hotel Cambará veio redonda: 4,6. Slide pronto, mês dado como bom. Mari Ferreira, consultora da Solvis, pediu uma coisa antes de arquivarem: o desenho. Não a média: o histograma, as notas empilhadas por valor. O desenho contou outra história. A pilha encostava no teto do 5, escorria pelo 4, e lá embaixo, quase discreta, uma cauda de notas 1 e 2: 6% das estadias, concentradas, quando abriram os cortes, nos check-ins depois das 22h e nos quartos do anexo antigo. A média 4,6 engolia aquela cauda sem soluçar: matematicamente correta, humanamente cega para os oitenta hóspedes do mês que tinham dormido mal. E hóspede que dorme mal escreve avaliação pública. — O seu mês não foi “4,6” — disse Mari. — Foi ótimo para muitos e péssimo para alguns. São duas gestões diferentes. O histograma de dados: o retrato antes da legenda Um histograma (a contagem de quantos casos caem em cada faixa) é o retrato de uma métrica. Média, mediana e desvio padrão são legendas desse retrato. E legenda sem retrato engana: o quarteto de Anscombe (Média mente) provou que resumos idênticos podem descrever desenhos opostos. Este artigo é um álbum dos quatro retratos que mais aparecem na análise de dados de satisfação, e do que cada um exige de quem o lê. Retrato 1: o sino (distribuição normal) O formato célebre: simétrico, amontoado no centro, raro nas pontas. Aparece quando o valor resulta de muitos fatores pequenos e independentes se somando: alturas de pessoas, erros de medição, médias de amostras grandes. É o lar da regra 68/95 (Desvio padrão sem dor) e o pressuposto silencioso de muitas ferramentas estatísticas. O erro cultural é achar que ele é o padrão do mundo. Não é. No dia a dia dos negócios, o sino é minoria e assumi-lo onde não existe produz as leituras erradas dos próximos três retratos. Retrato 2: a cauda longa (assimetria) Tempos de espera, tíquete de compra, tempo de resolução de chamado: quase todos os valores são modestos, mas uma minoria se estica numa cauda longa para a direita. Não há tempo de espera negativo, mas há o dia em que o sistema caiu e a fila levou 50 minutos. Consequências práticas: Média > mediana, em geral. A cauda puxa a média para cima do caso típico (o bilionário no bar, do artigo Média mente). “Tempo médio de espera: 9 minutos” pode conviver com “metade dos clientes espera menos de 5”. A ferramenta certa são os percentis. O valor abaixo do qual fica X% dos casos: a mediana é o p50; o p90 diz “90% dos clientes esperam menos que isto”. A engenharia de software gerencia latência de sistemas assim há décadas reportando p90/p95/p99 em vez de médias, precisamente porque a experiência ruim mora na cauda. Para operações de fila e atendimento, vale a mesma lente: a média mede o custo; o p90 mede a raiva. Metas honestas falam de percentil. “Atender em até 10 minutos em 90% dos casos” é uma promessa gerenciável e medível; “tempo médio de 8 minutos” pode ser cumprida enquanto um cliente por hora vive um desastre. Retrato 3: os dois morros (bimodal) Duas corcovas no histograma = duas populações misturadas vivendo experiências distintas: o almoço executivo e o jantar de sábado; o cliente novo e o habitual; o caixa humano e o autoatendimento. A média de uma bimodal cai no vale entre os morros, exatamente onde quase ninguém está. É o retrato mais traiçoeiro para resumos: qualquer número único descreve um cliente que não existe. A leitura certa não é resumir melhor; é separar as populações (segmentar; veja Média mente e Sazonalidade e séries temporais) e tratar cada morro como a história que ele é. O desvio padrão inflado sem explicação (Desvio padrão sem dor) é frequentemente o primeiro sintoma de bimodalidade escondida. Retrato 4: o “J” das notas de satisfação O retrato mais frequente nos painéis de satisfação: notas de satisfação não formam sino: amontoam-se no topo da escala (muitos 5, alguns 4), com um segundo grupinho menor no fundo (os 1 dos episódios ruins) e pouca coisa no meio. A literatura de marketing documenta isso há décadas: distribuições de satisfação são tipicamente assimétricas com concentração no extremo positivo (o levantamento clássico de Peterson e Wilson, 1992, já apontava o padrão e suas causas, do viés de quem escolhe responder e do desejo de ser gentil). Consequências para quem lê dashboards: A média fica cega no teto. Se quase todos marcam 4 ou 5, a média comprime tudo entre 4,2 e 4,6: parece estabilidade, mas o efeito teto está escondendo o movimento. Onde a ação acontece é nas pontas: acompanhe as proporções (% de notas máximas e % de notas baixas) em vez da média espremida. (O NPS, com seus promotores e detratores, é precisamente essa leitura institucionalizada; veja NPS sem mistério.) O meio vazio não é falta de opinião. Nota 3 em escala com formato J é frequentemente um “quase-detrator” educado. Trate a faixa média como zona de investigação, não como “neutros satisfeitos”. Pequenas quedas na média podem ser grandes notícias. Numa distribuição empilhada no teto, a média só cai quando gente migra para o fundo: uma queda de 0,2 pode significar que os casos ruins dobraram. Abra sempre a distribuição (Média mente) antes de julgar a magnitude. O hábito que resume o artigo Diante de qualquer métrica nova, peça o histograma antes de qualquer resumo. Trinta segundos de olhar respondem: é sino (média e desvio funcionam)? Cauda longa (mediana e p90)? Dois morros (segmente antes de tudo)? Empilhado no teto (proporções nas pontas)? Só então escolha a legenda. Resumo estatístico é como embalagem: precisa caber no formato do conteúdo, e é o conteúdo que manda. De volta ao Cambará No Cambará, o fechamento mensal ganhou um morador novo ao lado da média: o