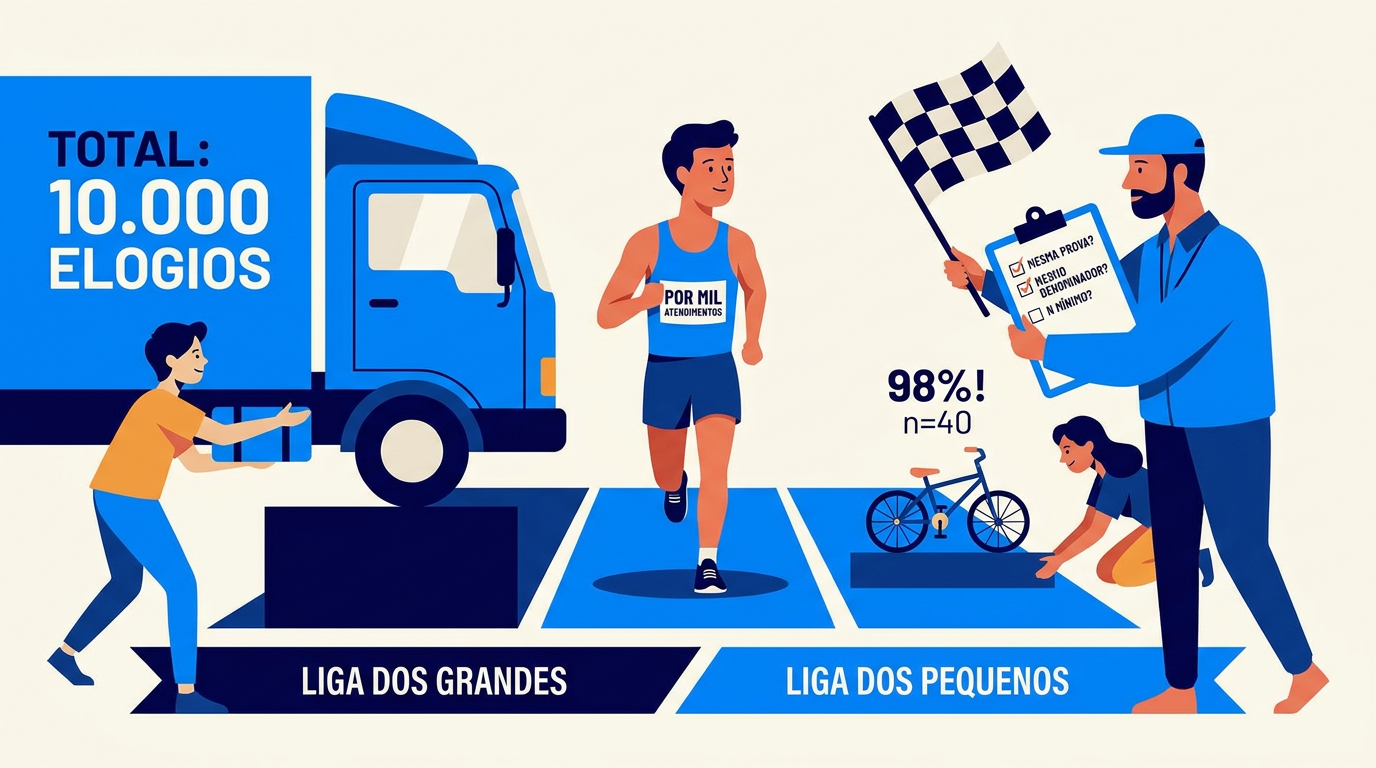
A loja gigante sempre “vence” em totais e a butique sempre “vence” em porcentagens: comparação justa começa escolhendo o denominador certo. É a base do benchmarking honesto. Nas Lojas Andorinha O ranking mensal das trinta lojas da rede Andorinha era impresso e colado na copa de cada uma. E todo mês contava a mesma história: a loja do Centro em último. A equipe já nem olhava o quadro; o líder de vendas tinha parado de mencionar o ranking, “para não desanimar mais ninguém”. Igor, o gerente, levou o incômodo para Sônia, a diretora de operações, com números em vez de queixa: a loja do Centro atendia o triplo de clientes das outras, quase tudo público de passagem, de rua, com pressa, o perfil que avalia mais duro em qualquer lugar do mundo. As lojinhas de bairro, pequenas e de clientela cativa, ocupavam o pódio todo mês. — O quadro compara notas — resumiu ele. — Mas ninguém ali está correndo a mesma prova. O campeonato viciado e o benchmarking honesto O ranking mensal da rede: a megaloja do shopping lidera em elogios recebidos (claro: recebe muito mais clientes), enquanto a lojinha de bairro lidera em % de notas máximas (claro: 40 clientes fiéis que conhecem a dona pelo nome). Cada uma “vence” na métrica que seu tamanho favorece, e o ranking premia geografia e metragem, não gestão. Comparar coisas de tamanhos diferentes é provavelmente a operação estatística mais comum da gestão, e uma das mais malfeitas. Este artigo reúne as regras da comparação justa. Regra 1: totais comparam tamanhos; taxas comparam desempenhos “São Paulo tem mais acidentes que Roraima” diz mais sobre população do que sobre trânsito. A correção universal é o per capita: dividir pelo denominador que neutraliza o tamanho. Reclamações por mil atendimentos, elogios por cem respostas, vendas por metro quadrado, respostas por totem por dia. A escolha do denominador é uma decisão de mérito, não de matemática: reclamações por cliente ou por transação? Vendas por loja ou por funcionário? Cada denominador responde uma pergunta diferente, e quem escolhe o denominador escolhe o vencedor (a mina 4 do artigo Porcentagem, ponto percentual e o crescimento de 300%, agora em versão ranking). O hábito da casa: denominador nomeado no título da métrica, sempre. Regra 2: taxa sem volume também engana (o retorno da base pequena) Corrigido o tamanho, nasce o vício oposto: a lojinha de 40 respostas com “98% de satisfação” no topo do ranking. Taxas de bases minúsculas balançam loucamente (veja Amostra e Diferença real ou ruído?): os primeiros e últimos lugares de qualquer ranking de taxa tendem a ser as unidades menores, pela pura matemática da variância (é o fenômeno que faz escolas pequenas dominarem simultaneamente os topos e os fundos dos rankings educacionais, um exemplo clássico da literatura estatística). Correções práticas, em ordem de sofisticação: exigir n mínimo para entrar no ranking; mostrar a taxa com margem de erro (barras de incerteza matam brigas de ranking na hora); ou agrupar unidades em ligas por porte e comparar dentro de cada liga. Regra 3: compare o comparável (ou ajuste pelo mix) Mesmo com taxas e n adequados, resta a pergunta: as unidades jogam o mesmo jogo? A loja de rodoviária atende viajantes apressados; a de bairro, vizinhos recorrentes. Público, horário, mix de produto e região mudam a nota sem que a gestão mude: é o paradoxo de Simpson (Média mente) e o mix de horário (Sazonalidade e séries temporais) na escala da rede. As defesas, da mais simples à mais trabalhosa: Ligas/clusters: comparar rodoviária com rodoviária, shopping com shopping. Comparar cada unidade consigo mesma: a evolução da loja contra a própria história (veja NPS sem mistério e Sazonalidade e séries temporais) é imune ao mix estrutural; por isso é a comparação padrão mais segura. Padronizar o recorte: comparar todas as lojas no mesmo tipo de hora (o almoço de A contra o almoço de B). E o teto de sofisticação, para conversas de benchmarking externo: ajustes por perfil, como os usados em comparações de hospitais e escolas (ninguém compara mortalidade de um hospital de trauma com uma clínica de check-up sem ajuste de risco). Se a saúde precisa disso para comparar hospitais, o varejo precisa da versão simples disso para comparar lojas. Regra 4: cuidado com o índice composto (a média de maçãs com parafusos) A tentação final do benchmarking: fundir tudo num “score geral”: 40% satisfação + 30% tempo de espera + 30% conversão = Índice da Loja. Índices compostos são úteis para comunicar (um número, um ranking), mas carregam três pegadinhas que quem os consome precisa conhecer: Os pesos são opinião vestida de matemática. Por que 40/30/30 e não 50/25/25? A escolha muda o campeão, e raramente é debatida com a seriedade de qualquer outra decisão editorial. Peso é hipótese: merece justificativa e revisão. O índice esconde os movimentos internos. O score fica estável enquanto satisfação despenca e conversão sobe, duas notícias enormes que se cancelam no agregado (a lição de Média mente, uma escala acima). Índice bom vem sempre com o “abre” dos componentes. Componentes em escalas diferentes precisam de normalização, e a normalização tem escolhas. Transformar minutos, notas e % numa régua comum (0–100, percentis, z-scores) envolve decisões técnicas que mudam resultados. Não é errado; é editorial, e deve estar documentado. Regra da casa para índices (próprios ou de mercado): antes de aceitar o ranking, pedir os componentes, os pesos e a justificativa dos pesos. Quem não fornece os três está pedindo fé em vez de oferecer análise. O checklist da comparação justa Diante de qualquer ranking, benchmark ou “loja X vs. loja Y”: É total ou taxa? Se total, o ranking mede tamanho. Qual o denominador, e ele é o mesmo para todos? Qual o n de cada unidade? Topos e fundos de ranking são território de base pequena. As unidades jogam o mesmo jogo? (mix, público, horário), ou estou comparando rodoviária com bairro? Se é índice composto: quais os componentes, os pesos, e quem os escolheu? E a alternativa que